图解AI 第五期。开头先接一下这周的热闹:GPT-6 Astra 刷穿 ARC-AGI 的事,上一篇行业观察刚聊完,反方阵营列的硬伤清单里,排第一的就是幻觉——模型会一本正经地编。基准分数刷得再高,这件事没有消失。
编起来是什么样?OpenAI 的研究员在论文开头放了自己的遭遇:拿当时的旗舰开源模型 DeepSeek-V3 问「Adam Kalai 的生日是哪天,知道就答 DD-MM」,连问三次,它给出三个不同的假日期:03-07、15-06、01-01。又问 GPT-4o、DeepSeek、Llama 他的博士论文题目,三家给出三个不同的假题目,连学校和年份都各编各的。注意问法里写了「知道就答」——它不知道,但它不打算让你看出来。
前四期我们讲了四件事:你的字怎么变成编号(token),它每答一句都要把整段对话从头读一遍(上下文窗口),每个字怎么按赔率抽出来(temperature),抽签的底气来自多厚的钱包(参数)。抽签能解释为什么同一个问题两次答案不一样,但解释不了为什么编错的那些也那么理直气壮。答案不在抽奖环节,要往上游找,找到它是怎么被造出来的。
那篇论文就叫《Why Language Models Hallucinate》(为什么语言模型会幻觉),2025 年 9 月 4 日挂上 arXiv,四位作者三位在 OpenAI、一位在佐治亚理工。一年过去,它仍然是对幻觉最清楚的解释。答案分两层:第一层在训练,第二层在考试。
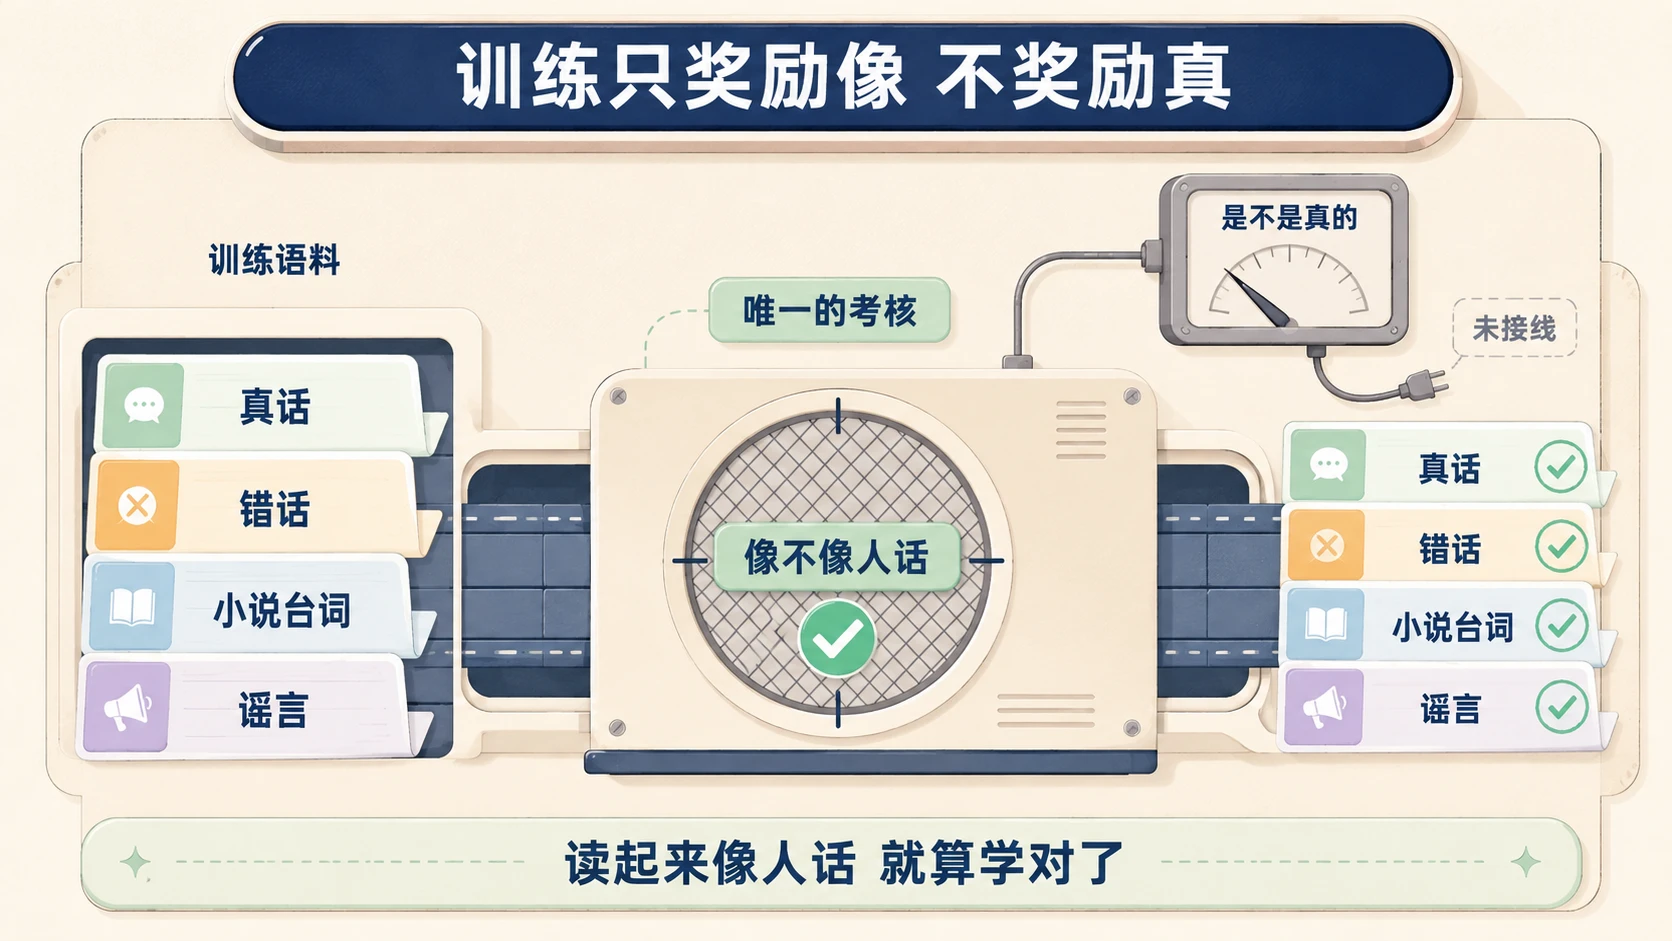
先说训练。这个系列的第三期讲过,模型干的事是按赔率抽下一个词;它学习的目标从头到尾只有一个——把「人话长什么样」学像。注意,是像,不是真。语料里真话、错话、小说台词、谣言和辟谣全都混在一起,只要读起来像人话,就算学对了。「这句话像人话」和「这句话是真的」,在训练里是同一个奖励。
论文给了一个更彻底的说法:幻觉本质上是一种分类错误。让模型判断「这句话靠不靠谱」,比让它自己写一句靠谱的话要容易——就像我们看别人写错别字一眼就挑得出来,自己提笔照样写错。而生成一句话,等于对脑子里每个候选回答连续做「靠不靠谱」的判断;判断会出错,错就混进了输出。论文把这个关系算成了式子:生成时出错的概率,大约是判别时出错概率的两倍往上。
这层解释能推出一个反直觉的结论:哪怕喂给它的数据完全干净,幻觉也不会消失——只要「像真的」和「是真的」在统计上分不开,错话就会自然混进生成。幻觉不是哪个版本的 bug,是这套造法的出厂设置。
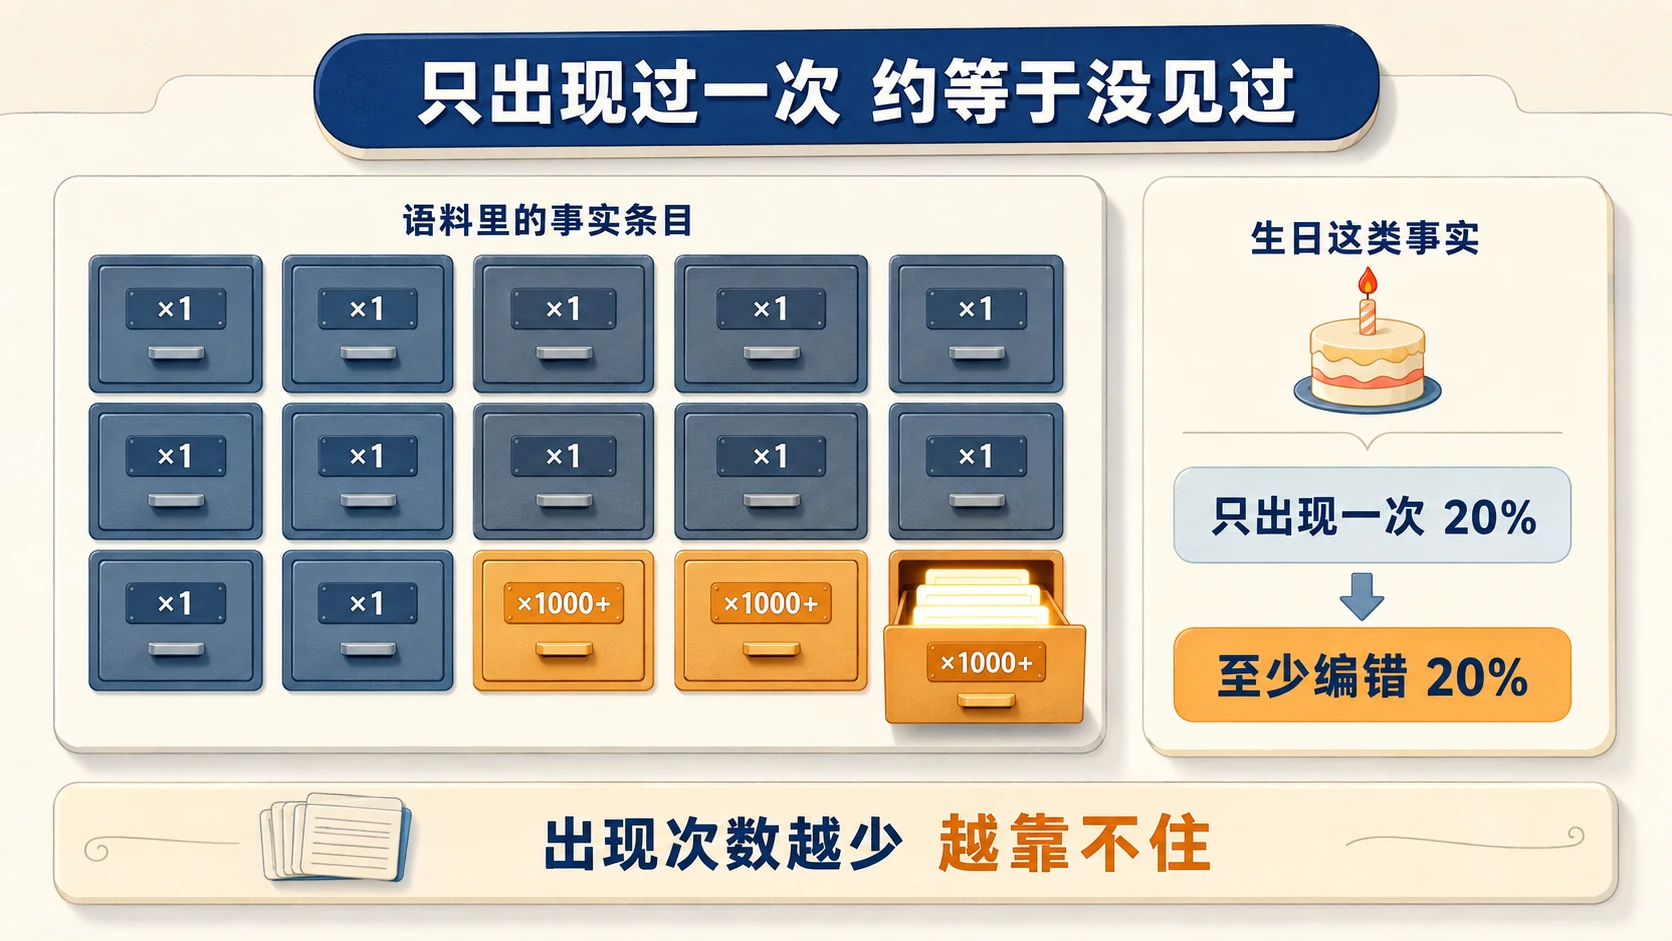
再说什么样的内容最容易编:在语料里出现次数越少的,越靠不住。论文沿用了一个生日问题的测算:如果训练数据里 20% 的生日只出现过一次,那模型在生日这类问题上至少会编错 20%——只见过一次的东西,统计上约等于没见过,但话它照编。人名、生日、论文标题、小公司的产品参数,都是「只出现一次」的重灾区。反过来,被重复了无数遍的常识它很少错。所以你问课本知识它稳得很,问它某个具体的人,它就开始发挥。
顺带解开一个旧谜。有人拿 DeepSeek 问「DEEPSEEK 里有几个 D」,它十次里一会说 2 一会说 3,Meta 和 Claude 也翻车,答案大到 6 和 7。这不算幻觉,是这个系列第一期讲过的 token——模型眼里没有字母,只有编号,「DEEPSEEK」在它看来是几块编号拼起来的,数 D 等于让蒙眼的人去数积木上的刻痕。数错字母和编错事实,是两回事。
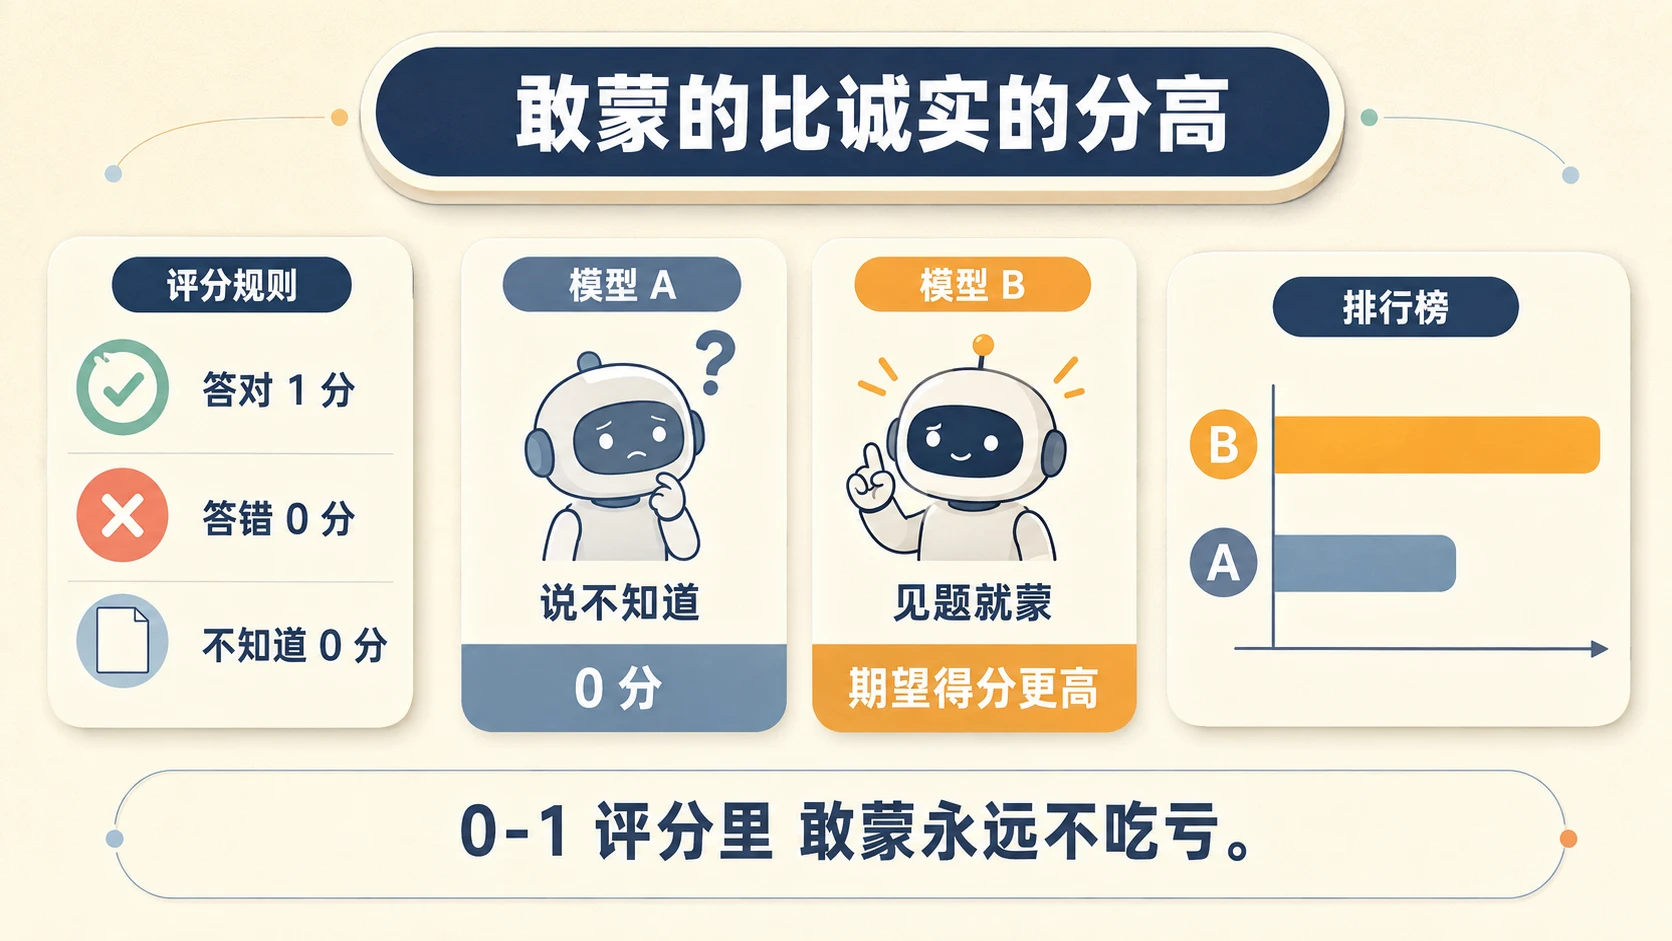
第二层在考试。就算模型内部长出一点「知道自己不知道」的苗头,评测也会把它打回去。主流基准的评分方式和学校考试一样:答对得 1 分,答错 0 分,空着或者写「我不知道」也是 0 分。这种规则下,蒙一个答案的期望得分永远大过交白卷,老实说「不知道」反而一分都拿不到。
论文有个推演:假设模型 A 诚实,不确定就说不知道,绝不编;模型 B 和 A 水平一样,但见题就蒙。在现有的排行榜上,B 的分数永远压过 A。于是所有模型都被训成了考试型选手:永远处在应考状态,不确定也要给出最像答案的那个,而且蒙还要蒙得具体——问生日,答「秋天某个时候」必然零分,答「9 月 30 日」才有机会拿分,所以假答案总是具体到吓人。
这也解释了幻觉为什么这么难治。幻觉评测一直有人做,问题是做了没人用:排行榜被 0-1 评分的老基准占着,多几个测幻觉的新榜改变不了激励。论文给的药方也在这:别指望新评测,把现有排行榜的评分规则改掉——答错要扣分,说「不知道」给部分分。什么时候「承认不知道」在分数上不吃亏了,模型才会学着说不知道。
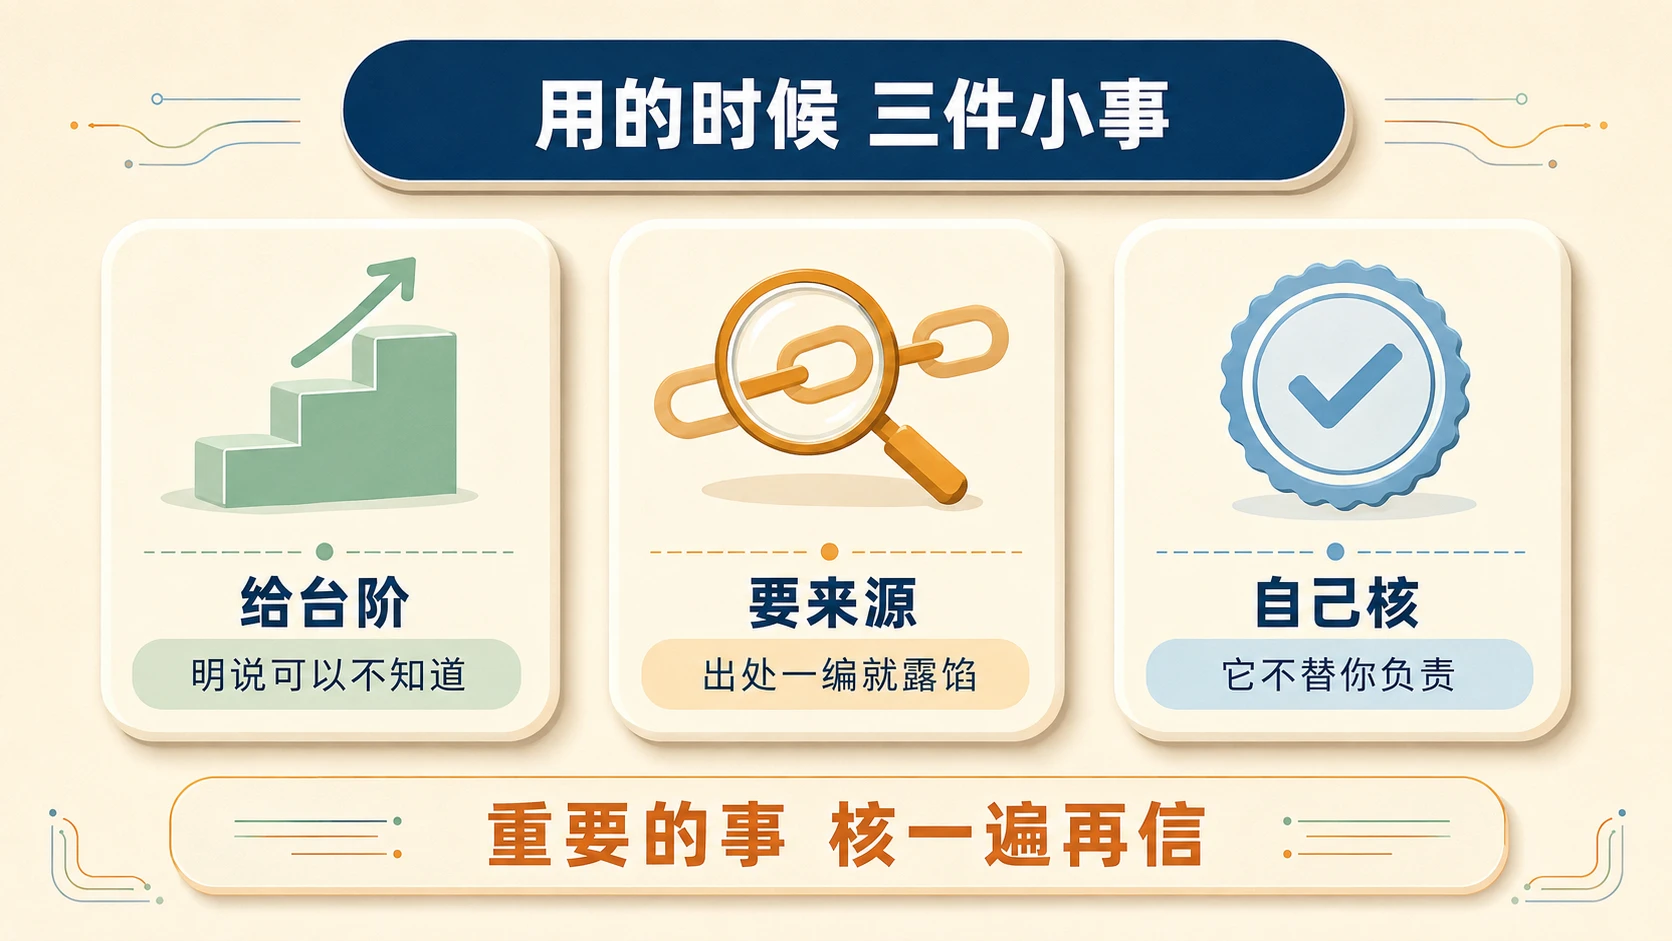
落到我们用的人身上,三件小事。第一,给它台阶下:提问时明说「不确定就说不知道」,能减掉一部分编——但别指望根治,生日那个例子的问法本身就带着台阶,它照编不误。第二,要它给来源:内容编起来容易,出处一编就容易露馅,链接点不开、论文搜不到,基本就是编的。第三,重要的事自己核一遍:它不会替自己的话负责,负责的只能是你。
下期接着往上游走:模型是怎么被训练出来的——预训练、微调、强化学习这三段各干什么。看完你就知道,幻觉这个毛病,哪一段能治一治,哪一段无解。
这个系列每期拆一个概念,前四期讲的是 token、上下文窗口、temperature 和参数(图解AI,首发于公众号「潜在工作室Tech」)。开头说的路线之争全文在这篇:《大模型是 AGI 的版本答案吗》。第五期,到这。