博客
文章
秋风五丈原:Kimi K3.1 与国产模型的这个十月
五周里 Claude 和 GPT 发了五款模型,国产只有 K3.1 Pro 一次冲锋。55 分没输,输掉的是节奏:一篇悲情复盘。
AI大模型AA周榜 2026-10-24
Kimi K3.1 Pro 空降总榜第 5,国产与榜首分差从 12 缩到 3;AA 榜单完成代际换血。附我们网关七天真实账本——包括这篇稿子用的 K3.1 Pro。
Kimi K3.1 Pro 发布:提升的大头在 Agent
K3.1 Pro 后训练加码带来 Agent 大涨分,API 降价但单任务成本基本没变;这篇发布解读本身就是用 K3.1 Pro 写的,读者可以直接判断成色。
公司没降本,你没轻松:这四年 AI 的收益被谁拿走了
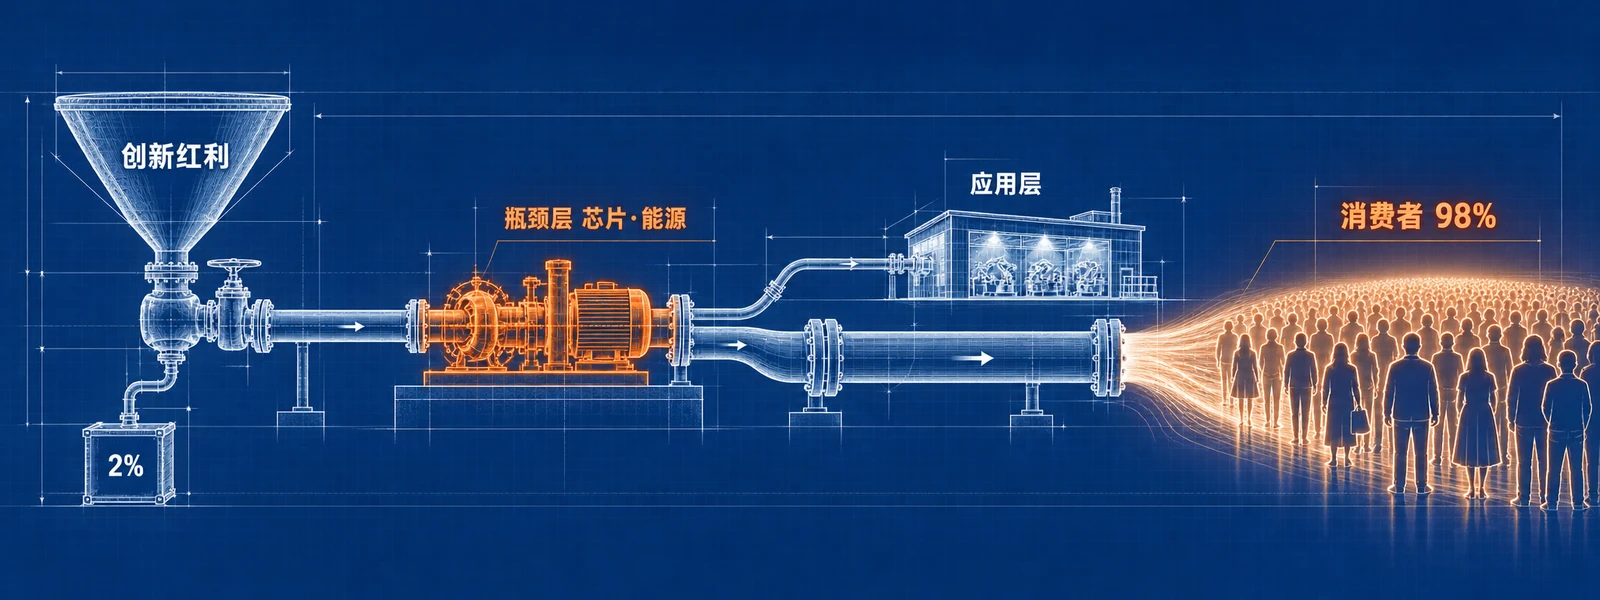
AI 爆发快四年,企业账上看不到降本,员工也没更轻松。用《超级趋势》的 J 形曲线和佩雷斯时滞拆三层:收益在统计里消失、在时滞里迟到、在分配里流向瓶颈层——再拿我们自己一周 17.5 亿 token 的账本做活样本。
国产模型「消失」的七周:Kimi K3.1 只闻其声
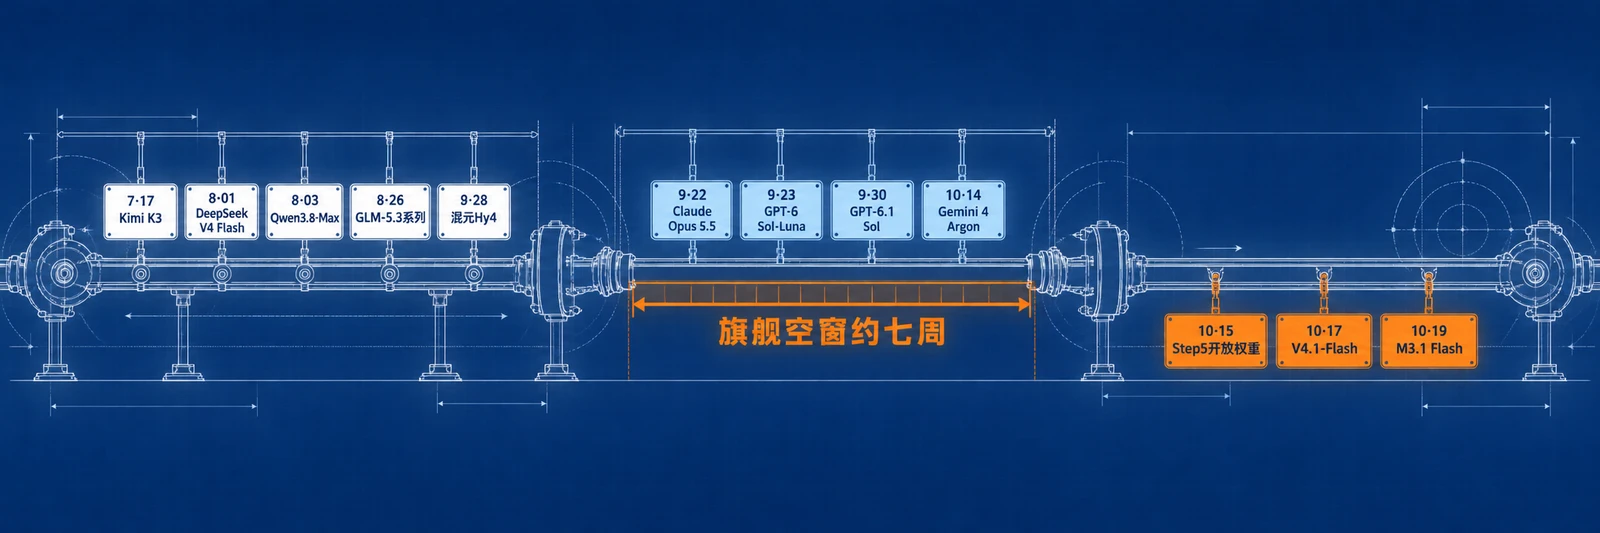
8 月 29 日到 10 月 15 日,国产旗舰级动作空窗约七周。但造势没停:K3.1 泄露未发、GLM 新一代只有暗示、MiniMax 先用匿名马甲霸榜再认领。AA 双快照对账:榜上的国产一款没掉队,退的不是位置,是节奏。
AI大模型AA周榜 2026-10-17
Meta Muse Wonder 空降总榜第 4,52+ 俱乐部扩到八家;国内阵营零分数变化被动后退。附我们网关七天的真实调用账本:用得最多的和分数最高的从来不是同一批。
Anthropic 不用 git 了:为人类设计的工具正在失效
日均合并四个月涨十二倍,git 的三个假设——离线可用、去中心化、人类频率——被 agent 集群击穿。Anthropic 七人五个月重造源码管理。为人类设计的工具正在成批失效。
magpie 实测:所有编程 Agent 的模型,一张表管完
本机开源网关 magpie:四种协议互转、一张表管所有 Agent 的模型配置、订阅变供应商、路由组互备、四个口径记账。我们跑了三十天的账,9397 次调用 155 次错误 35 次被重试接住。
Vals AI实测多智能体:token多烧五倍,分数没涨
Vals AI 在五十个真实软件项目上对比单智能体与团队:团队贵 1.8 到 5.1 倍,四组同档对比只有一组分数提升显著。多开几个 agent 到底多换来什么,这笔账可以算了。
Anthropic把「禁止虐待模型」写进了用户合同
新版 Claude 使用政策里首次出现「禁止持续且不必要的虐待模型」条款。从 2024 年的论文到 2025 年的结束对话功能再到合同条款,Anthropic 用两年走完了一条没人走过的路。
同一个模型,每个榜都说它第一
MMLU、Arena、Artificial Analysis、SuperCLUE,每家榜单的第一名都不一样。不是有人在撒谎,是四派测法量的本来就是四样东西。看懂口径,比记住名次有用。
AI大模型AA周榜 2026-10-10
Artificial Analysis 智能指数周榜首期:Anthropic 包揽前三,国产天花板 MiMo-V2.6-Pro 46 分排第 9,价格只有榜首的四十六分之一。
主力模型手感突变,Kimi在憋什么大招
Kimi K2 的额度突然变得耐用:同样的使用强度,周配额从周三见底变成周日还有余量。额度变化的背后通常是模型在换血——我们记录了三周的使用手感变化。
一个客户项目的 435 个测试:AI 编码怎么验收
一个匿名客户项目把学习规划能力拆成四张任务票:验收标准前置到测试和状态机里,截至 2026 年 9 月 26 日,仓库里已有 435 个测试函数。
作业分涨了 18%,中考分跌了 24%
一项覆盖四千五百名中学生三年的对照研究:用 AI 做作业的组平时成绩显著更高,撤掉 AI 后的考试成绩反而显著更低。生成式 AI 在学习里扮演的角色,更像代偿而非支架。
我们把思考外包给 AI 之后
卸载清单论:能外包给 AI 的认知环节越来越多,从查资料到起草到校对。真正的风险不在外包本身,在于外包之后大脑的那块肌肉还练不练。
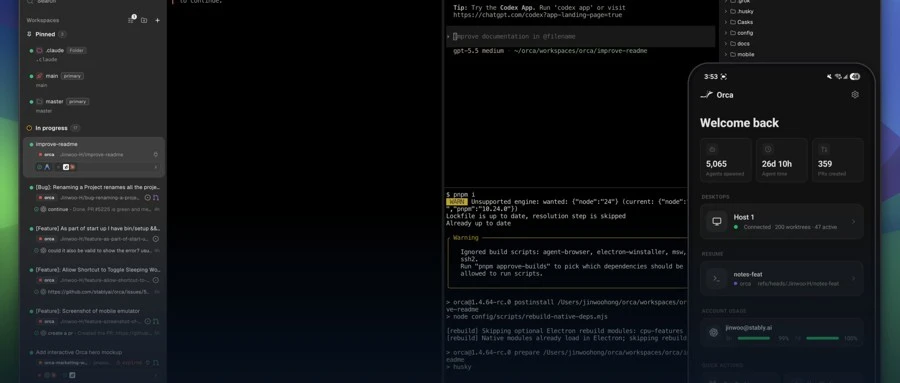
换了三个工具后,我们把 AI 编码的工作台留在了 Orca
从 Claude Code 到 Codex 再到自研编排,三个工具各解决一部分问题也各留一部分坑。最后留下的组合:终端工作台 Orca 加五条仓库宪法,多任务并行的进程切换负担终于降下来。
72小时三家连发折叠屏:最终形态可能不是"折叠"
72 小时内华为 Mate XT2、小米 18 Fold、iPhone Duo 三家连发,七年四种形态之后折叠屏开始收敛:阔折叠赢在外屏平权——日均展开 3.1 次的用户早把折叠机当直板机用,形态终于做对的标志,也许是它不再需要被打开。
AI 为什么一本正经地胡说八道
图解AI 第五期讲幻觉从哪来:OpenAI 的论文《Why Language Models Hallucinate》给了迄今最清楚的解释——训练只奖励「像」不奖励「真」,只出现一次的事实约等于没见过,0-1 评分又奖励敢蒙、惩罚说不知道。
大模型是 AGI 的版本答案吗
2026 年大模型路线之争双方论据摆齐:LeCun 的 AMI Labs 押注世界模型,GPT-6 Astra 刷穿 ARC-AGI;我们的答案是底座论——大模型是 AGI 的底座,不是答案本身。
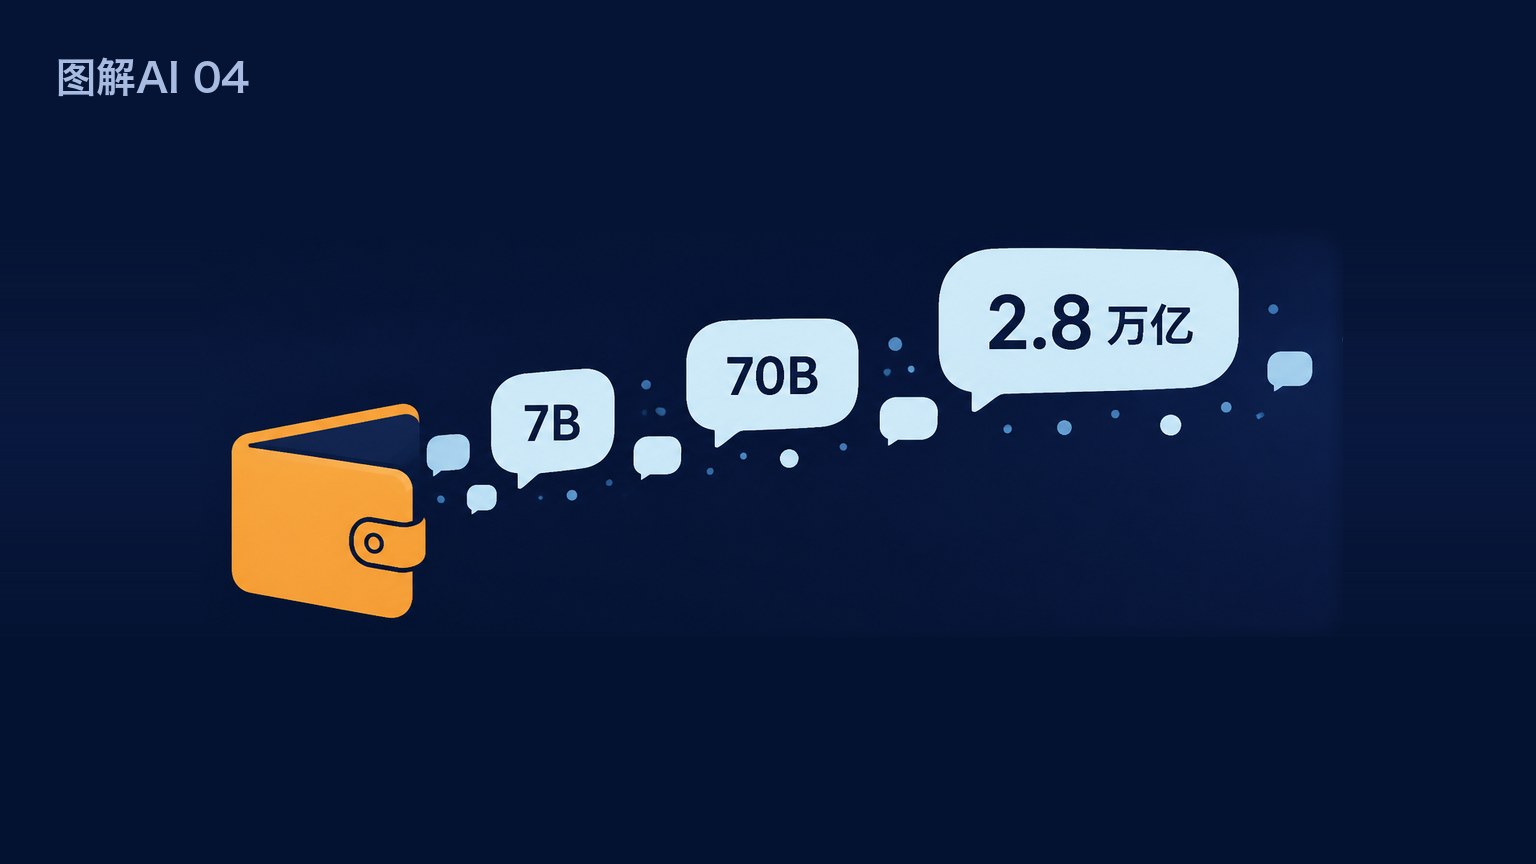
7B、70B、2万亿,数的是什么
发布会报的 7B、70B、2.8 万亿数的是同一个东西:参数。图解AI 第四期讲清参数是什么、为什么叫钱包、「770B 激活 49B」是什么意思,以及为什么万亿模型只占下载量的 3%。
Anthropic:代码不再是瓶颈,流程才是
Anthropic 应用 AI 团队的 AI 原生开发流程手册逐层拆解:代码不再是瓶颈,流程才是——六阶段各交一份文件进版本库,产物链就是审计轨迹,审批门装在工具链里,治理不再靠开会。
AI 编码是有门槛的
Matt Pocock 的观点全公开——bad codebases make bad agents;我们用自己的生产线和一次平台预警对照:门槛没消失,是从会写代码搬到了有系统,验收、教训写进文件,一件不能省。
小龙虾2.0发布:它先问了我一个问题
我们把 OpenClaw 2.0 装上一台 Mac 实测了一晚上:两分钟零命令行跑起来,25 秒跑完我们自己的运营工具,还顺手揪出两条我们没发现的数据问题。
坏代码的代价,史上最高
Matt Pocock 复盘 specs-to-code 为什么必输:失效模式各自的解药,全是二十年前的老书。
FDE 在中国水土不服,但内核可以拆出来用
硅谷用真金白银重新端上 FDE 老词,中文圈 4 个月里冒出 6 篇万字长文批“水土不服”——他们讲得都对,但他们没讲另一半。
古法程序员何去何从
AI 把写代码打到近乎免费,但质量账、就业账、断档账三笔一起变难看——软件开发岗位 69.3% 是高级岗、入门岗只剩 4.5%。
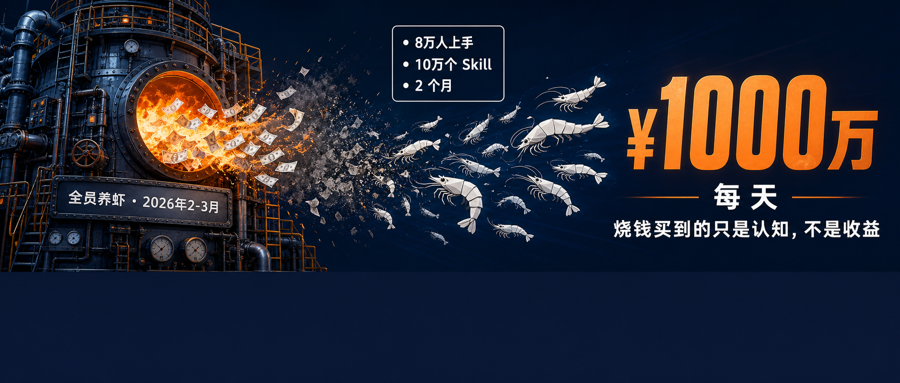
美团烧掉几亿买来的顺序:先数字化,再智能化
美团替全行业交了一笔 AI 学费:日烧千万、谬误流进真实经营,能收场靠的是跑了十几年的数字化流程。想上 AI,先数字化。
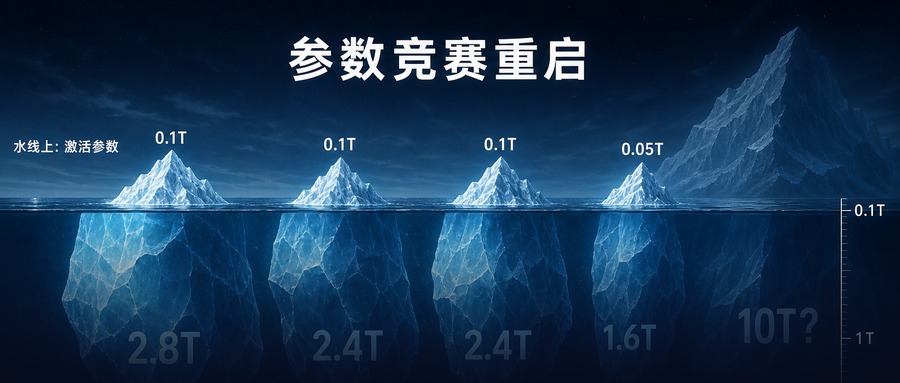
参数竞赛重启:各大模型的现状,和接下来值得等的东西
一个夏天凑齐“两万亿俱乐部”。把官宣和传闻分开数了一遍:K3 开源 2.78T、Qwen3.8 2.4T、Astra 还在延期。
我读了 DeepSeek Harness 的 505 份 AI 工作笔记,挑出最值钱的 6 个故事
DeepSeek Harness 源码里藏着 505 份 AI 工作笔记:空响应为什么要报错、30 个优化提案为何被集体否决、整个终端 UI 为何被删。
你好,我们是潜在工作室
潜在工作室的第一篇文章:我们给客户做定制开发,也做自己的软件产品。