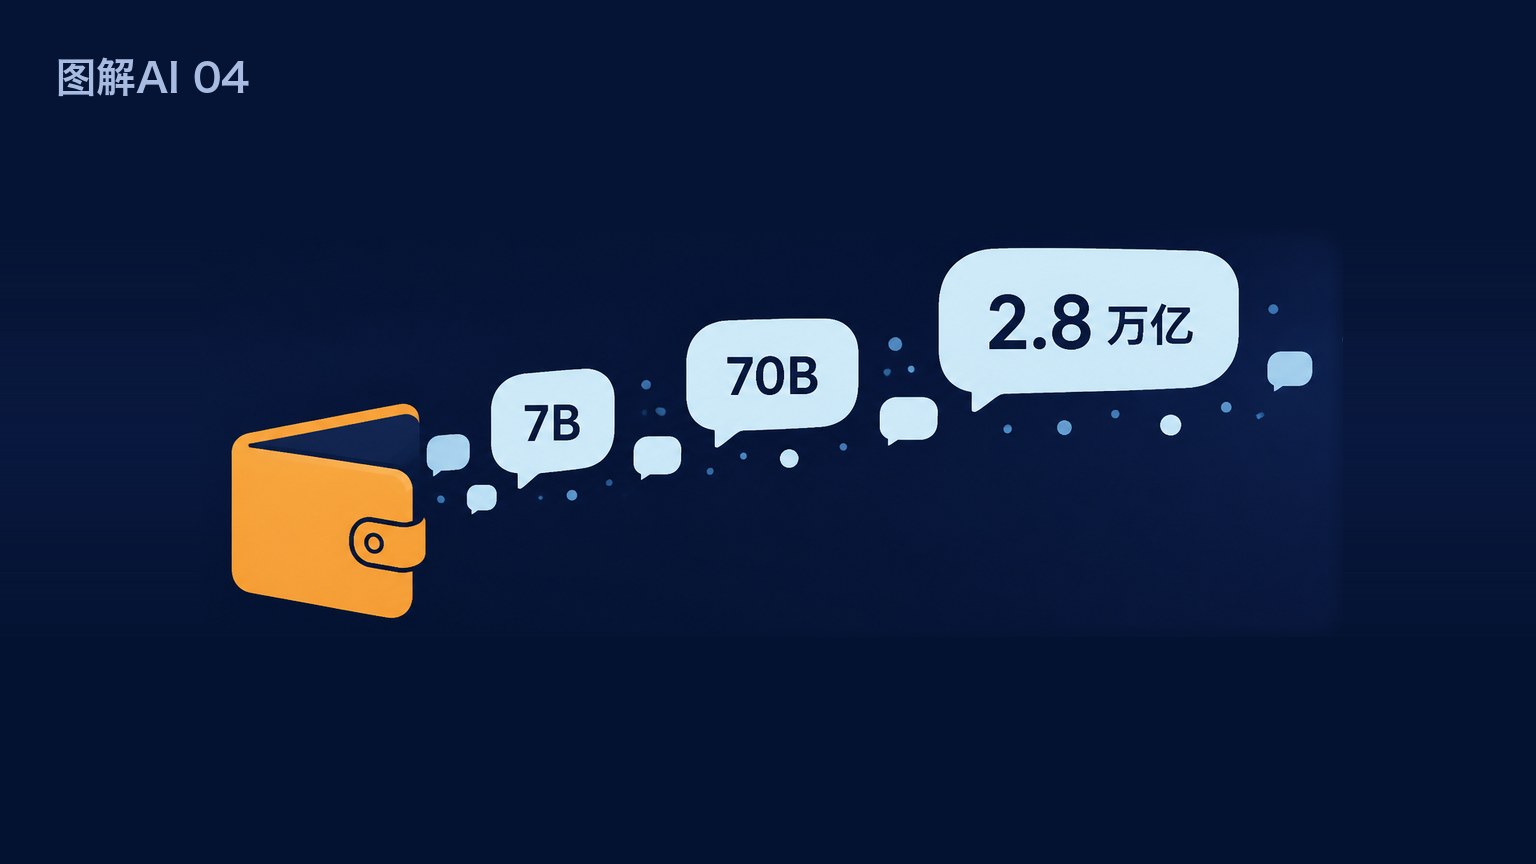
图解AI 第四期。前面三期讲了三件事:你的字怎么变成编号(token),它每答一句都要把整段对话从头读一遍(上下文窗口),每个字怎么按赔率抽出来(temperature)。这期讲地基的最后一块:参数。
先从这个月的发布会说起。过去 42 天国产大模型连发了 8 个,我们按时间线整理过一整期:Kimi K3 报 2.8 万亿,阿里 Qwen3.8-Max 报 2.4 万亿,腾讯混元 Hy4 报 770B,后面还跟了一行小字——激活 49B。一个模型,两个数。这些发布会报来报去,数的是同一个东西:参数。
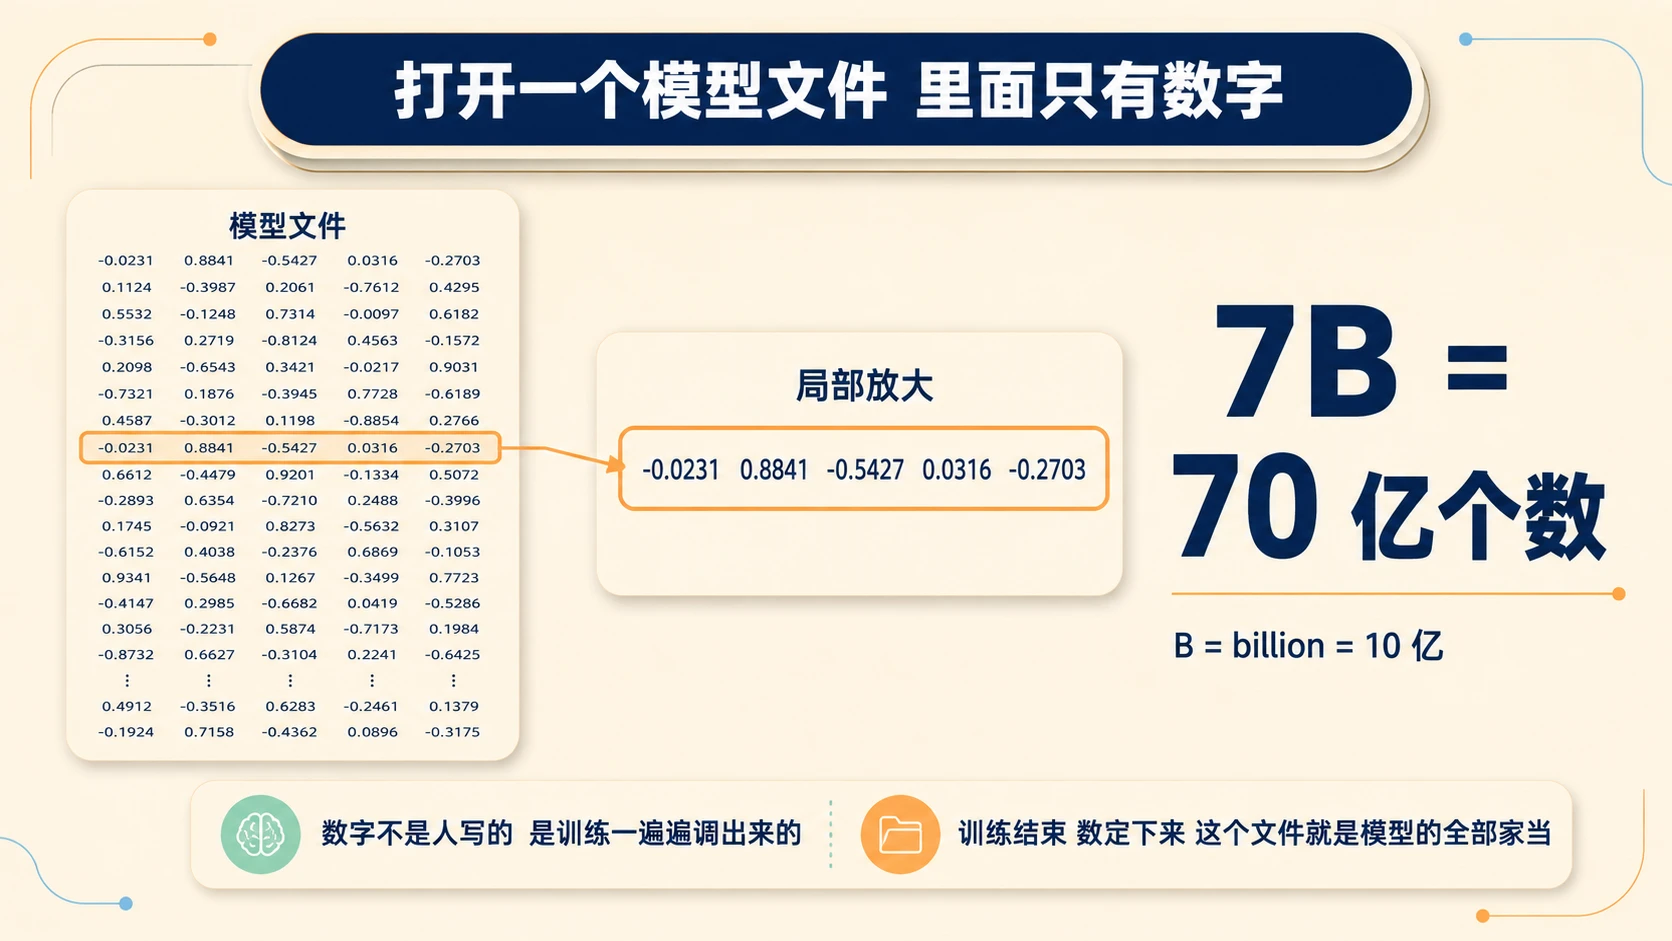
打开一个模型文件,里面没有代码,没有逻辑,只有数字,几十亿上万亿个数字。参数就是这些数字的个数:7B 的 B 是 billion,70 亿;2.8 万亿,就是 28000 亿个数。这些数不是人写的,是训练调出来的——训练干的事,就是让模型反复做题、反复改这些数,改到预测足够准为止。训练一结束,数定下来、存盘,这个文件就是模型的全部家当。
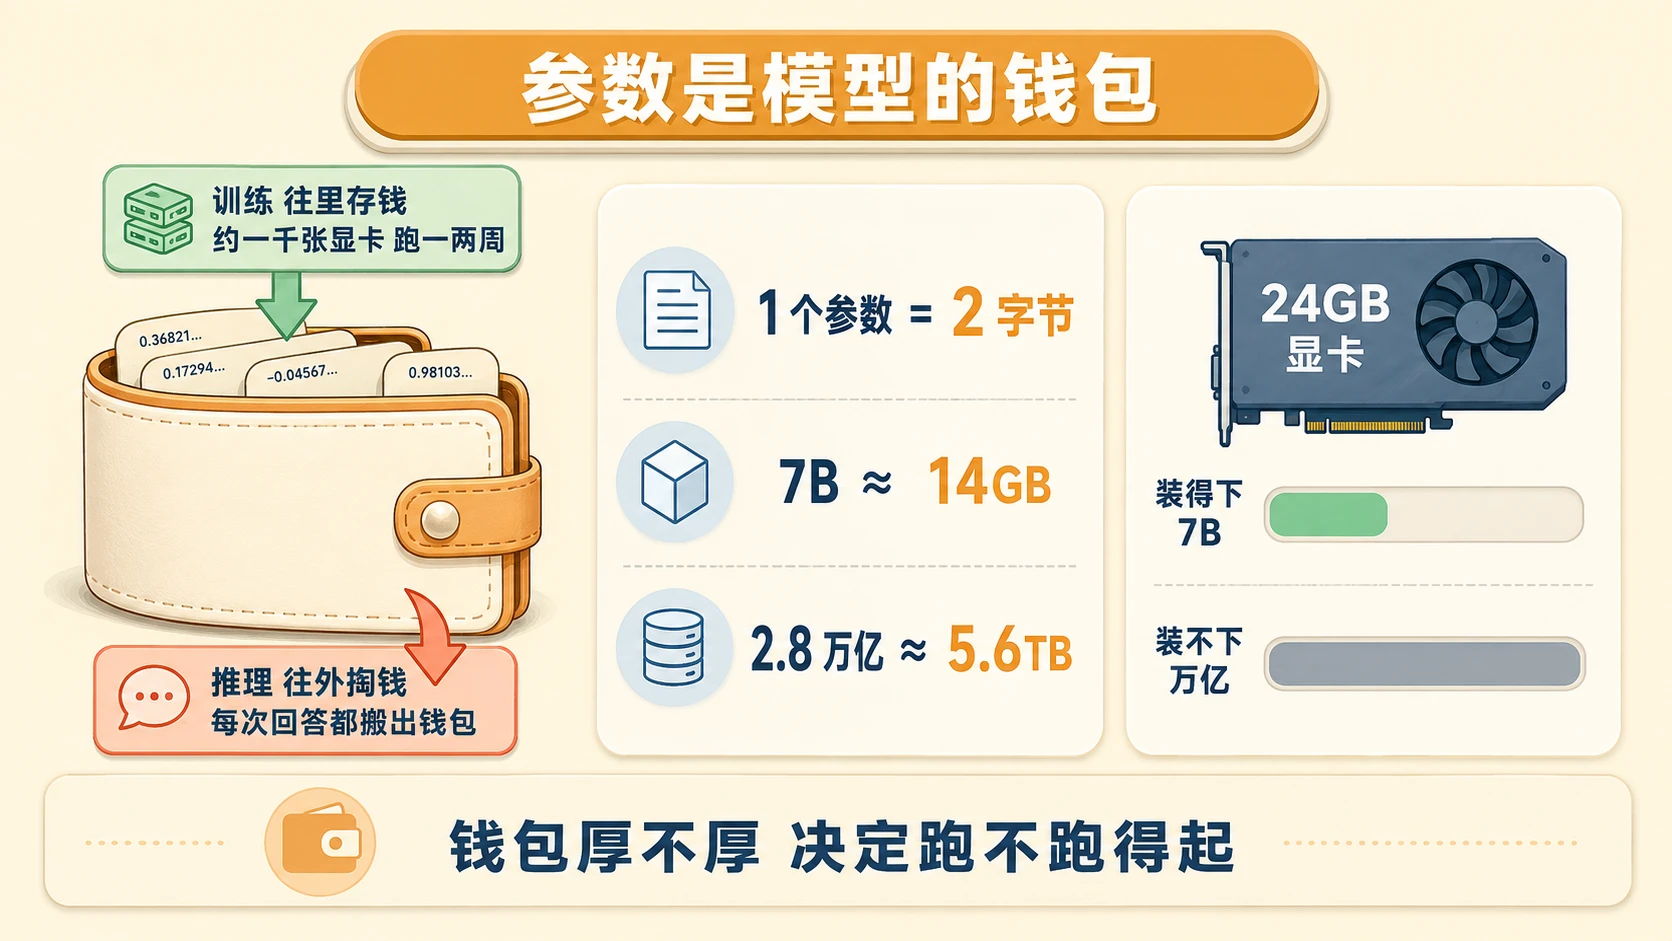
所以行业里管参数叫模型的钱包。往里存钱的是训练:公开估算,一个 70B 模型要一千来张顶级显卡跑上一两周,电费和卡时都是真金白银,存这么一次,数额巨大。往外掏钱的是推理:模型每次回答,都得把钱包搬出来用。按最常用的存法,一个参数占 2 个字节,7B 就是 14GB 显存,2.8 万亿就是 5.6TB。你电脑里那张 24GB 的显卡,装得下 7B,装不下万亿——钱包厚不厚,直接决定这模型你跑不跑得起。
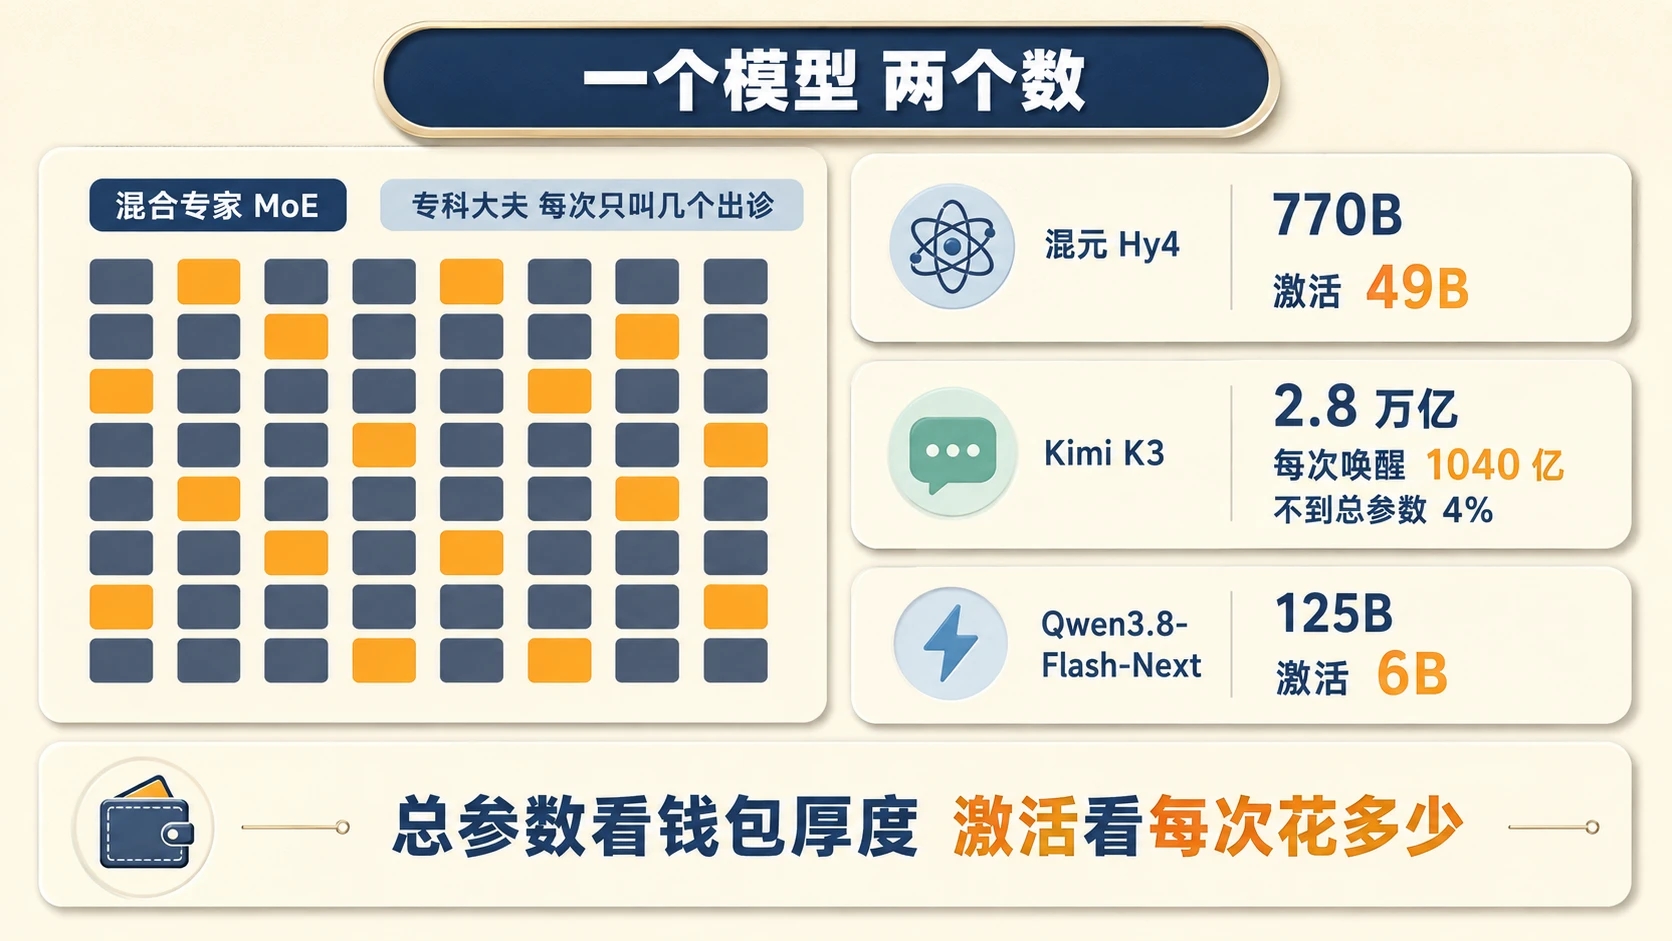
那混元 Hy4 的 770B 和 49B 是怎么回事?这是现在旗舰模型的主流做法,叫混合专家,英文 MoE:钱包里不住一个管家,住几百个专科大夫,来一个病人,只叫相关科室的几个大夫出诊,其他人歇着。770B 是全部大夫,49B 是每次真正干活的。Kimi K3 更夸张:2.8 万亿总参数、896 个专家,每吐一个字只叫醒其中 16 个,合 1040 亿,不到总参数的 4%。Qwen3.8-Flash-Next 是 125B 总参数、每次激活 6B,官方说这是下一代旗舰的骨架。看懂发布会数字就一条:总参数看钱包厚度,激活参数看每次出诊花多少。
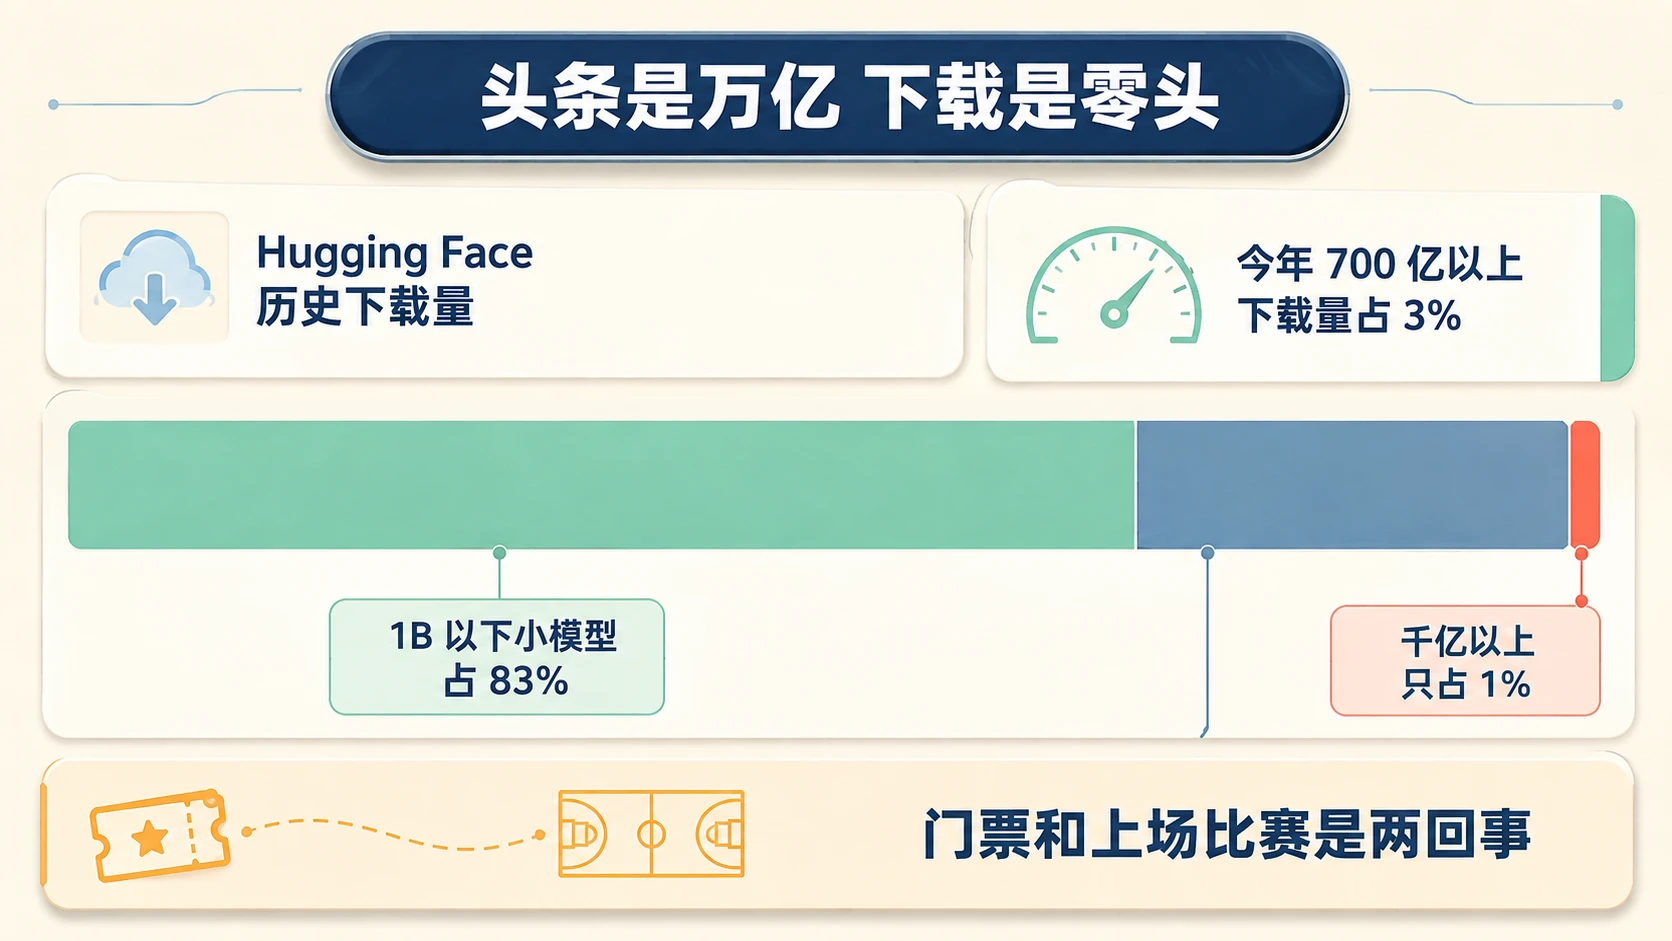
参数越大越好看,但大模型其实是少数派。Hugging Face 的统计:历史下载量里,1B 以下的小模型占了 83%,千亿以上的只占 1%;今年的情况差不多,700 亿以上的模型,下载量只占 3%。发布会头条都是万亿俱乐部,真被世界各地的人天天跑着用的,是几个亿到几百亿的小家伙。门票和上场比赛是两回事——2 万亿是进发布会的门票,不是被用起来的门票。
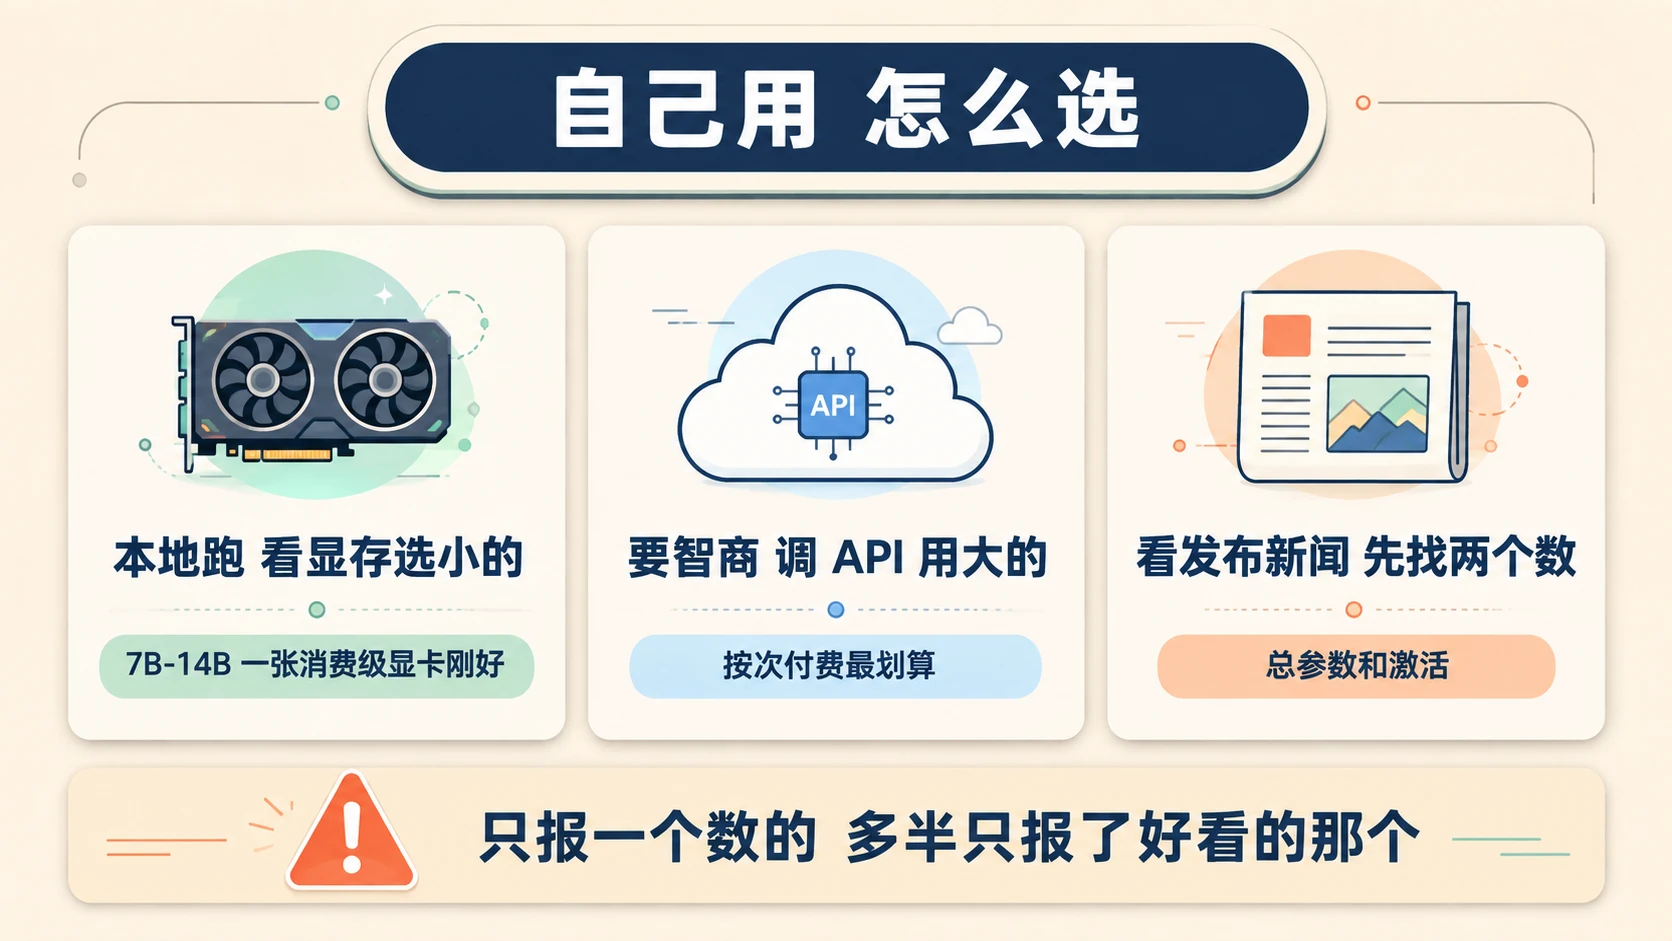
落到自己用,三句话。本地跑,看显存选小的:7B 到 14B,一张消费级显卡刚好,数据还不出自己的机器。要智商,调 API 用大的:旗舰的钱包你买不起也养不起,按次付费最划算。看发布新闻,先找两个数——总参数多少、激活多少;只报一个数的,多半只报了好看的那个。
回头看,地基四块讲完了:字变编号,编号排队进窗口,窗口里按赔率抽签,抽签的底气来自钱包。下一期往上走一层:模型为什么一本正经地编——幻觉从哪来,就讲这个。稀疏注意力那些更硬的题,再往后排。
这个系列每期拆一个概念,前三期讲的是 token、上下文窗口和 temperature(图解AI,首发于公众号「潜在工作室Tech」)。第四期,到这。