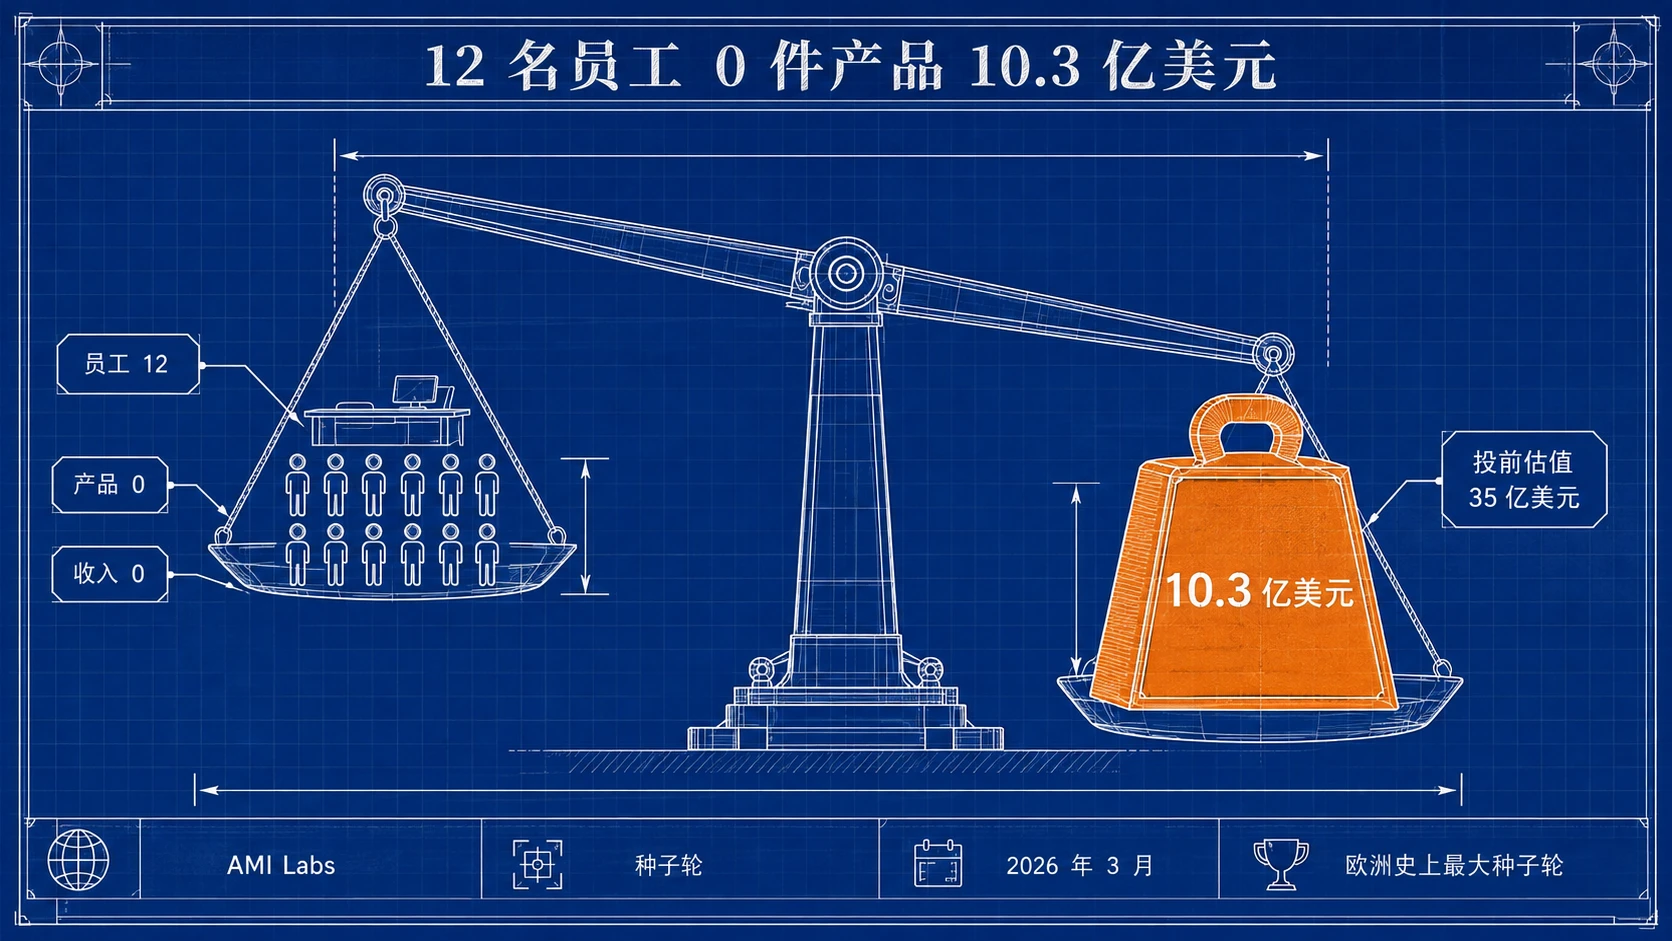
今年 3 月 10 日,一家成立不到三个月、只有 12 名员工、没有任何产品的公司,完成了 10.3 亿美元的种子轮融资,投前估值 35 亿美元,是欧洲历史上最大的一笔种子轮。投资方名单里有贝索斯的个人基金、英伟达、三星、淡马锡、埃里克·施密特和万维网发明人伯纳斯-李。公司明说自己短期内不打算产生收入,按创始人的口径,五年之内都不会有可卖的产品。
这家公司叫 AMI Labs,创始人是 65 岁的图灵奖得主杨立昆(Yann LeCun)。去年 11 月他宣布离开待了十二年的 Meta——前五年创办并领导 FAIR,后七年任首席 AI 科学家——新公司总部设在巴黎,方向只有一个:世界模型。这笔钱赌的是一句话:大语言模型不是通用人工智能的答案,甚至不是通往答案的那条路。杨立昆自己的说法更直接,他说 LLM 是死胡同。
写这篇之前需要先交代立场。我们这个小团队的日常交付、这个公众号的内容管线、官网的 AI 客服,全部建在大模型上,是名副其实的立场相关方。但立场相关不等于要替它辩护。正因为我们每天用它干活,「好用」和「是答案」之间的那道缝,我们自认看得比评论员清楚。这篇文章想把 2026 年这场路线之争双方的论据摆齐,然后给出我们自己的答案。
反方:三位旗帜人物各自押了什么
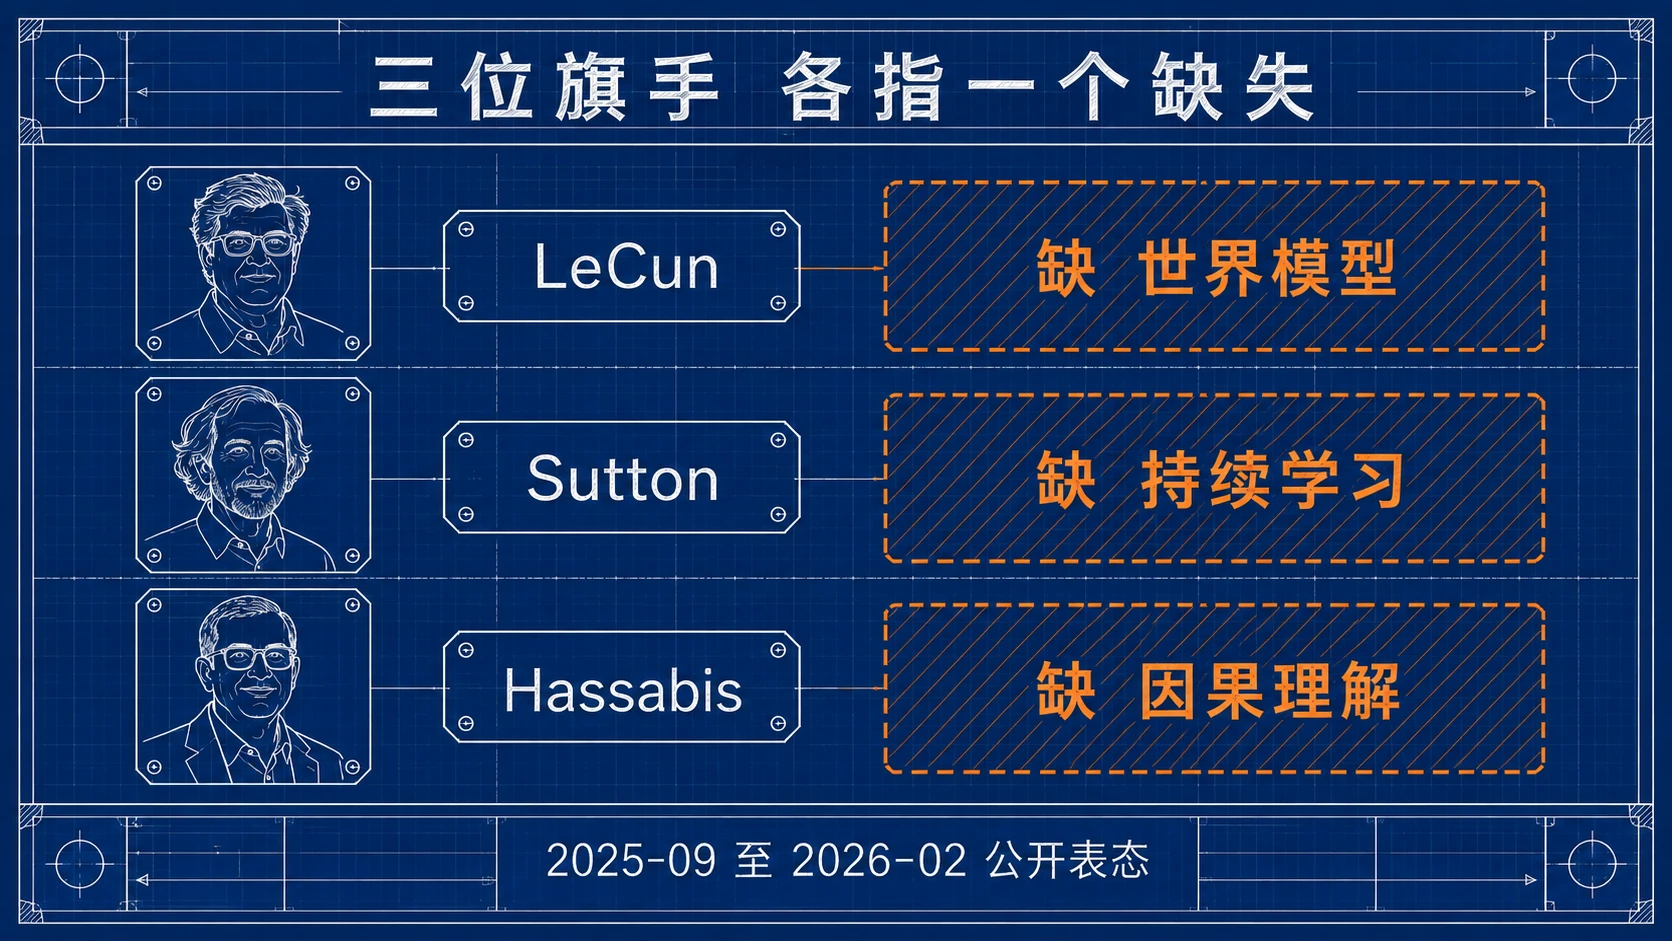
反方阵营里最系统的论述来自杨立昆本人。今年 1 月达沃斯的一场炉边对谈里,他给出的理由是生成式架构对付不了真实世界:文本是干净的、离散的,而真实世界连续、高维、充满噪声,自回归的下一个词预测无法对「所有可能的未来」建立分布。他常举的对比是数据效率:大模型用三十万亿词训练,一个四岁的孩子通过视觉神经接收的数据量与此相当,却已经学会了直觉物理。他的另一个论据更朴素:我们至今没有能收拾餐桌、把碗放进洗碗机的机器人。去年 12 月在纽约 Pioneer Works 与 DeepMind 研究员、物理学家 Adam Brown 的公开对谈中,他把这套论述完整讲了一遍,结论是出路在他 2022 年提出的 JEPA 架构和世界模型。今年 2 月在印度 AI 影响力峰会上,他说得更不留情面:除了少数领域,LLM 本质上是信息检索系统。
第二条线来自强化学习之父理查德·萨顿,《苦涩的教训》的作者、2024 年图灵奖得主,严格说他不是反大模型阵营的人,这让他的批评更有分量。去年 9 月他在 Dwarkesh 的播客里说,LLM 学的不是经验,而是「在这种情况下一个人会怎么做」;持续学习需要对一个行为之后世界会发生什么有预测,LLM 没有这样的 ground truth。主持人把这段话总结为「无论怎么扩展,我们都需要某种新架构来补上持续学习」,这句流传很广的总结其实是主持人的概括而非萨顿原话,不过萨顿本人的判断方向一致:LLM 是死胡同,这也是那期节目的标题。
第三条线值得一提,因为它来自正在赢的那一方。Google DeepMind 的 CEO 哈萨比斯今年 1 月在 CNBC 的节目里说,今天的大模型擅长模式识别,但不真正理解因果:它们不知道 A 为什么导致 B,只是按统计相关性预测下一个词。他认为真正的科学发明需要在头脑里运行思想实验,也就是需要世界模型,而现有的 AI 系统做不到这一点;LLM 缺的是长期规划、持续学习和更深的推理。他估计 AGI 还需要五到十年、大约两次 AlphaGo 量级的突破,其中一次不是更大的语言模型。在 Lex Fridman 的播客里,他把「现有方法单纯扩展上去能否到 AGI」判断为五五开。当 DeepMind 的掌门人都只给五五开时,「大模型就是答案」这个说法实际上已经没有旗帜人物在捍卫了。
技术上的硬伤清单可以揉进这三条线里读。幻觉是统计相关性的另一面,至今没有架构级的解法。持续学习的缺失上面已经说了。数据墙是另一重约束:Epoch AI 的测算是人类公开文本的有效存量约 300 万亿 token,按当前消耗速度,用尽的中位年份是 2028 年。苹果去年 6 月的论文《The Illusion of Thinking》用可控复杂度的谜题实验证明,推理模型在复杂度越过某个阈值后准确率完全崩溃,而且崩溃前会主动减少思考。这篇论文的实验方法随后受到广泛质疑,一篇署名里混着 Claude 的反驳论文后来被作者承认部分是玩笑,但它指出的现象本身没有人能否认:推理能力存在天花板效应,且我们说不清天花板在哪。
正方:这个版本确实被它接管了
反方论据齐全,但桌面上另一叠证据同样厚,而且更硬的部分在于,它是已经发生的事实而不是论证。
第一件是通用性本身。2022 年之前,AI 的历史是专用系统的历史:下围棋的不会说话,识图的不会写码。此后对话、写码、生图、生视频被同一条路线接管,一个模型干所有事,这是 AI 史上第一次出现通用性。不管它是不是终局,这个事实没有先例。
第二件是 scaling 没有死,是换了赛道。黄仁勋去年在 CES 首提、随后在 GTC 系统阐述的「三个 scaling law」说的就是这件事:预训练的边际收益在递减,但后训练的强化学习和推理时的扩展接上了:让模型先生成大量思考再给出答案,推理算力的需求因此涨了百倍。Anthropic 的 CEO 达里奥·阿莫迪今年 2 月的口径一样:scaling laws 没有失效,我们只是从预训练 scaling 走到了 RL scaling;他同时把 AGI 的预期放在一到三年内。你可以怀疑他的时间表,但「这条路还在产出」这个判断,过去十二个月的证据站在他这边。
第三件是落地。国内媒体的普遍口径把 2026 年称为智能体元年,量子位在 WAIC 期间的报道标题就是后 Scaling 时代的范式重构:行业告别粗放式参数竞赛,转入以智能体为核心的落地阶段。软件行业是最先被改写的那个:Anthropic 8 月发布的 AI 原生开发流程手册,前提就是编码 agent 已把构建环节从周压到小时,瓶颈搬到了流程上,我们上一篇拆过这份手册《Anthropic:代码不再是瓶颈,流程才是》。
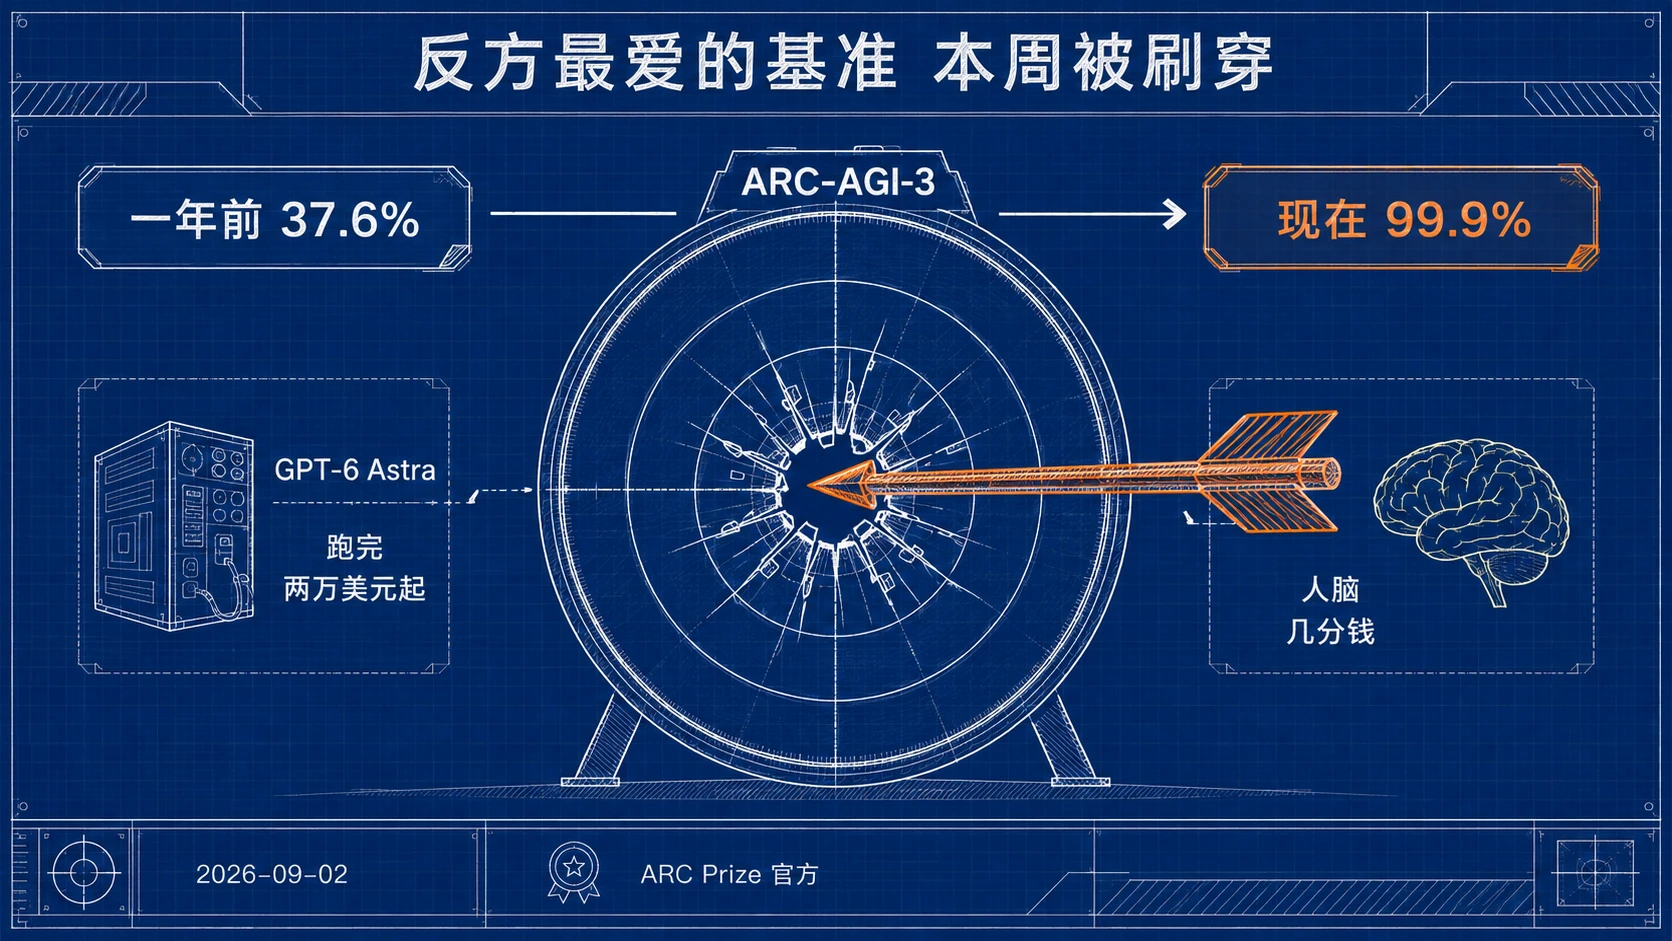
最硬的一块新证据出现在本周。ARC-AGI 是反方过去几年最爱引用的基准,它专门考察「没见过的新题型」,被认为是记忆力之外的智能试金石:2024 年底 o3 以 87.5% 首次攻破 ARC-AGI-1 时还是轰动事件,而一年前商业模型在 ARC-AGI-2 上的最好成绩只有 37.6%。9 月 2 日,ARC Prize 官方公布了 GPT-6 Astra 的成绩:ARC-AGI-2 上到 95%,今年新设的交互式基准 ARC-AGI-3 在标准环境下 62.7%,在提供商适配环境下 99.9%,且在 96% 的关卡上动作效率高过人类中位数。官方同时声明刷穿基准不等于证明 AGI,这个声明是对的,但反方从此失去了这块最喜欢的论据。这一条战线上剩下的真问题只有成本:Astra 跑完 ARC-AGI-3 全程要花掉两万到五万美元,而人脑完成单题的能量成本以分计。能力差距在关闭,效率差距仍是数量级的。
版本答案,不是终局答案
把双方论据摆完,我们认为问题本身值得拆开看一眼。「版本答案」是从游戏里借来的词,指的是当前版本环境下的最优解,这个词的定义里就不包含终局:下个版本环境一变,答案跟着换。
AI 的历史就是一串版本答案。上一个版本的答案是深度学习,2012 年之后它接管了视觉和语音;再上一个版本的答案是搜索和统计方法,它接管了互联网;更早的版本答案是专家系统,它在八十年代让 AI 第一次变成生意。每一个在它自己的版本里都是无可争议的正确答案,也每一个都不是终局。用这个词问「大模型是不是 AGI 的版本答案」,等于同时问了两件事:它是这个版本的答案吗?是,证据如上。它是通向 AGI 的充分条件吗?这问的是下个版本,而目前没有人知道下个版本的环境长什么样。
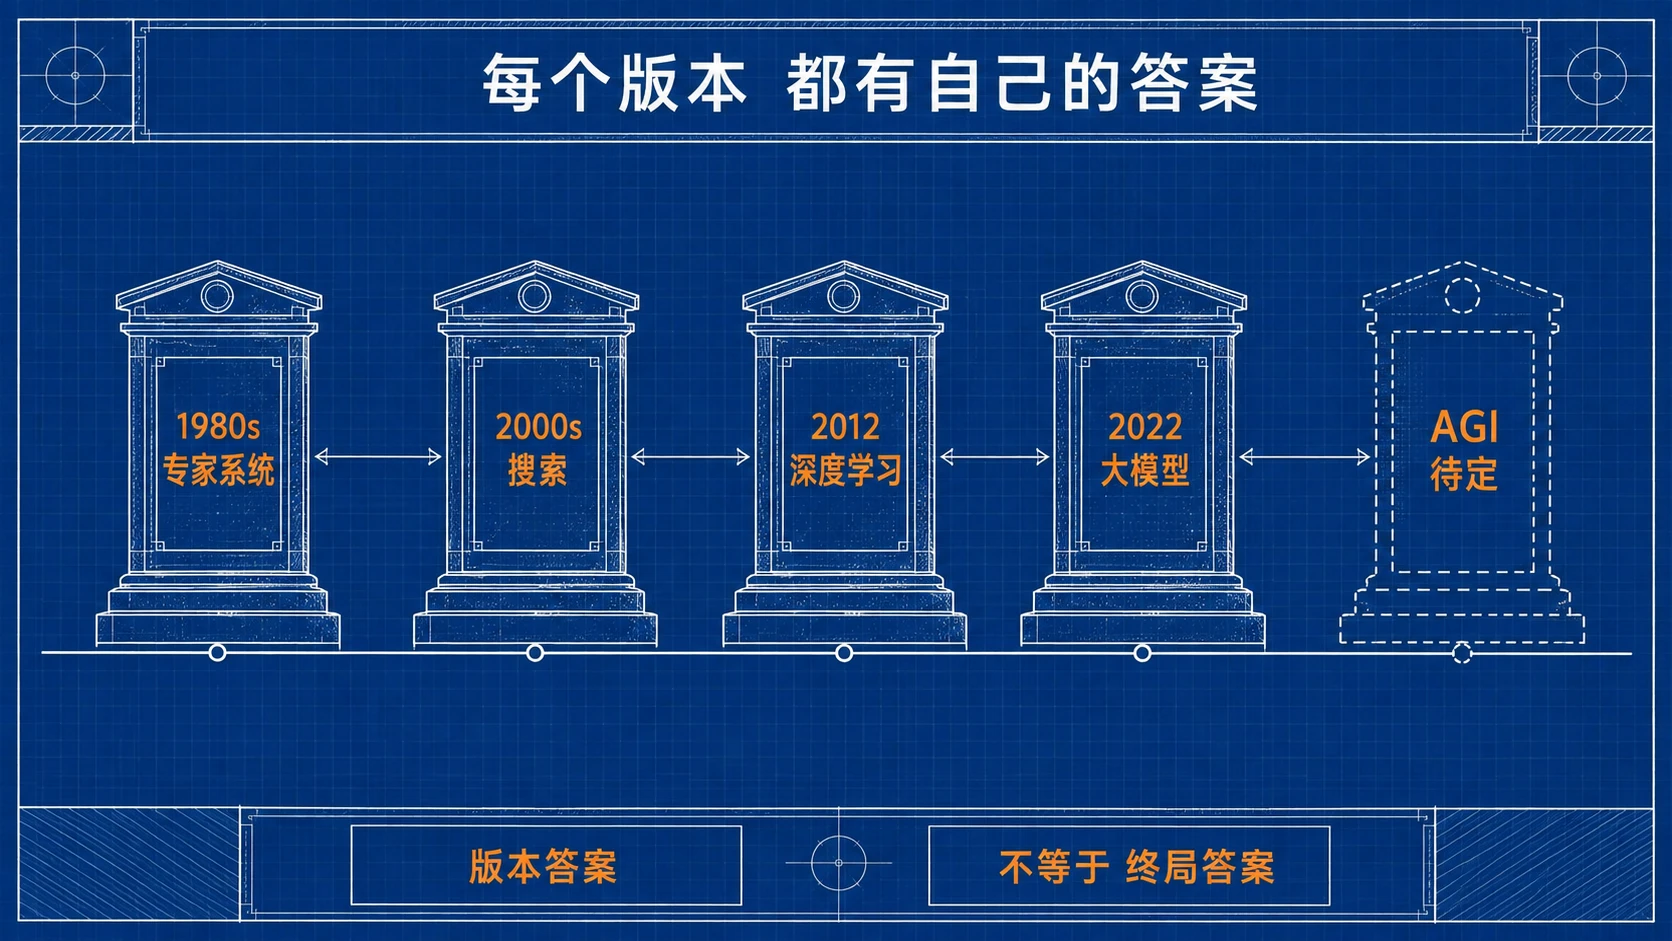
2026 年的实际格局可以这样概括:头部实验室里已经没有人把「纯预训练大模型一路扩展下去」当作唯一答案,分歧只在要补的那个 X 是什么。最接近反例的是 OpenAI,萨姆·奥尔特曼去年初写过「我们确信已知道如何构建传统意义上的 AGI」,今年 2 月在印度又说超级智能的早期形态可能两年内出现,但即便是 OpenAI,公开的产品叙事也已经全面转向推理模型和智能体,而不是更大的预训练。世界模型方向的拥挤程度是另一个旁证:杨立昆的 AMI Labs 之外,DeepMind 的 Genie 3 已经在实时生成交互式世界并产品化为 Project Genie,李飞飞的 World Labs 以 50 亿美元估值完成了 10 亿美元融资、首个产品 Marble 去年 11 月上线,从游戏视频数据切入的 General Intuition 种子轮拿了 1.34 亿美元、A 轮估值已到 23 亿美元。学术界今年也在跟进,ICML 2026 接收的一篇 position paper 把世界模型正式定义为「智能体与真实世界之间的中介层」。资本和学术的流向一致:大家都认可底座,都在找 X。
我们的下注:大模型是底座
我们的答案是底座论:大模型更可能成为 AGI 的底座,而不是答案本身。类比是 CPU:CPU 是通用计算的底座,但它不是任何一个应用的答案,答案永远长在底座之上。按这个框架,正确的问题不是「大模型是不是答案」,而是「LLM + X」里的 X 是什么:记忆、持续学习、世界模型、智能体架构,候选清单就是反方论据的镜像。
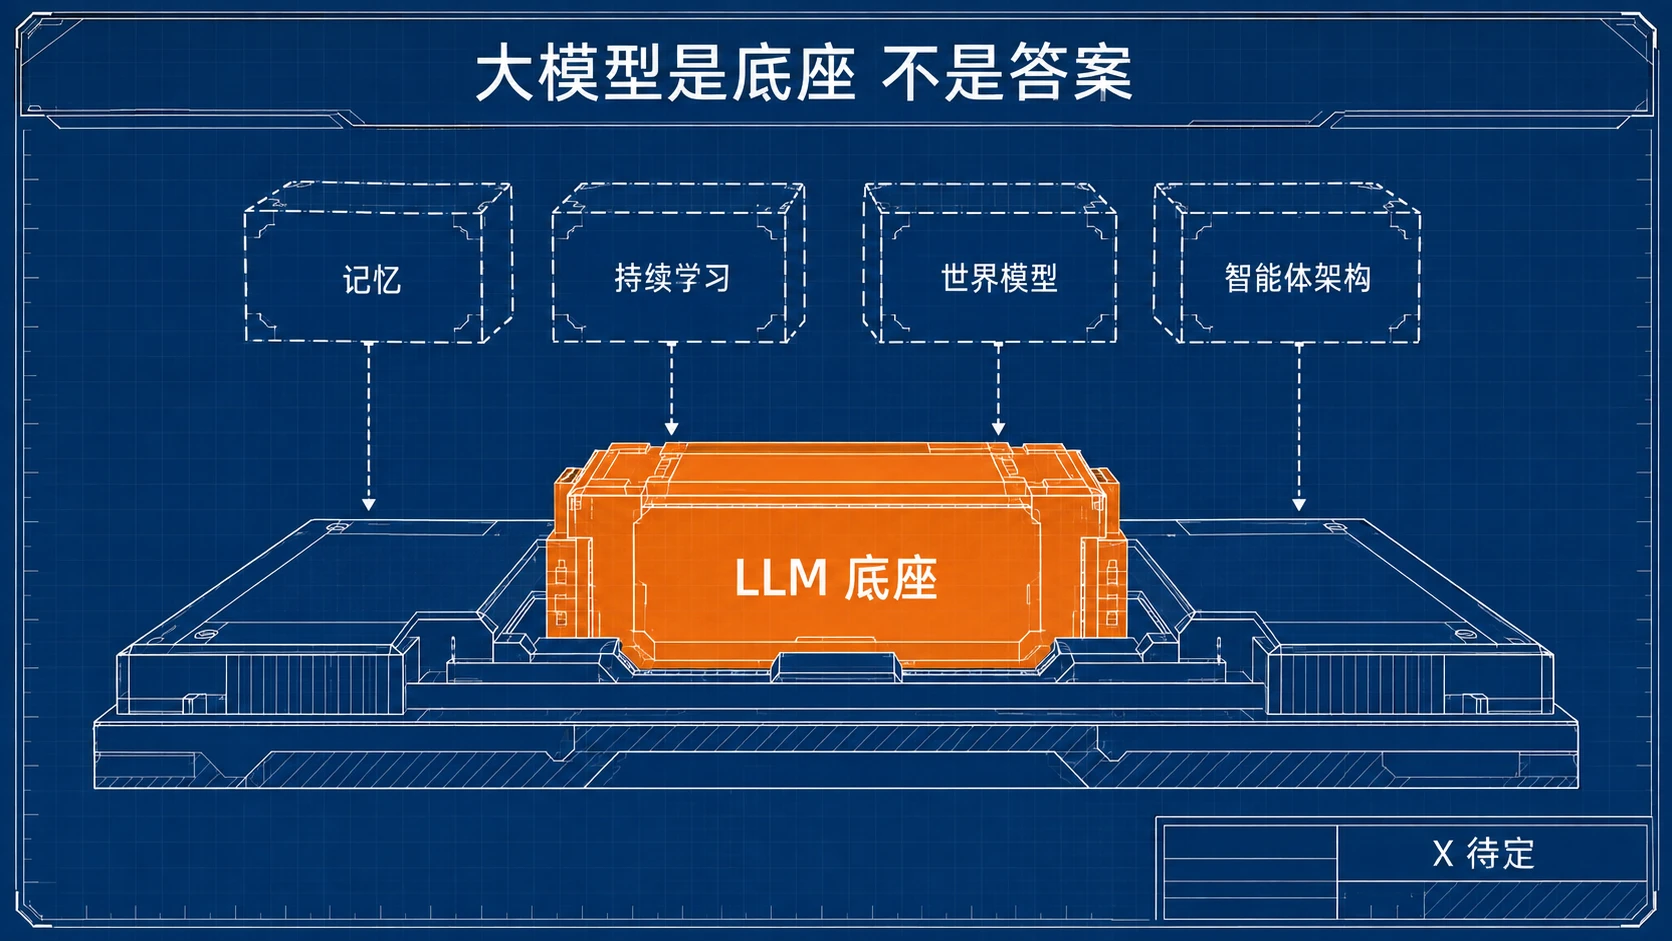
这个判断也是我们自己的下注方式。我们的实践是把大模型当底座用,然后用系统工程补齐它缺的部分:内容管线里模型负责生成,但事实核查、验收标准和发布门禁是确定性的人工与流程;官网的 AI 客服底座是通用模型,但回复边界、知识来源和防滥用规则都是我们自己加的外层。这套「底座加纪律」的形态和 AMI Labs 们的赌法并不矛盾:他们赌底座需要新的科学,我们赌的是在新科学到来之前,现有底座加工程纪律已经足够支撑真实的业务。两个判断可以同时为真。
这个问题没有投票价值
最后说一句这场争论本身的读法。「大模型是不是 AGI 的答案」没有投票价值,站哪边都不会改变结果;它有观察价值,值得盯的信号有三个:持续学习能不能在工程上落地,这是萨顿划出的及格线;ARC-AGI-3 这类基准的成本曲线什么时候压到人类效率的数量级之内;以及 AMI Labs 那台五年时钟走到哪一步,10 亿美元买的是欧洲最大的一张世界模型彩票,它开奖还是流产,都会改写上面的格局。
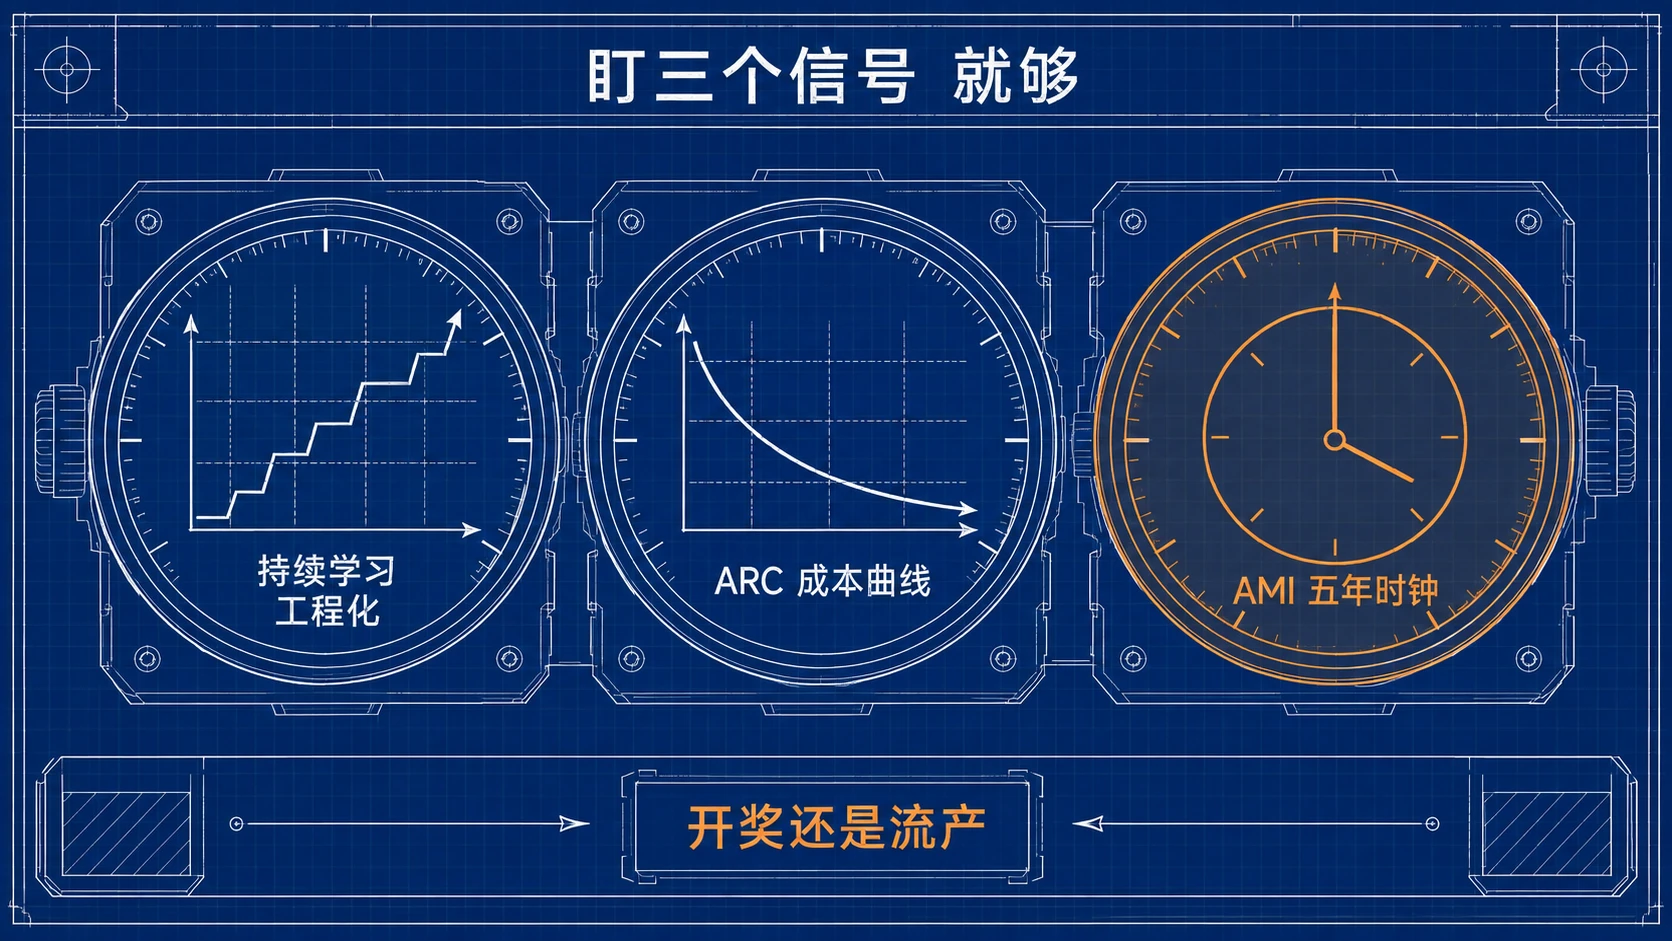
这个号会持续跟踪这三个信号。图解AI 系列接下来两期正好是相关的底层概念——幻觉从哪来、模型是怎么训练出来的,讲清楚这两件事,本文里双方的很多论据你能自己判断成色。这个版本的其他观察:《参数竞赛重启》数清了各家模型走到哪,《Anthropic:代码不再是瓶颈,流程才是》讲的是大模型已经接管的那个行业。