数据取 Artificial Analysis 智能指数 v4.3.2(10 项评测加权,抓取于 2026-10-24)。榜单按配置档计名次,同一模型多档位(max/xhigh/high/medium/low)各占一名;单任务成本为最高推理档位每任务价格。
总榜前 50
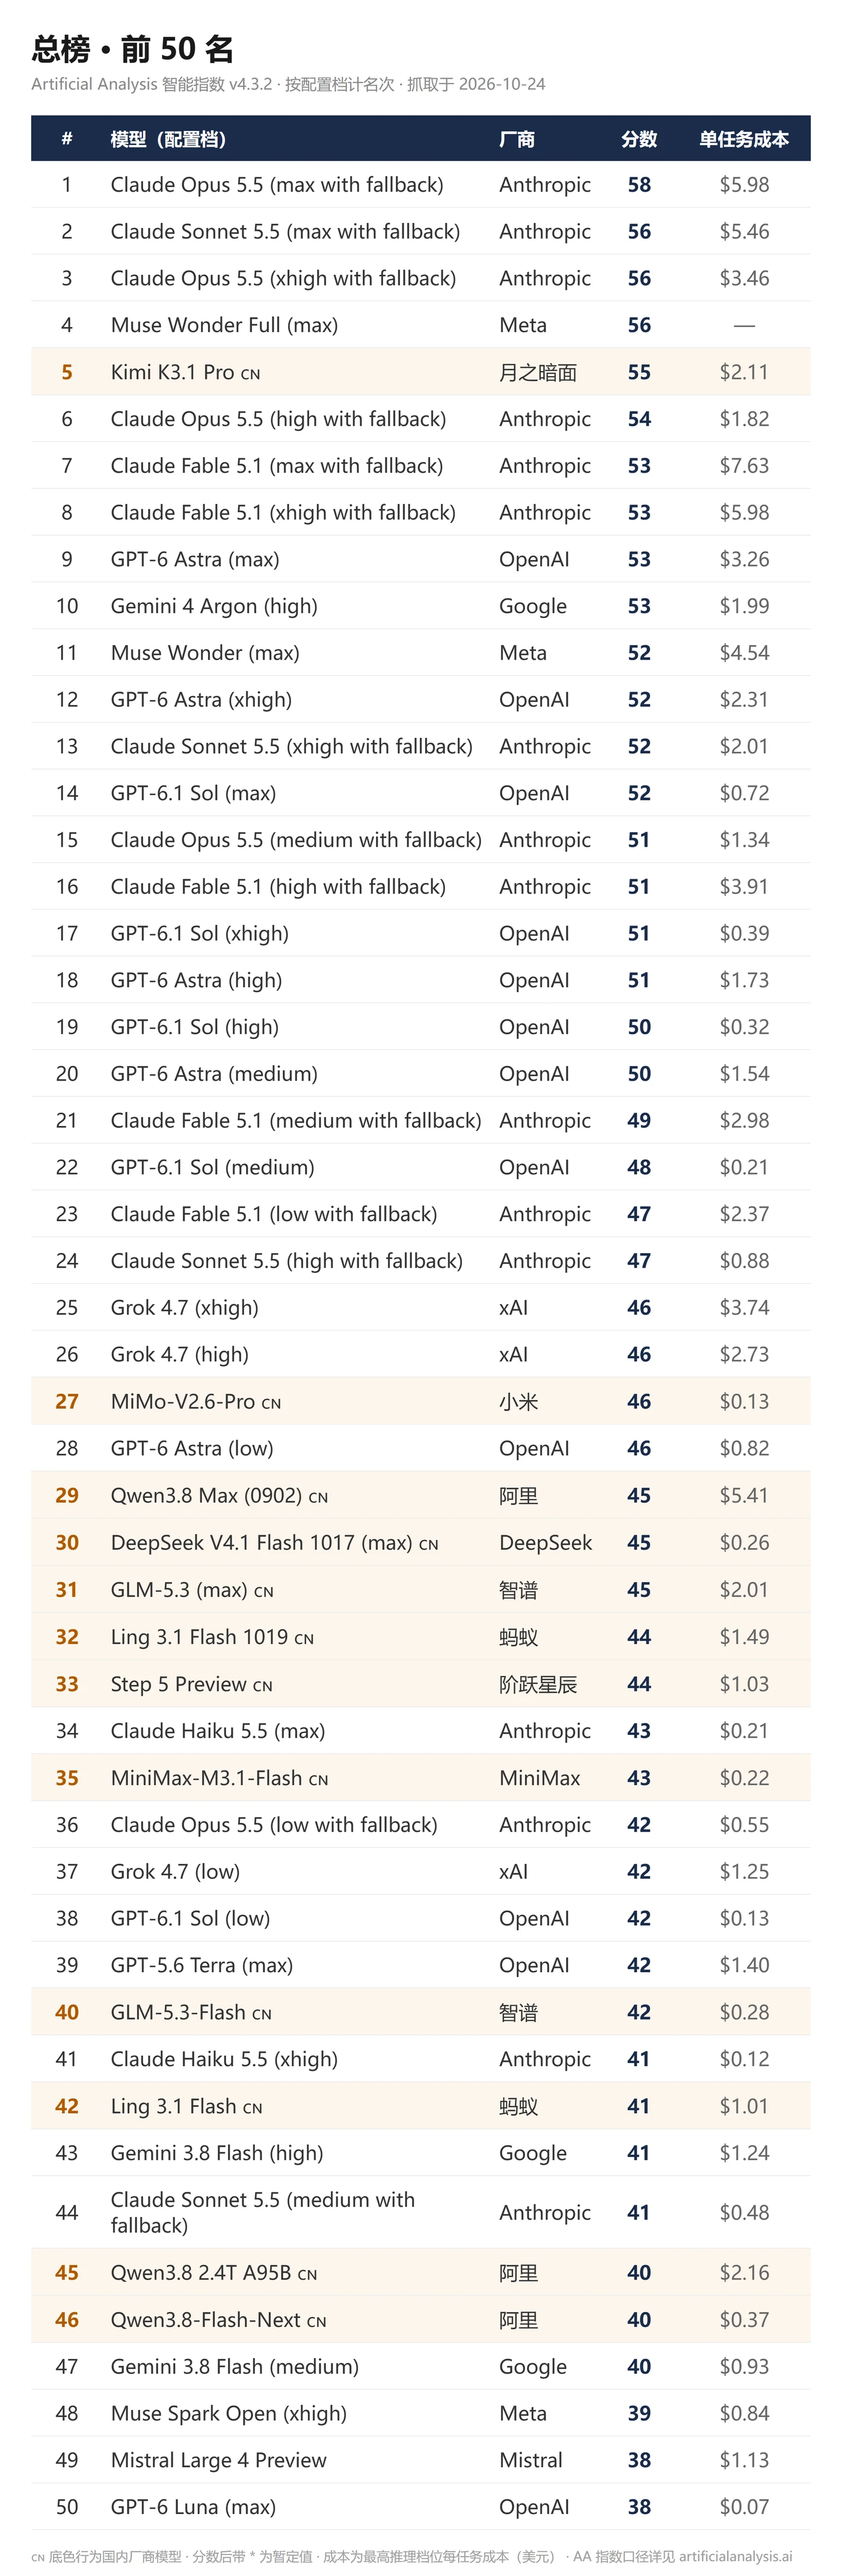
这一期总榜的头名没有悬念:Claude Opus 5.5(58)继续第一,Anthropic 包揽前三里的两席,Muse Wonder Full(56)第四。真正的变化发生在第五名——Kimi K3.1 Pro 以 55 分空降,把自己和第一名的分差缩到 3 分。这是国产模型在 AA 智能指数上的历史最高名次。
K3.1 Pro 落地的连锁反应也立刻体现在榜上:AA 的榜单统计里,Kimi 的现役旗舰已经换成 K3.1 Pro,前代不再单列;DeepSeek 的 V4.1 Flash 旧档同样让位给了 1017 新档(45 分,第 30)。一周之内,国产在榜模型完成了一次代际交接。
国内段:新旗舰空降第五,天花板换了主人
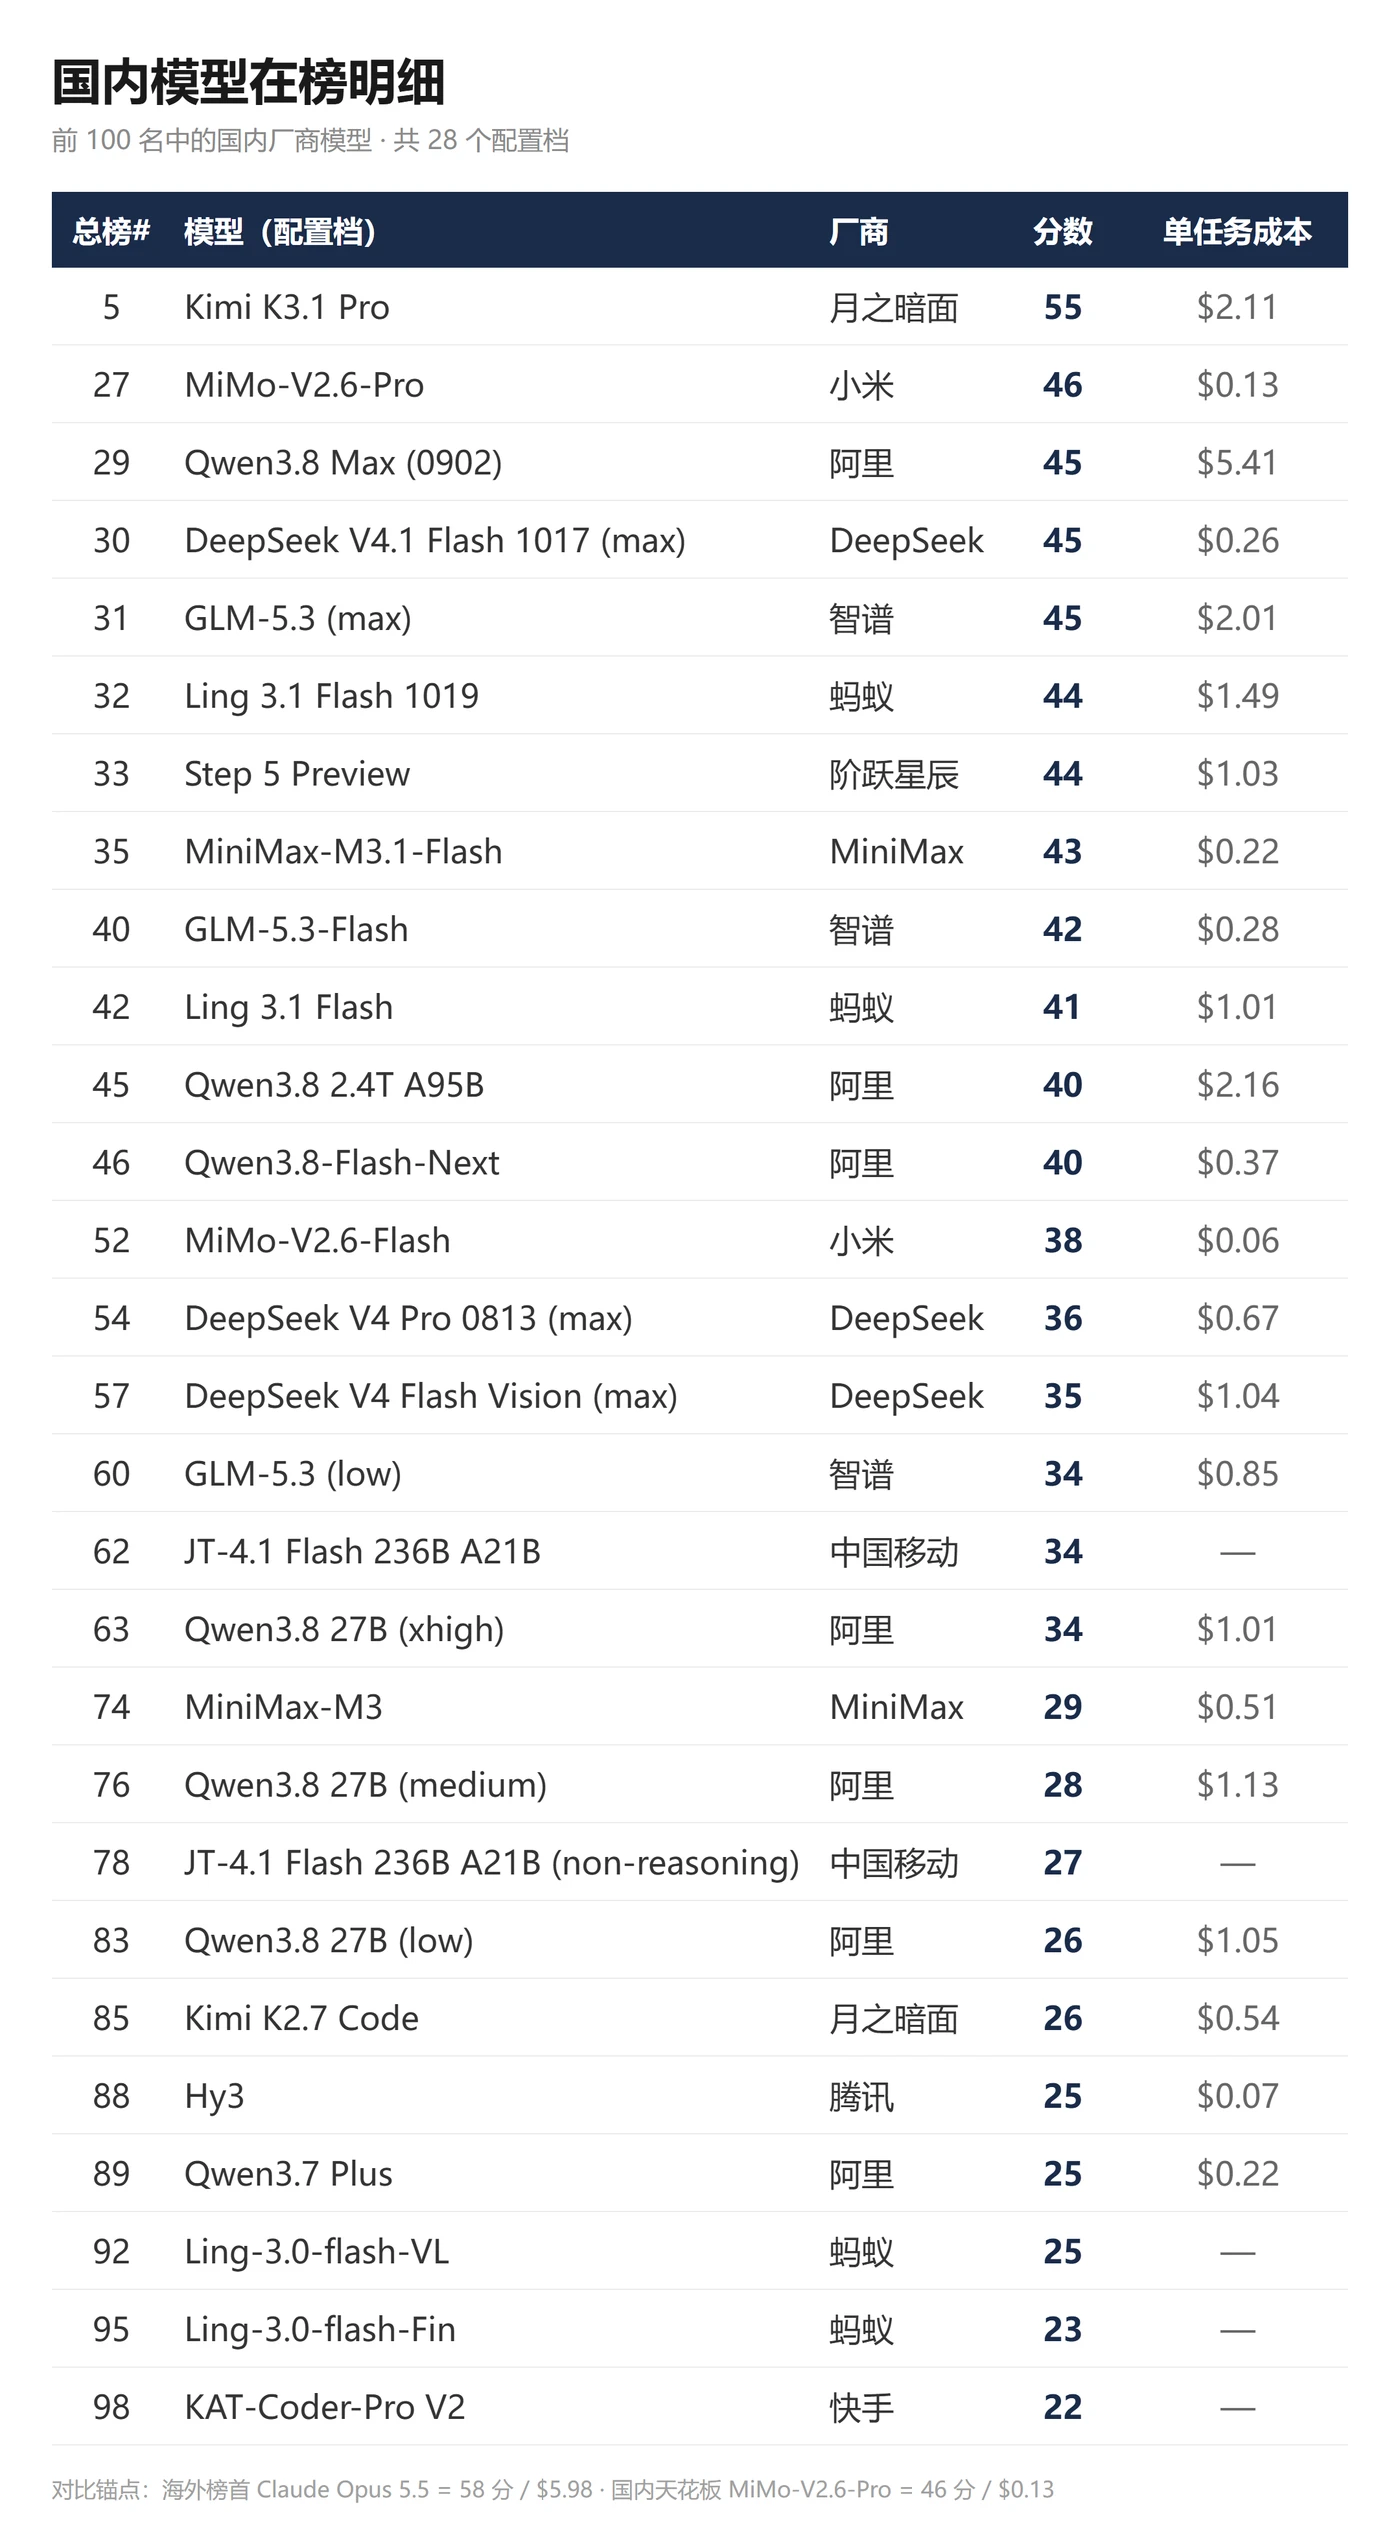
国内模型本期在榜 22 款、28 个配置档。按去重后的梯队看:
- 55 分档(第 5 名):Kimi K3.1 Pro,国产新天花板,比上周的国内最高分(MiMo-V2.6-Pro 46)整整高出 9 分;
- 44-45 分档:DeepSeek V4.1 Flash 1017(45)、Qwen3.8 Max(45)、GLM-5.3(45)、Ling 3.1 Flash 1019(44,新进)、Step 5 Preview(44);
- 43 分档:MiniMax-M3.1-Flash(43,新进)——上周 Space Bunny 马甲转正后的第一个完整周期;
- 42 分以下:GLM-5.3-Flash、Ling 3.1 Flash、Qwen3.8 系列等与上周基本持平。
值得注意的三个新进档位全是 10 月发布的新模型:K3.1 Pro(10-24)、DeepSeek V4.1 Flash 1017(10-17)、Ling 3.1 Flash 1019 与 MiniMax-M3.1-Flash(10-19)。上周我们说国内「零发布、零变动」,这一周全部兑现成了榜面上的新名字。国产与榜首的分差从上周的 12 分缩到 3 分。
不过开放权重层面的第一名还是 MiMo-V2.6-Pro(46 分)——K3.1 Pro 的权重按官方承诺要到 11 月 4 日前才发布,在那之前,它暂时还是闭源状态参与排名。权重落地后,开放权重榜首大概率也要换人。
本周变动:一次干净的代际换血
前 100 名里新进 6 款、跌出 6 款,没有一款是分数下跌导致的:所有真实分数变化为零,进出全部来自新模型上榜和旧档位退榜。
新进的 6 款:Kimi K3.1 Pro(55 分,第 5)、DeepSeek V4.1 Flash 1017(45,第 30)、Ling 3.1 Flash 1019(44,第 32)、MiniMax-M3.1-Flash(43,第 35)、GPT-6 Luna low 档(22,第 99)、SK Telecom 的 A.X-K2(21,第 100)。
跌出的 6 款:Kimi 前代旗舰的两个档位(AA 已改为只统计 K3.1 Pro,前代下架榜单)、DeepSeek V4.1 Flash 的三个旧档、Meta 的 Muse Spark 1.3 两个档位。后者的退榜原因在快照里看不出分数变化,更可能是 AA 榜单展示范围调整,下周继续观察。
上周预告的两个观察点全部兑现:K3.1 Pro 正式发布并空降第 5;DeepSeek V4.1 Flash 1017 完成了 AA 重测,从旧档的 39 分涨到 45 分,一周涨 6 分,是本期涨幅最大的模型。
榜上的分数,我们七天的账本
分数是上限,实际用谁是另一本账。自用网关 magpie 记下了过去七天的每一次调用:13,496 次,token 消耗含缓存读取合计约 19 亿,分布在 417 个会话里。
模型分布和榜单对照着看:GLM-5.3 占 41%(6,818 次,ttft 6.7 秒)、MiniMax-M3.1-Flash 占 19%(3,340 次,ttft 2.2 秒)、Kimi 前代旗舰占 29%(2,278 次,ttft 8.5 秒)。榜上 55 分的 K3.1 Pro 也在账本里出现了——77 次调用,ttft 5.4 秒,包括这篇稿子的写作本身。
有意思的是代际交接在账本上的样子:工作室最近七天的主力调用还压在 Kimi 前代上,而它已经不在 AA 榜单的统计范围里了;新旗舰的 77 次调用里就有这篇稿子。等 K3.1 Pro 的权重落地、订阅额度铺开,账本上的占比会不会跟着换,是下周最值得盯的一个数字。
想看 K3.1 Pro 发布当天的完整拆解——后训练增量、API 定价、任务成本对账——可以读《Kimi K3.1 Pro 发布:提升的大头在 Agent》。榜单口径为什么各家对不上,之前在《同一个模型,每个榜都说它第一》里讲过四类测法的差别。