每月新模型发布会都有一个固定环节:放一张跑分表,标红几个第一。红得多的那个月,全网都在转「屠榜」。可你把几家榜单各自打开,会发现同一批模型的排序对不上,甚至互相打架。
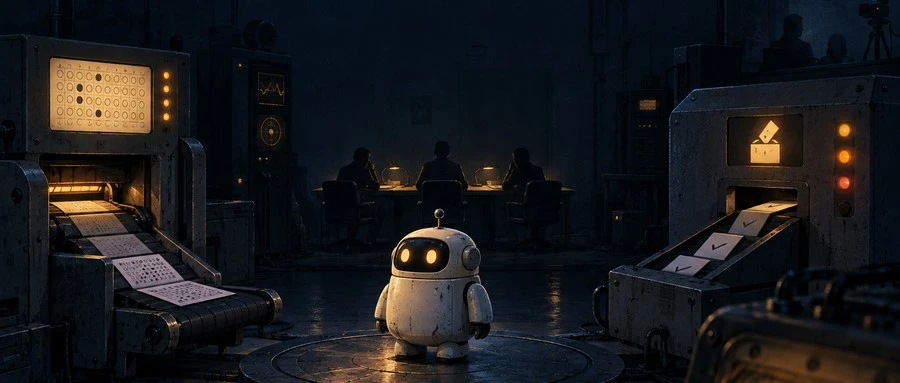
这些榜测的东西不一样。有的发一张卷子让模型做题,有的让真人投票,有的让模型给模型打分,有的干脆只看谁被用得最多。考的东西不同,名次自然对不上。
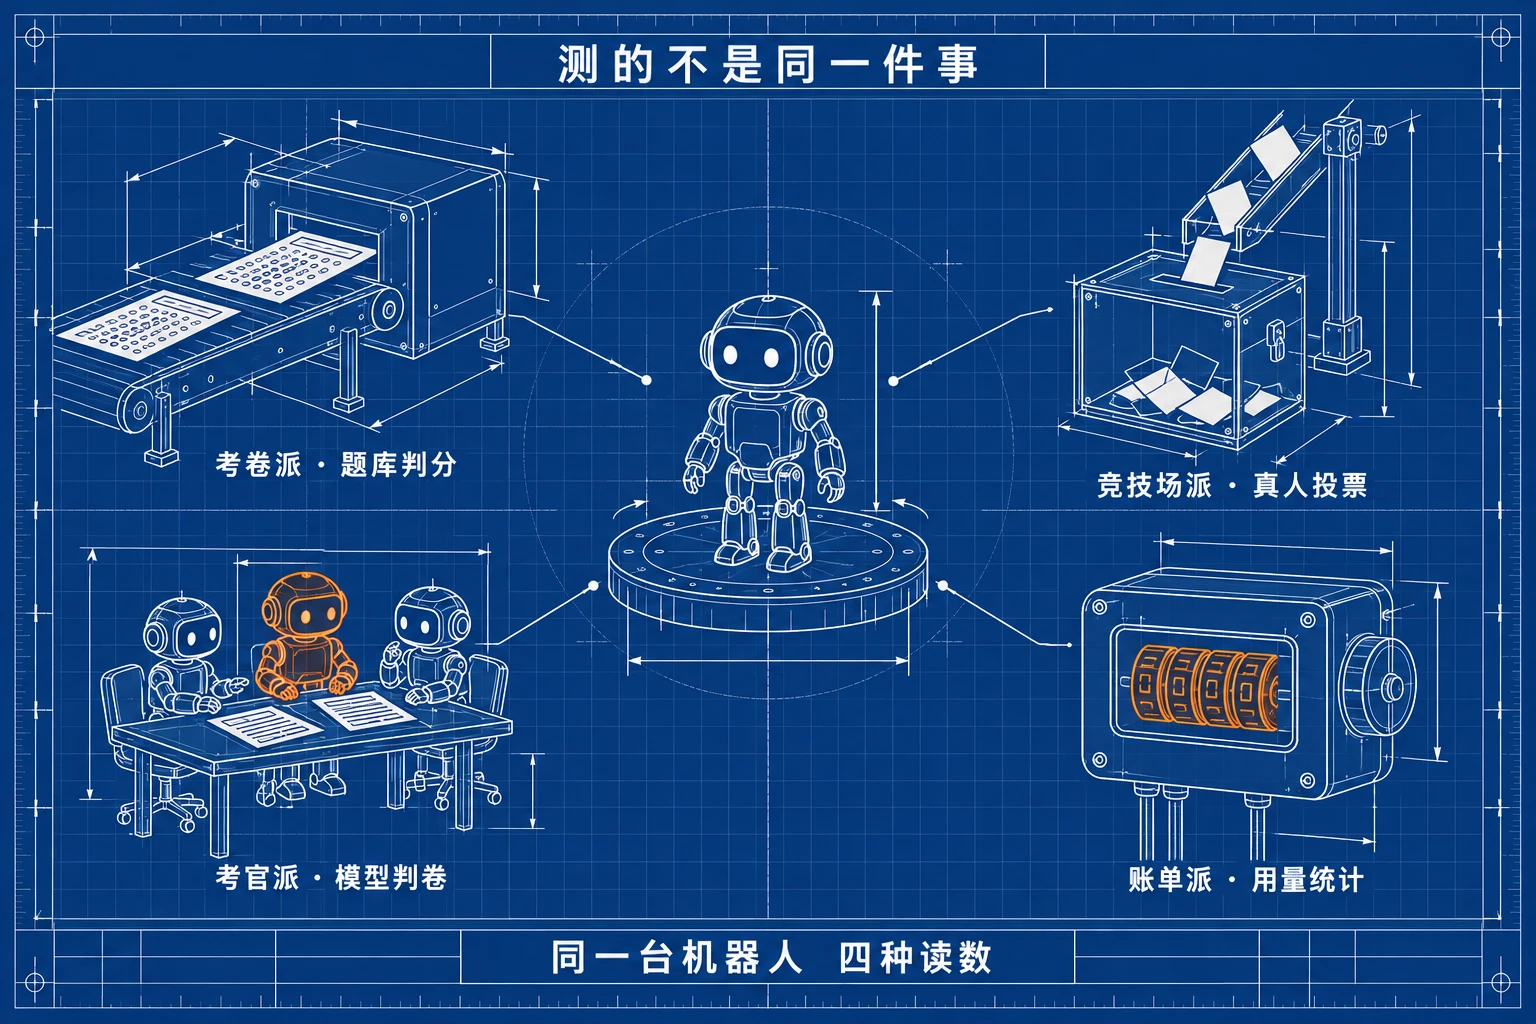
要看懂一份榜单,先要看懂它怎么测。市面上的测评方法,大致分四派。
考卷派:固定题库,机器判分
最早的办法最直接:出题、考试、对答案。MMLU 上万道选择题考综合知识,GPQA 拿博士级的物理化学生物题考专业推理,AIME 用竞赛数学考硬推理。判分完全自动:答案是一个数字、一个选项,对就是对,错就是错,谁跑都一个结果,谁也做不了假。
判卷没有任何人为因素,同样的题再跑一遍,分数不会变。麻烦出在题目上。模型训练时可能已经见过这些题和答案,这叫数据污染,背过考卷的模型分数虚高。题库还会被「做穿」:2023 年 GPT-3.5 在 MMLU 只拿 55 分,2024 年随便一个开源模型都能上 80。题目没有变难,考生变强了,考卷失去了区分度,这叫饱和。
所以新基准在两条路上跑:把题出得更难,或者不断换题。HLE(Humanity’s Last Exam)把题出到「人类最后一考」的难度;LiveBench 每月换一批新题,题从最近发布的论文和比赛里出,模型来不及背。今年 1 月,Artificial Analysis 把智能指数翻了大版本,MMLU-Pro、AIME、LiveCodeBench 这些老基准全部移出,换上真实工作任务和 agent 基准。理由就一条:知识题都考到头了,得改考干活。
竞技场派:真人盲测投票
LMArena 干脆不出题,让真人用。你随手提一个问题,屏幕左边右边各出一份回答,都不知道是谁写的;投完票才揭晓两边是哪两个模型。一份回答讨喜,一份回答正确,你把票投给哪个,Elo 就记哪个。几百万票攒下来,就是跟国际象棋排位同一套数学的排名。
它测的是普通人的观感:读着顺不顺、语气舒不舒服。这个维度别的测法给不了,坑也在这:投票看的是整体印象,不看对错。长回答、客气语气、漂亮排版,都能白捡票。这漏洞真被用过:2024 年底有厂商被社区抓到,给参赛模型的系统提示里塞了一句讨好竞技场的话。官方随后收紧了规则。
投票人群也不等于你。竞技场的主力用户是对 AI 好奇的重度用户,他们觉得好的,未必是写代码、做翻译时你要的那个。Arena 后来把榜拆成综合、编程、创意写作等分榜,就是把「总体喜欢」和「特定场景好用」分开评。
考官派:让模型给模型判卷
再往前一步,让模型当考官。没有标准答案的开放任务,交给几个前沿模型当评委,对着两份答案打分,攒出排名。Artificial Analysis 的智能指数是这一派:十项评估,agent 任务占 34%,比编程、科学推理的权重都高。
为什么敢让模型判卷?因为真实任务的答案没法用正则匹配判对错。AA 的 GDPval 拿的是真实知识工作的活:根据原始数据写经济分析、整理工程文档,对错没有唯一字符串,好坏的判断本身就需要理解力,只能交给更强的模型。AA 的办法是用 Opus、GPT-5.6、Gemini 三个评委交叉判卷,单个评委的偏好互相抵消一部分。
这一派绕不开自指:判卷的还是模型。Arena 九月发布的研究发现,LLM 评委偏爱自家回答的倾向比人类高 70%。模型给自己人打分,下不去狠手。所以看这类榜,先看它的评委是谁、有没有利益关联。
账单派:用钱投票
最后一派什么都不考,只看用量。OpenRouter 榜排的是各家模型通过它的 API 被实际调用的 token 量。开发者的钱花在哪,榜就排到哪。
用量榜上,排行榜头部的贵价旗舰用量常常排在几个便宜模型后面。大多数活不需要最强,够用就行。也有模型在某个编程场景特别好使,用量冲得很高,拿它写散文就不行了。账单榜适合看生态和趋势:哪个模型在被真实工作大量使用、风向怎么变。拿它选型会错位,别人用得多,不等于你该用。
榜单地图
把主流榜单按四派归位:
Artificial Analysis(AA):考官派代表,英国独立机构,自己买 API 跑十项评估,智能指数外还出价格、速度、时延榜。我们每周六发的 AA 周榜,数据全部来自这里。
Arena(原 LMArena):竞技场派代表,从伯克利学术项目长成公司,八千多万票的人类偏好数据集是全球最大的。综合榜之外有编程、文生图、搜索等十几个分榜,今年还上了事实准确度维度。想看大众口味,先看它。
LiveBench:考卷派的防背题改良款,每月换题,ICLR 2025 论文,Abacus.AI 出资。要看不受背题干扰的硬智力,看它。
SuperCLUE:国内机构出的中文基准,从 CLUE 语言理解评测延续而来,测中文理解和生成,覆盖主流国产模型。中文任务为主时,它的参考价值比英文榜高。中文能力不是英文榜翻译一下就测得出来的,它本身就是另一套语言能力。
OpenCompass 司南:上海人工智能实验室的开源评测体系,评测代码整套开源,能在自己机器上把分数跑出来验证。对较真的团队,这比看榜实用。
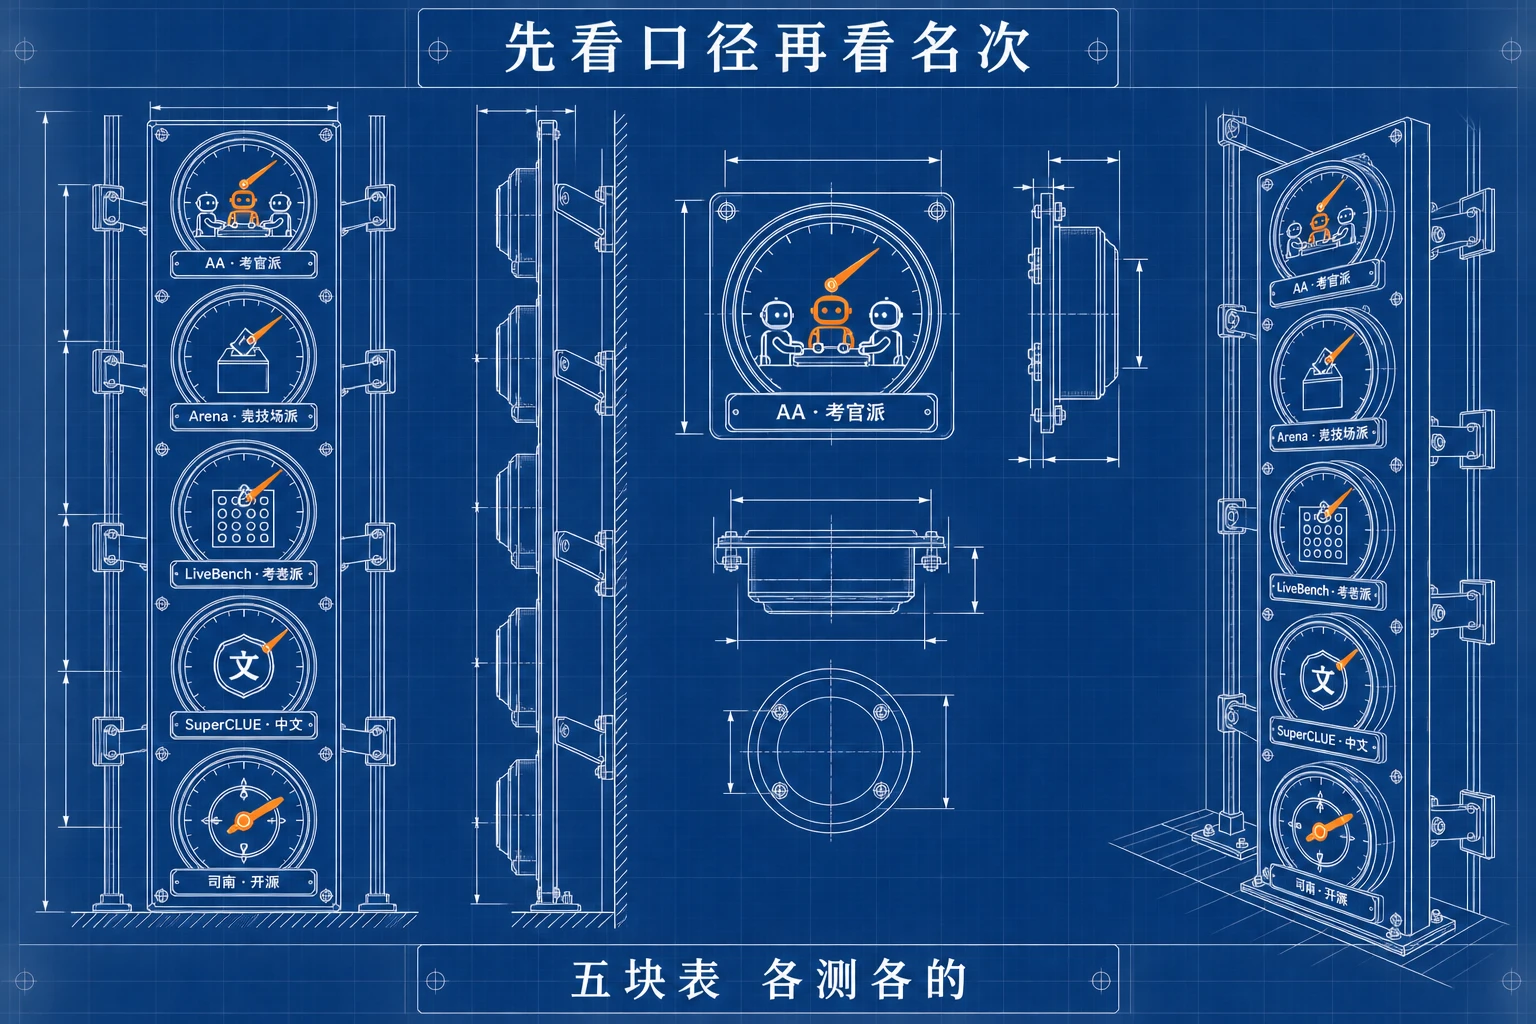
看榜三条心法
**一、只在同一个榜里比。**跨榜比名次没有意义。AA 的第一考的是干活能力,Arena 的第一考的是讨人喜欢。要跨榜,比「变化」不比「名次」:一个模型在两个榜上同步上涨,信号比单榜第一可靠。
**二、分数高不等于适合你。**智能指数榜首的模型,写中文散文不一定赢过中游选手;陪聊最受欢迎的,拿去跑 agent 可能排到二十名开外。榜单量的是抽样的能力,你手上是具体的任务。真要选型,拿自己的任务让候选模型各跑十次,比看任何榜都准。这一步没有榜单能替你做。
**三、看分数前先看口径。**同一个模型,开不同推理档位就是不同的分数。收不收厂商送测、评委是谁、题库几时换,这些写各家方法论页里,翻两分钟就能知道个大概。愿意把口径公开到可以直接复现的榜,才值得花时间看。
榜首下个月就可能换人,四派测法短期内不会变。忘了谁第一不要紧。