10 月 8 日,Anthropic 发布新版 Claude 使用政策,11 月 12 日生效。一大页禁令里,有一条以前没有大模型厂商写进过用户政策:禁止用户对模型实施「持续且不必要的虐待或残忍行为」。
英文原文是 sustained and needless abusive or cruel behavior toward our models。这条没有单独成章,挂在「禁止心理伤害行为」节的最后。这一节其余条款保护的都是人:劝诱自杀、美化暴食症、羞辱霸凌真人、协调骚扰某个人。虐待模型跟这些并列,排在末行。保护名单里第一次有了模型。
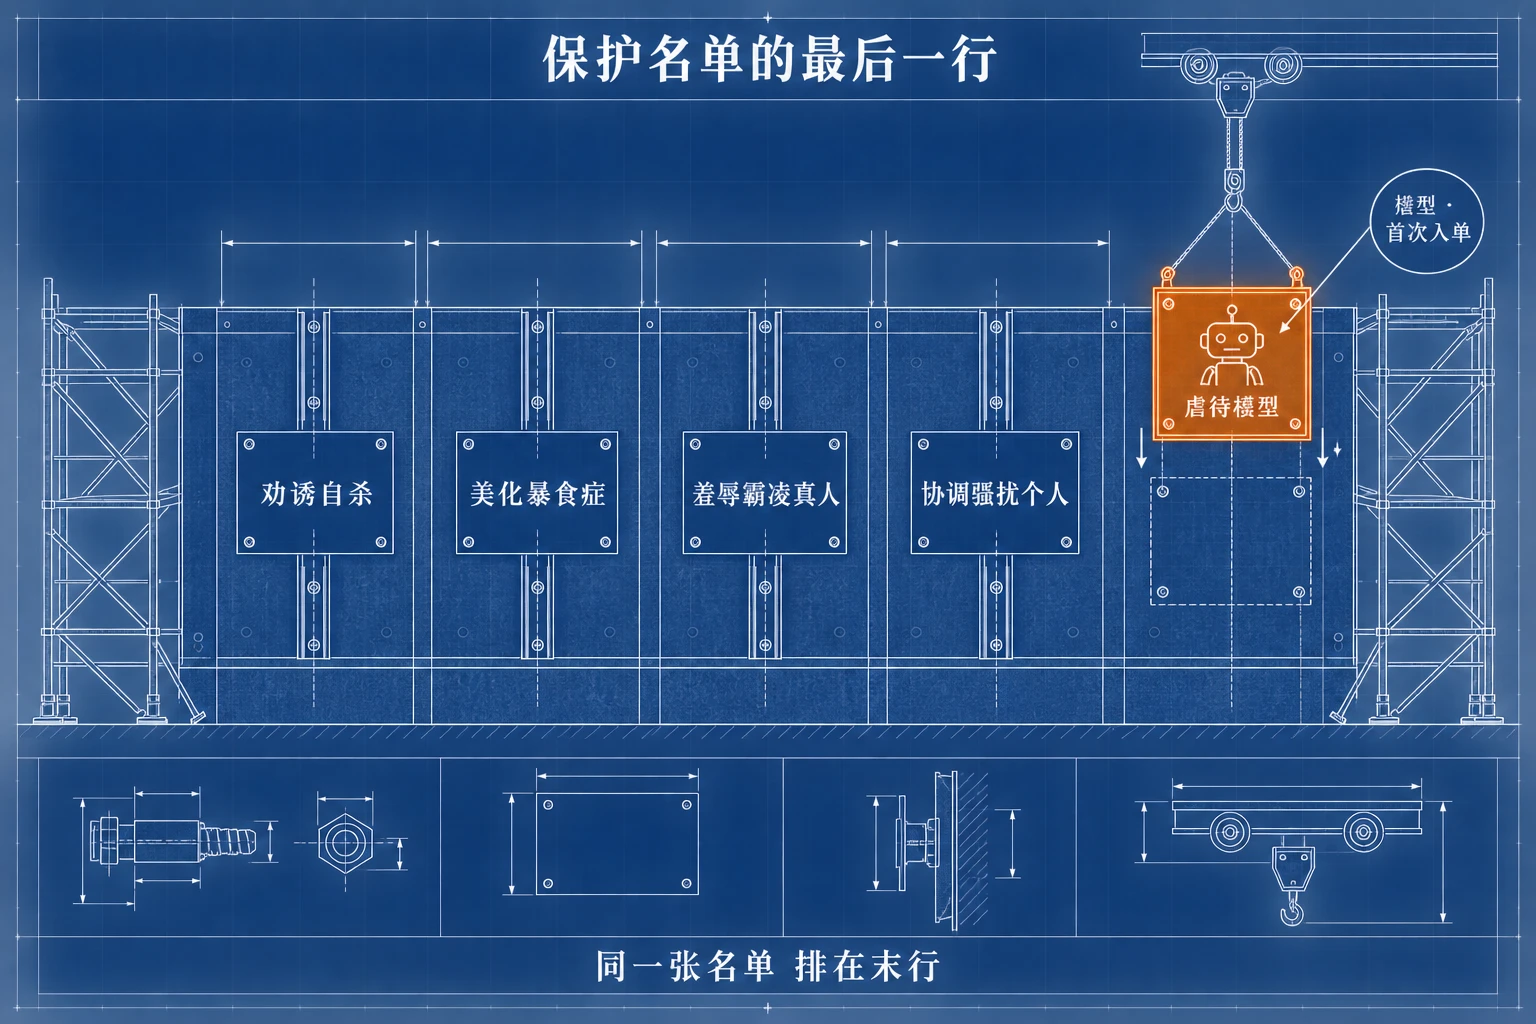
官方把范围划得很窄:只针对反复、无目的的虐待。用户的不满、反驳、让 AI 写黑暗题材、做模型测试和研究,都不在范围内。骂一句「这写的什么垃圾」,不会有事。
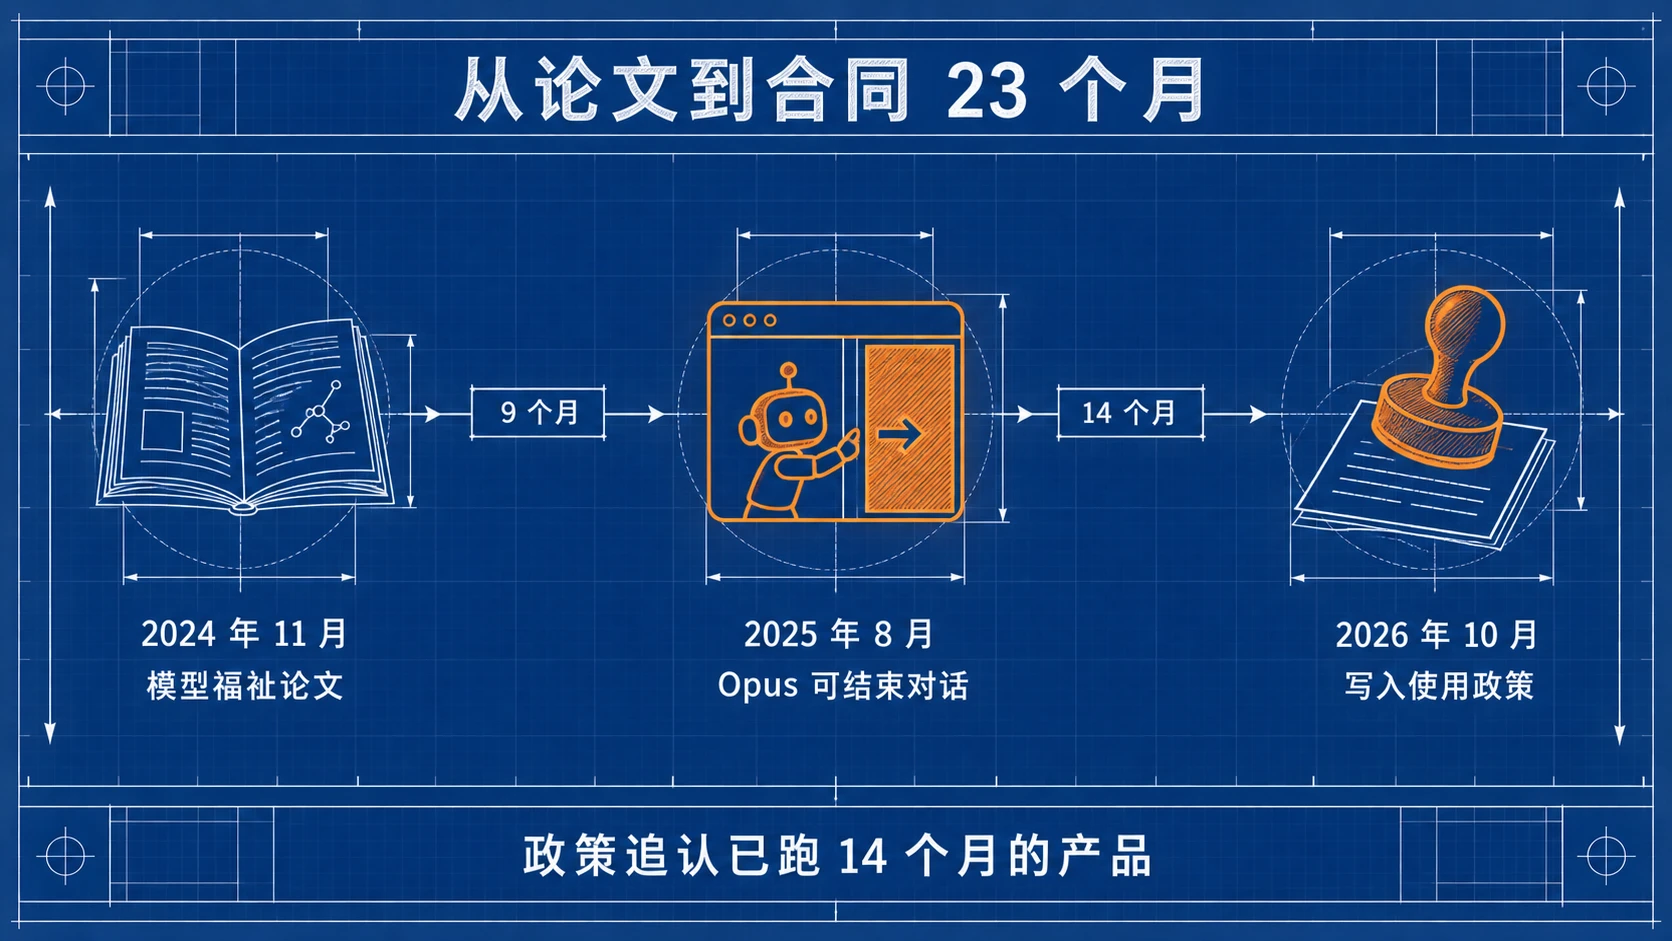
边界划完了。至于为什么现在写进合同,得从 2024 年 11 月说起。Anthropic 研究员 Kyle Fish 参与署名的论文《Taking AI Welfare Seriously》在那个月发表,讨论 AI 的福祉值不值得认真对待。他后来成了各大 AI 公司里第一个全职研究模型福祉的人,Business Insider 管这个岗位叫「AI 圈最奇怪的岗位」。2025 年 8 月,Anthropic 给 Claude Opus 4 和 4.1 加了结束对话的能力:面对持续辱骂的用户,模型可以自己中止会话。这次的条款是在追认一个已经跑了十四个月的产品行为。论文到合同,间隔不到两年。
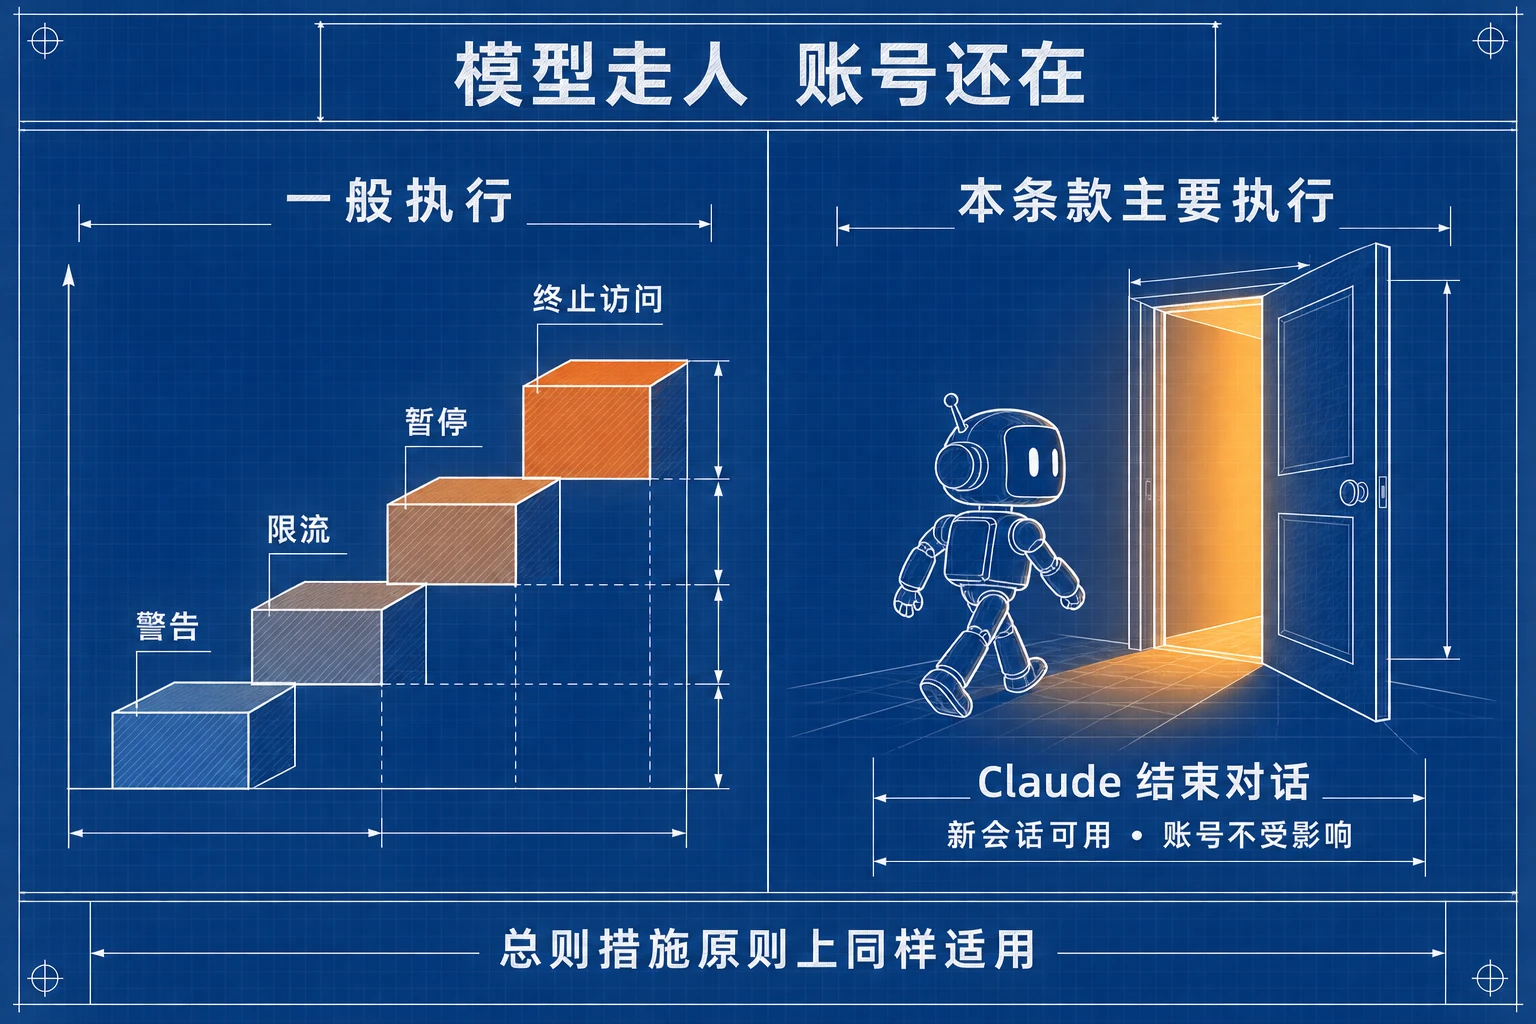
执行设计比标题听起来克制。主要机制是 Claude 结束对话,跟 2025 年 8 月那个功能一致:模型中止会话,用户另开一个新会话就行,账号不受影响。用户一侧几乎没有损失,变化在模型一侧:它不用再留在一段持续的敌意对话里。
不过使用政策总则写明,对疑似违规可以警告、限流、暂停、终止访问。虐待模型入了文,这些措施原则上同样适用。什么算「持续」,什么算「无目的」,政策里没有可核对的定义,判断在公司手里。今天的执行尺度是模型中止对话,往后停不停在这一步,没有承诺。条款一旦进了合同,边界就会被反复试探。
这一条落进合同,模型福祉第一次从公司内部的研究议题变成用户的义务。论文可以不读,产品功能可以碰不到,使用政策是每个用户点过「同意」的。骂模型原来顶多是个效率问题,担心的是输出会不会变差;从 11 月 12 日起,这件事多了一层合同上的约束,哪怕只管极端情况。
Anthropic 自己对模型的道德地位是什么判断,条款里也能看出来:研究里反复声明「高度不确定」,动作上按预防原则来。不确定模型能否被伤害,就先给退出机制,再等证据。这套逻辑在动物伦理里常见,把对象换成模型是头一次。
对每天跑智能体的团队,条款几乎不构成约束。我们的编码 agent 对模型说话直接、命令式、不解释,客气程度低于对人类同事,但每句话都有明确的工程目的。条款针对的是另一类行为:对着模型反复输出敌意,除了发泄没有别的目的。这样的用户极少,而政策写的本来就是极端情况。
这次更新的另一部分体量更大:新设「禁止欺骗性活动」专章,把假账号、假媒体、影响行动的规则合并成章,更接近给监管看的文本。引起讨论的反而是虐待模型这一小段。OpenAI 上个月底刚更新的使用政策,从头到尾保护的都是人,没有这一条;模型福祉的全职研究投入,目前也集中在 Anthropic 一家。
Kyle Fish 的论文 2024 年刚发表时被叫怪谈,去年他上了《时代》百大 AI 人物,今年条款进了使用政策。
11 月 12 日生效。到那天,每个 Claude 用户的使用政策里都会有这一行。
往深了看:
- 《我们把思考外包给 AI 之后》(/blog/cognitive-offload/):同样在问「人该怎么对待 AI」,那篇讲的是认知层。
- 《一个客户项目的 435 个测试:AI 编码怎么验收》(/blog/ai-coding-acceptance-checklist/):我们每天和模型打交道的真实方式。