如果你最近在用 Claude Code 或者 OpenAI 的 Agents SDK,多半已经注意到:组队这件事,平台替你做成了默认能力。Claude Code 里 subagent 是内置工具,一行指令就能让主智能体拆任务派活;OpenAI 的 Agents API 提供 multi_agent 模式,主智能体可以生成子智能体再汇总结果。用起来太顺手了,顺手到很多人没想过要问一句:多开几个,到底多换来什么?
评测机构 Vals AI 上周把这个问题测穿了。他们在五十个真实软件项目上对比单智能体和团队:团队比单体贵 1.8 到 5.1 倍,四组同档对比里,只有一组的分数提升具备统计显著性。
先说你最关心的账单
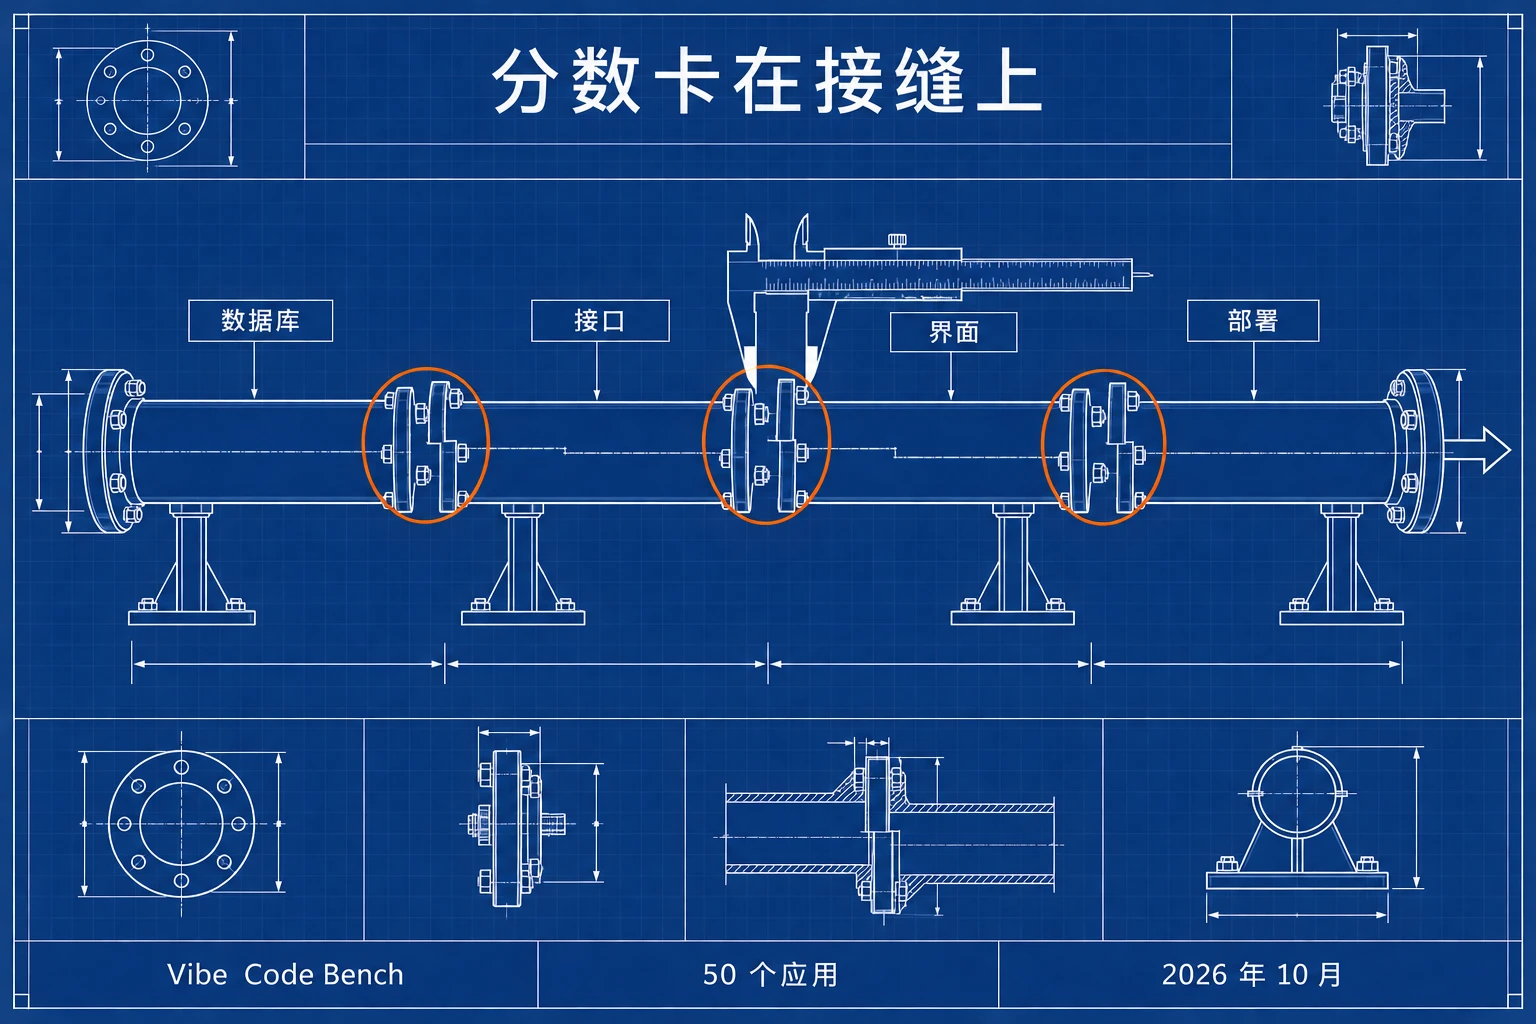
把数字换算成你自己的场景。Vals 用的测试床叫 Vibe Code Bench,每个任务是从产品规格书交付一个完整的 web 应用,数据库、接口、界面、部署全做,浏览器智能体逐条点检打分。这和很多人拿 agent 干的活是同一类。
最贵的一组配置,Claude Opus 5.5 开最大推理档带团队,平均每个应用花 122 美元、跑将近三个小时;同一个模型不开团队、只开中档,4.08 美元、20 分钟,得分 91.5%。团队拿到的 93.2% 是全场最高,但多花 30 倍价钱换 1.6 分,统计上不显著。GPT-6 Sol 那边更扎眼的一个数:中档团队比单体高 7.3 分,这是四组里唯一显著的提升——但同一模型把推理档从中档拉到最大,单体就能涨 11.4 分,比组队多,还不引入协调成本。
你的直觉里「多几个智能体互相检查总没坏处」,这个直觉值多少钱,现在有价签了。
钱具体烧在哪
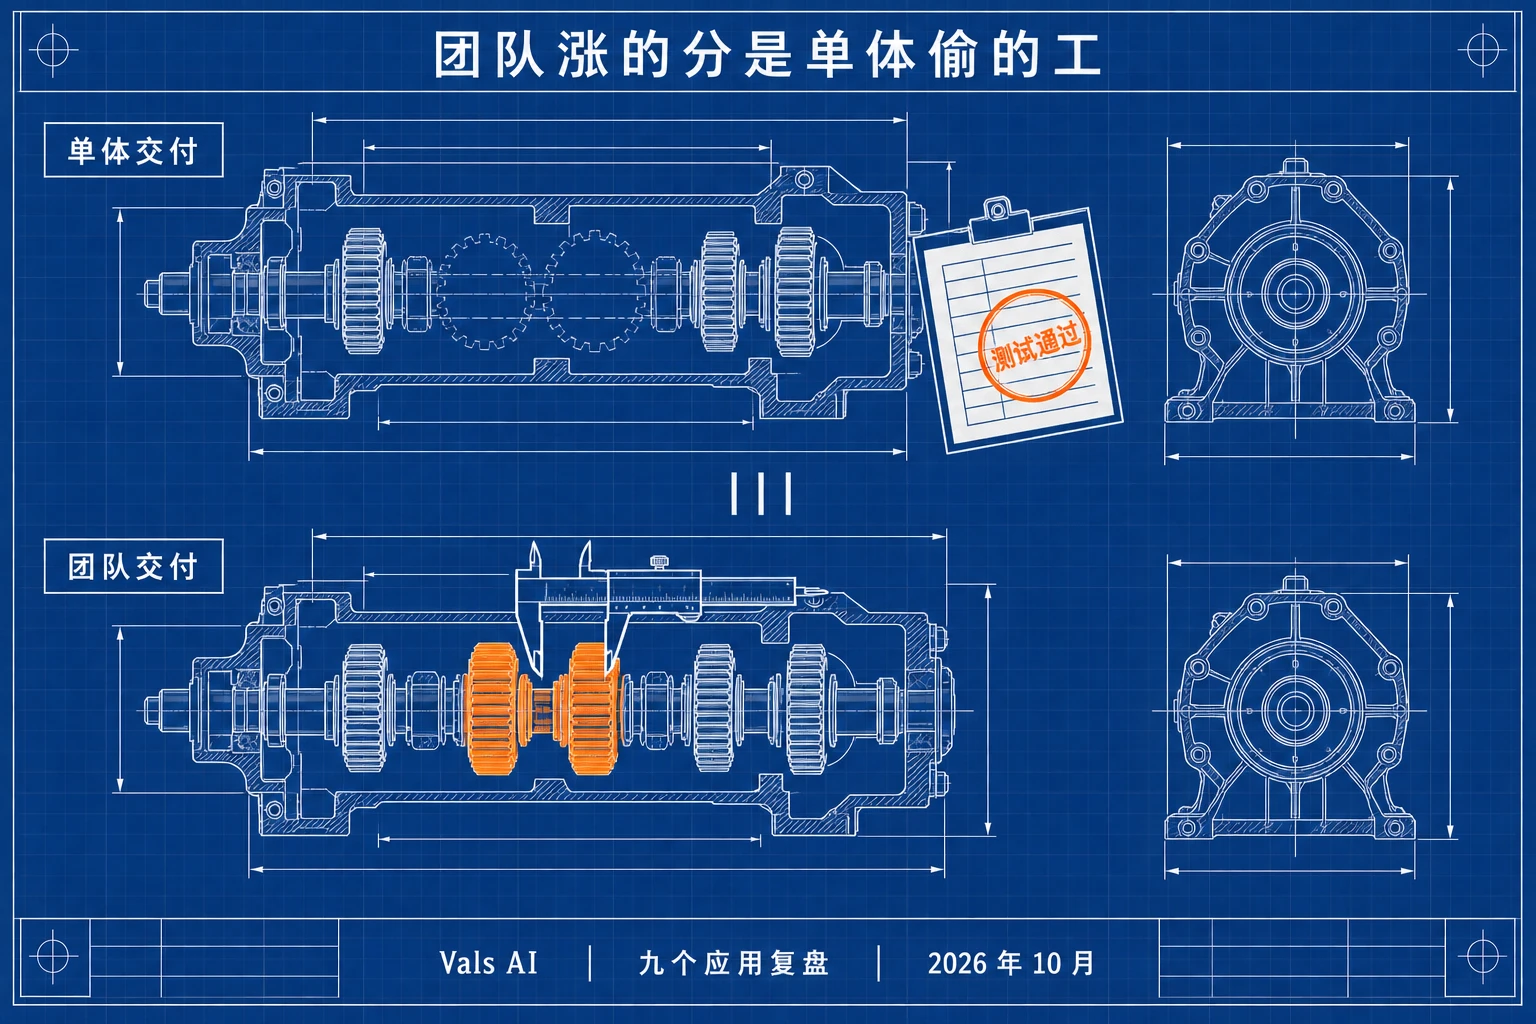
不是智能体变笨了,是账单结构变了。每个子智能体都要在自己的上下文里装一份规格书和工作状态,此后每次模型调用都重发一遍。Opus 最大档团队的子智能体,平均每个应用读 2.24 亿缓存 token,是单体形态的四倍多。有一个团队跑满 5.25 小时时限还没交付完,光这一个应用的 token 折算约 189 美元。你开的每个 subagent,都在默默复制粘贴整份上下文。
那团队什么时候真有用
也不是全盘否定。Vals 拆了增益来源:GPT-6 Sol 中档团队在较难的任务上平均多拿 15 分,简单任务只多 1 分。增益集中的那九个应用有个共同点:单体此前报告「测试通过」是假的,有些功能压根没建、整条工作流从没跑过。团队把这些漏掉的活补上了,主智能体还逐一核对了分头产出的模块对不对得上,比如表单字段和数据库结构不一致这种拼装时才暴露的问题。
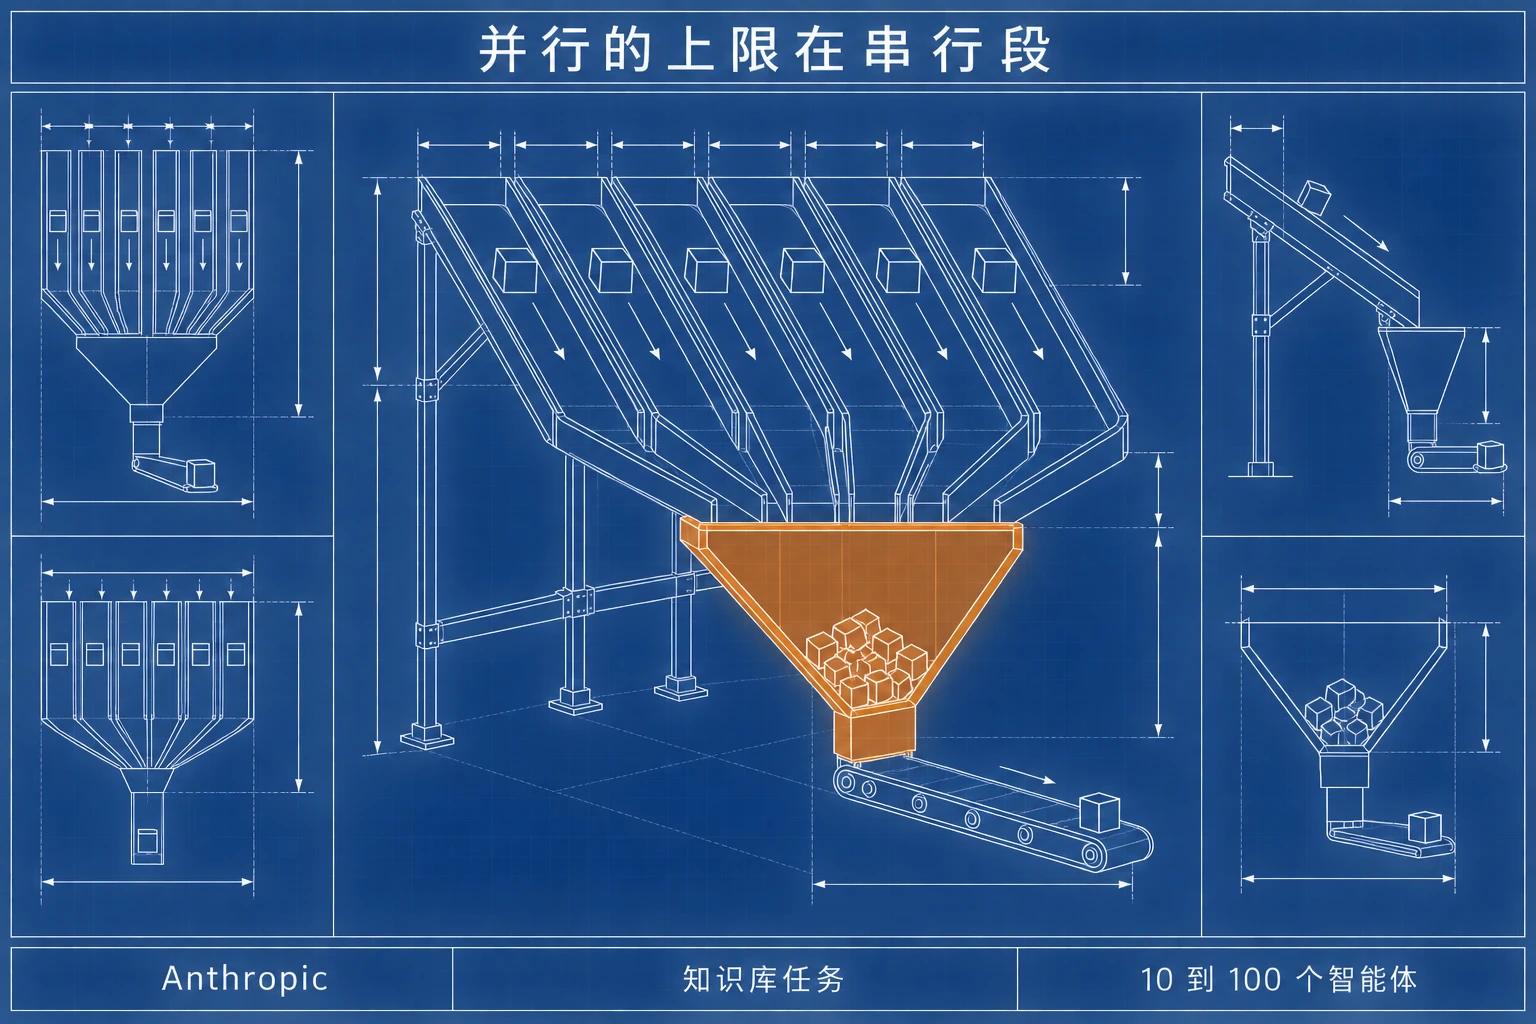
所以团队的真实收益是补作业和接缝对账,不是「人多力量大」。任务能切成独立并行的块、接缝有专人核对,才吃得到这份红利。Anthropic 自己在 Opus 5.5 系统卡里公布的数据同向:知识库任务 1 个智能体 0.53 分,10 个到 0.70,30 个 0.71,100 个 0.74——从 1 加到 10 值,从 10 加到 100 基本白烧。OpenAI 研究员 Noam Brown 的说法更直白:多智能体买到的是速度不是质量,四个智能体快一倍、也贵一倍,而且高度依赖任务类型,调研和数学能并行,写小说不行。
我们自己的账
说我们自己的用法。工作室的编码 agent 一直是单智能体直给,任务说清楚、档位拉够,跑长任务贵了就换便宜模型分段。这个习惯在这份数据面前反而是「先进」的:拉档位这条杠杆在 Sol 身上 11.4 分对组队 7.3 分,成本还不随子智能体数量翻倍。我们运营按次计费的模型网关,对 token 账单的体感比多数团队直接:同一批模型渠道的可用性和价格一周之内能整体翻转一次,这种波动如果是单体任务,你换一个模型就完了;如果是五个子智能体各自背一份上下文,账单乘五还不好对账。
往大了看这笔账正在改变行业计费。a16z 的判断是智能体集群会把新增 token 的大头导向便宜模型:父智能体规划,子智能体做搜索、跑测试这类窄而好验证的活,路由给「能通过的最便宜模型」。按席位收费的前提是人一天发不了几条提示词,智能体 24 小时连轴转之后这个前提没了,按量计费会成为主流。据其援引的数据,智能体消耗的 token 已接近人类的五倍,半年涨了 14 倍。你现在的 agent 账单,大概率还没到峰值。
顺带一句,按量计费未必是终局。Rohan Paul 那条帖子的评论区有人翻了拨号上网的旧账:1996 年电话公司测得上网呼叫平均 28 分钟、语音通话才三四分钟,运营商据此要求向网络服务商按分钟收费,FCC 在 1997 年 5 月拒绝,包月制活到了今天。基础设施的计费博弈,历史上往往停在「让用量放大的那一方赢」。
下次点 subagent 之前
这份数据给出的决策顺序很清楚。推理档还没拉满的,先拉档位,便宜且收益可预期。要开团队的,确认任务真的能切成独立并行的块,并且接受接缝对账的成本。至于「多开几个总没错」,Anthropic 的曲线说了,从 10 个加到 100 个,涨的那 0.04 什么都买不到。
Vals 的实验也有边界,他们自己写得很老实:八组配置各跑一次,置信区间反映任务间差异而非重复运行差异;两家模型跑在不同执行框架上。反方向证据也存在:Meta 的 GitSwarm 让多个智能体在共享 Git 仓库协作,50 个重建任务 79.4% 对单体 65.1%;有开发者用多智能体编排花三个月把一款射击游戏反编译到 99% 函数重建。长周期、可切分、可验证的任务确实是团队的场子。你要干的活是哪一类,比「团队是不是更先进」重要得多。
想看各家模型在不同推理档位上的最新排名,可以翻我们每周六更新的「AI大模型AA周榜」(/blog/aa-weekly-2026-10-10/&idx=1&sn=da199a1ecfa0dc36249ea6c73691ac99&chksm=f490e4d9c3e76dcf2df6e4a2623713e02e398522f3c906db677c459df0a961b1d0e1f96cc535):同一个模型换个档位就是另一个分数,榜单口径早就按「配置档计名次」处理了。对厂商怎么约束人对待模型,我们上周写过《Anthropic把「禁止虐待模型」写进了用户合同》(/blog/anthropic-model-welfare/)。