写代码的终端里现在不止一个 AI 助手,Claude Code、Codex、Gemini CLI、Kimi Code、Qoder,装着装着就十几个了。工具多本来是好事,四个麻烦跟着来。
模型被锁死在各自生态里。Claude Code 只认 Anthropic 的接口,想让它跑 Kimi 或 DeepSeek 的便宜模型,官方不支持;Codex 只认 OpenAI 的协议,反过来一样。Agent 出厂绑了谁家,就只能用谁家。
订阅不能跨工具。Claude Pro 的钱付了,模型只在 Claude Code 里能用;ChatGPT Plus 只在 Codex 里生效。换一个 Agent,同一个订阅就作废。
配置文件各自为政。模型设置散在十几个文件里,格式互不相同:settings.json、config.toml、config.yaml。模型厂商一周一个新版本,想换模型就挨个文件改。
额度一断就停工。账号余额用完或被限流,Agent 把报错直接甩到终端里,你停下来换 key、改配置、重开会话。
magpie 就是冲这四件事来的:一个跑在本机的开源应用,把所有 AI 编程助手的模型请求收进同一个本地网关,统一翻译协议、分配模型、调度账号、记账。MIT 协议,Go 编写,GitHub 一万一千多 star;作者 yetone 是 Neovim 生态里最流行的 AI 插件 avante.nvim 的作者。我们写稿这天它还在发版,仓库已经累积三千二百多个提交。
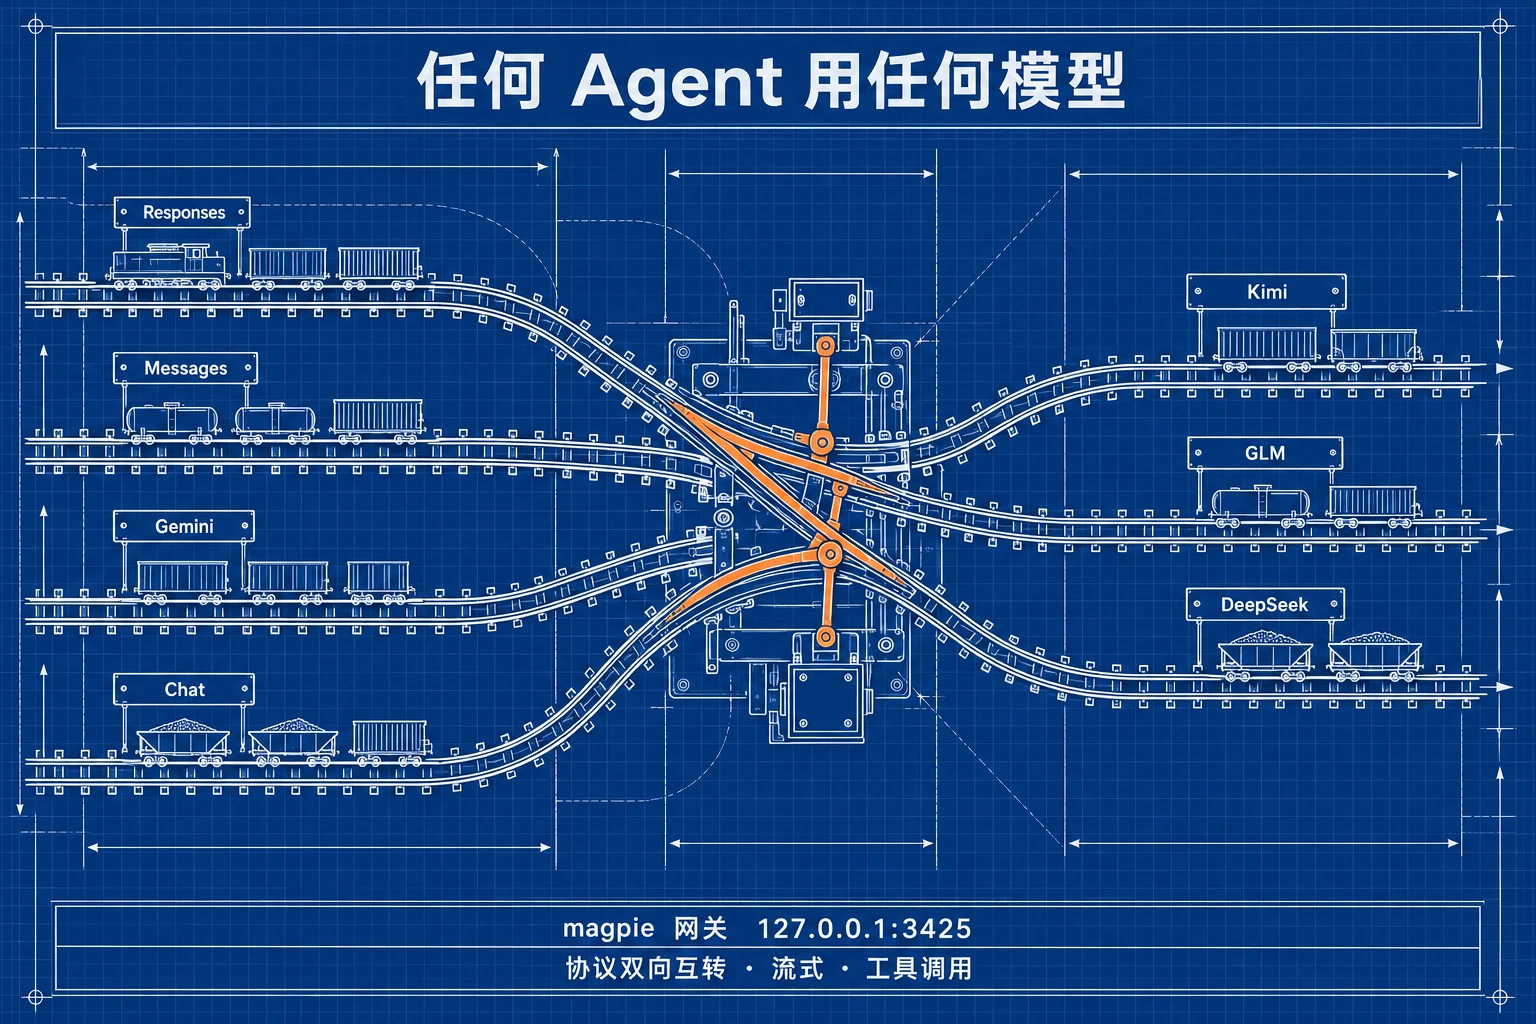
功能一:任何 Agent 用任何模型
网关默认监听 127.0.0.1:3425,同时说四种协议:OpenAI Chat、OpenAI Responses、Anthropic Messages、Google Gemini,两个方向互相转换,流式输出、工具调用、推理过程都在内。协议这层墙拆掉之后,Claude Code 的 opus、sonnet 背后可以换成 Kimi,Codex 的模型列表里可以出现 DeepSeek,Gemini CLI 可以跑 GLM。
官方支持的 Agent 列表五十八个,magpie 扫描机器上装了哪些就列出哪些。不在列表里的工具,只要能设 base URL,指到网关就能用。
功能二:一张表管完所有 Agent
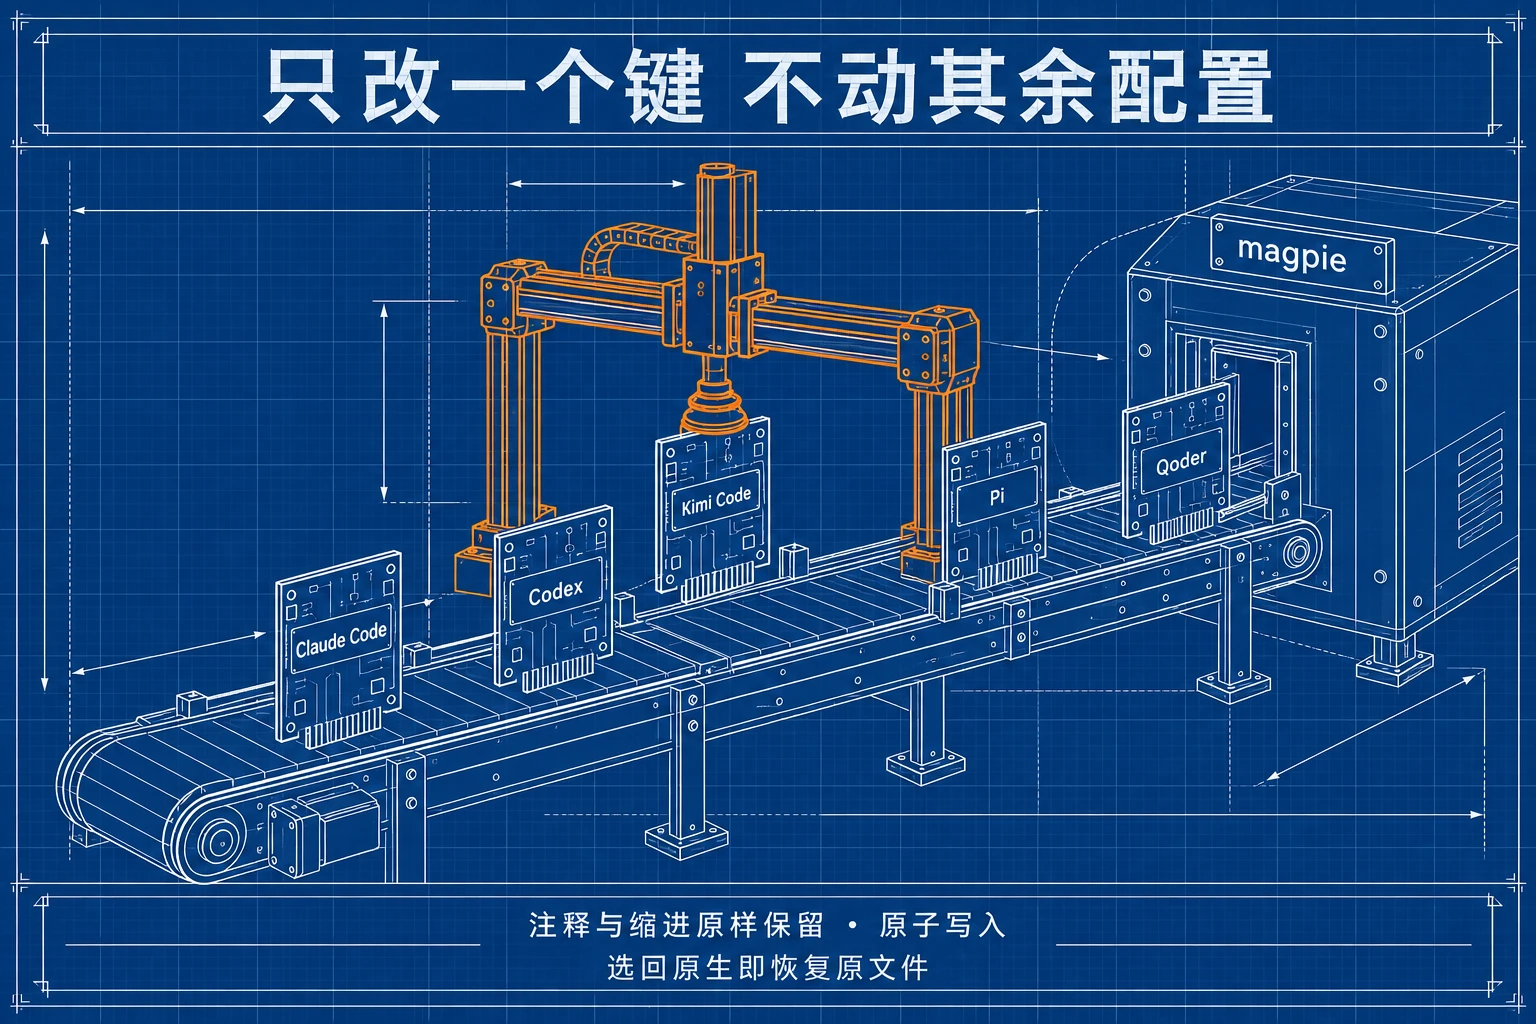
面板上每个 Agent 在用什么模型一目了然,点一下就换。magpie 只改写那个 Agent 配置文件里该改的那一个键,注释、顺序、缩进原样保留,写入是原子操作;选回原生模型,配置原样恢复。我们敢让主力 Agent 全程走它,靠的就是这个细节:配置文件里还有别的设置,一个保留注释缩进的改写器和一个整文件覆盖的改写器,是两种信任程度。
功能三:订阅变成供应商
在某个 Agent 里登录过订阅——Claude Pro/Max、ChatGPT Plus/Pro、GitHub Copilot、Gemini、Grok——这个登录就在 magpie 里变成一个供应商,它的模型出现在其他所有 Agent 的选择器里。不复制密钥,令牌按原来的方式刷新。官网给的例子:用 Claude Code 的登录驱动 OpenCode,用 Codex 的登录在 Claude Code 里跑 GPT。
功能四:路由组,额度不断供
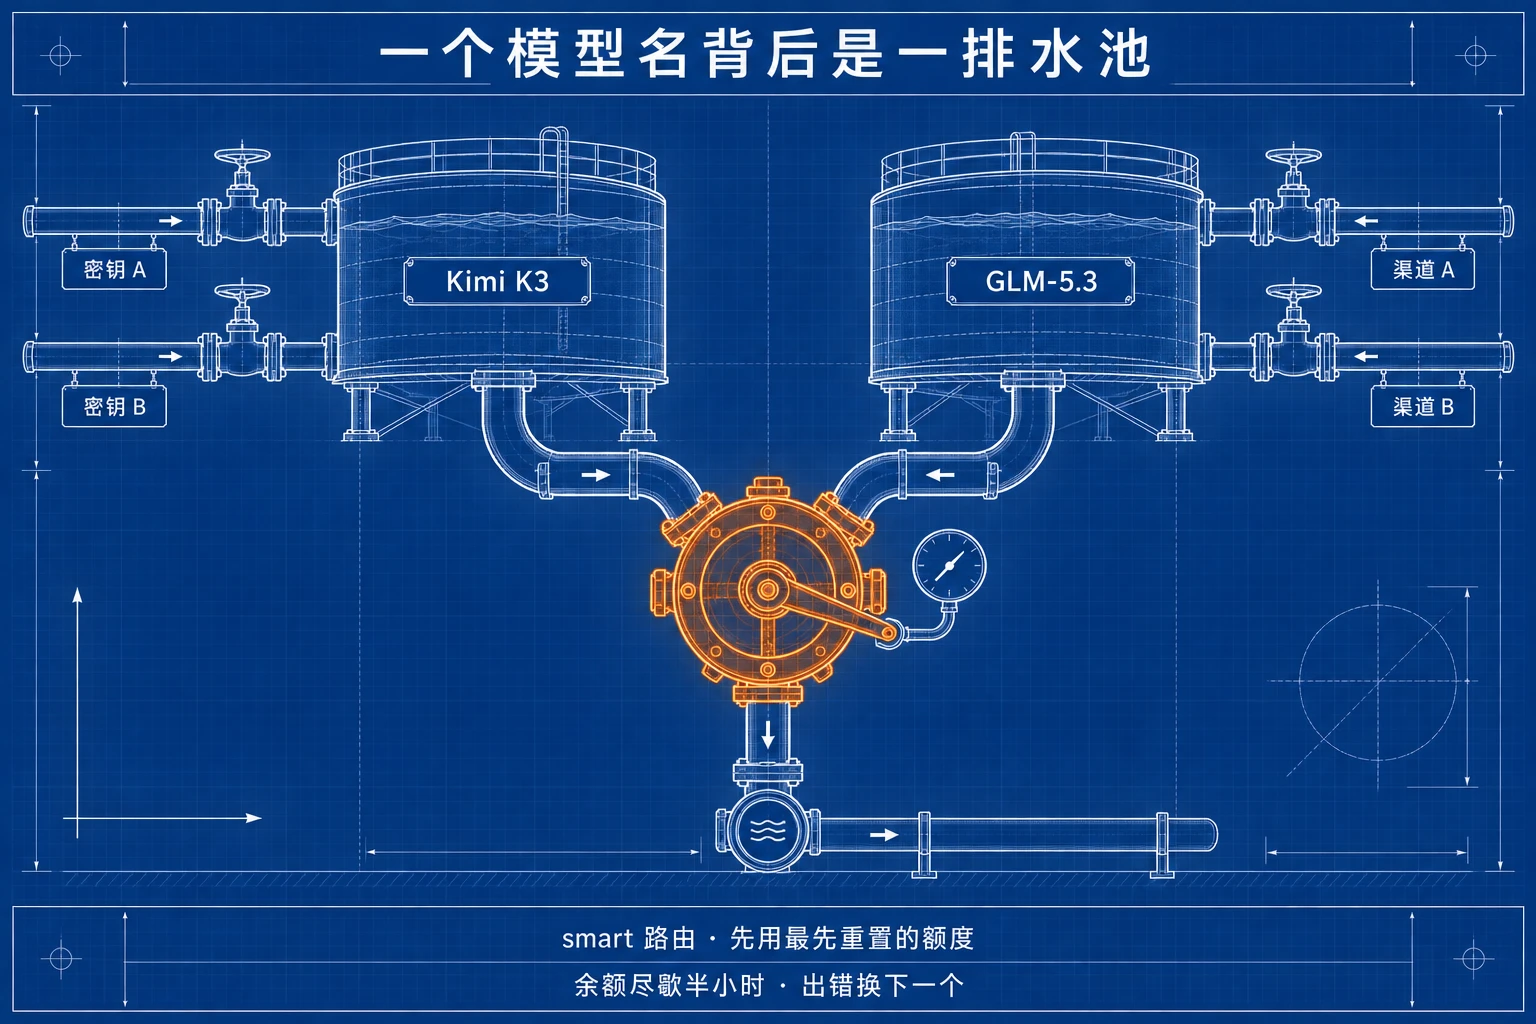
把多个模型或多个账号组成一个「路由组」,Agent 眼里它就是一个模型名。调度模式五种:smart 用额度最先重置的账号,让重置时会作废的额度最少;order 用到不能用换下一个;rotate 每轮换一个;usage 挑用得最少的;pace 按周额度配速匀着用。
账号出事时:余额耗尽的账号歇半小时;被限流的按厂商响应头给的时长跳过,不瞎猜也不硬撞;出错的账号逐次退避,请求在 Agent 看到报错之前就换下一个账号重试。过去三十天我们经网关 9397 次调用,155 次错误里 35 次被重试接住,Agent 全程无感。
再细一层是按意图分流:给每类活指定模型,「简单提问」给便宜模型、「写测试」给代码强的,每轮对话开始时一个小而快的模型先分类,这轮就交给对应模型,后续工具调用也留在那里。
功能五:账单和延迟都看得见
用量页按 Agent、模型、上游账号、会话四个口径记账:token、缓存命中、费用、首 token 延迟。密钥只存在 magpie 里,它不读环境变量里的 key,Agent 侧永远只看到网关地址。
我们跑了三十天的账
这台机器上装了十五个 Agent,magpie 扫描后面板一列全:Claude Code、Codex、Kimi Code、MiniMax Code、Qoder,到 WSL 里的两个配置文件。目前真正把流量交给网关的是主力助手和常驻终端助手两个,其余的配置已在表里,随时点一下就能切进来——收编是渐进的过程,我们没有一口气全接。主力助手指向一个路由组:GLM-5.3 两个渠道、Kimi K3 两个渠道,smart 模式互备;子代理和杂活走另一个由五个便宜模型组成的 flash 组;长会话的上下文压缩固定指给 GLM-5.3。上游四个 Kimi Code 账号全挂上。
三十天经网关 58M token、9397 次调用,按牌价约 1700 元人民币,其中 4262 次调用的模型没有公开牌价,未计入。模型分布:GLM-5.3 占 46%,MiniMax Flash 预览版占 27%,Kimi K3 占 23%,主力和杂活分层,符合路由组的设定期望。
两个数字比总额有信息量。首 token 延迟:GLM-5.3 实测 14.6 秒,MiniMax Flash 3.5 秒,相差四倍。这类数字以前只能靠体感猜,现在哪个账号最近变慢了,一眼能看到,换掉它不需要更多理由。缓存命中 845M token,是输入输出总量的十几倍。编程 Agent 的上下文大头是反复重发的历史,这个结构决定了在网关侧做统计和调度,比在任何单个 Agent 里都看得全。
三个边界
网关必须活着。它是所有请求的必经之路,它没起来,指向它的 Agent 就一起失联。好在这不是一个需要伺候的进程,装好之后我们基本没再管过。
它不接管一切。各 Agent 直连自家服务的流量,magpie 统计得到但路由不到,我们还有 227M token 的调用没走它。
隐私上,它每天向官方发一次匿名上报,内容是随机 id、版本和用了哪几类 Agent,设置里可以整个关掉。
什么人需要它
官方的判断标准写得诚实:用一个以上的 Agent、一个以上的供应商、一个以上的账号,三条沾任何一条就有用;单 Agent 单订阅、厂商自己的套餐够用的,不需要它。我们的场景三条全占。
macOS 版约 15MB,系统 WebView,没有 Electron;Windows 是一个 50MB 的单文件 exe。官网 usemagpie.ai,源码在 GitHub 搜 yetone/magpie。这篇稿子的初稿,就是经它的路由组写出来的。
模型怎么选、手感变了怎么应对,可以看我们之前写的《主力模型手感突变,Kimi在憋什么大招》;token 花在哪里值不值的账,可以看《Vals AI实测多智能体:token多烧五倍,分数没涨》。这个号写我们真实跑过的工具和数据,跑不通的也会把原因摆出来。