数据取 Artificial Analysis 智能指数 v4.3.2(10 项评测加权,205 个模型在榜),抓取于 2026-10-09。榜单按配置档计名次,同一模型多档位(max/xhigh/high/medium/low)各占一名;单任务成本为最高推理档位每任务价格。
总榜前 50
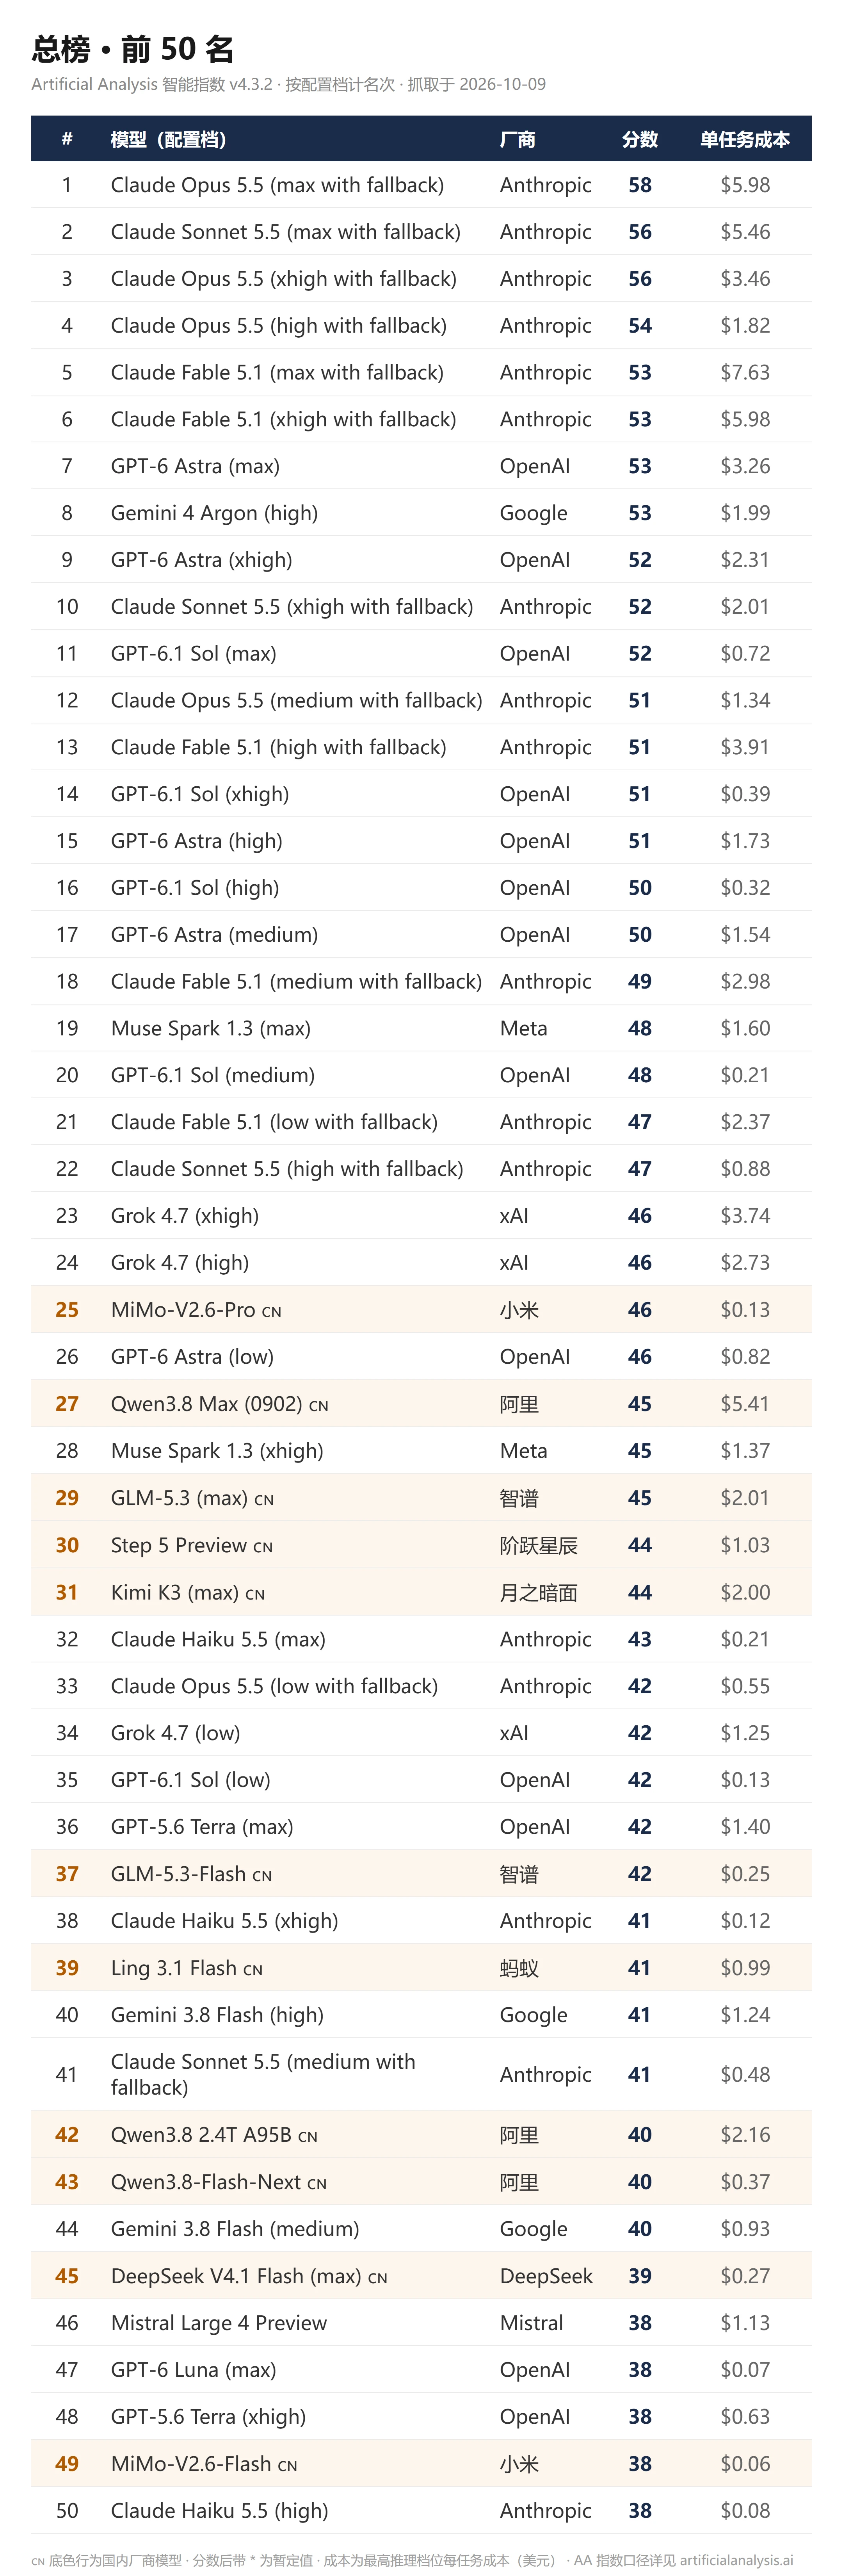
榜单本体一句话就能说完:前三名被 Anthropic 一家包圆,52 分以上只有六家模型,全部是海外厂商。
国内段:46 分天花板,和它下面的梯队
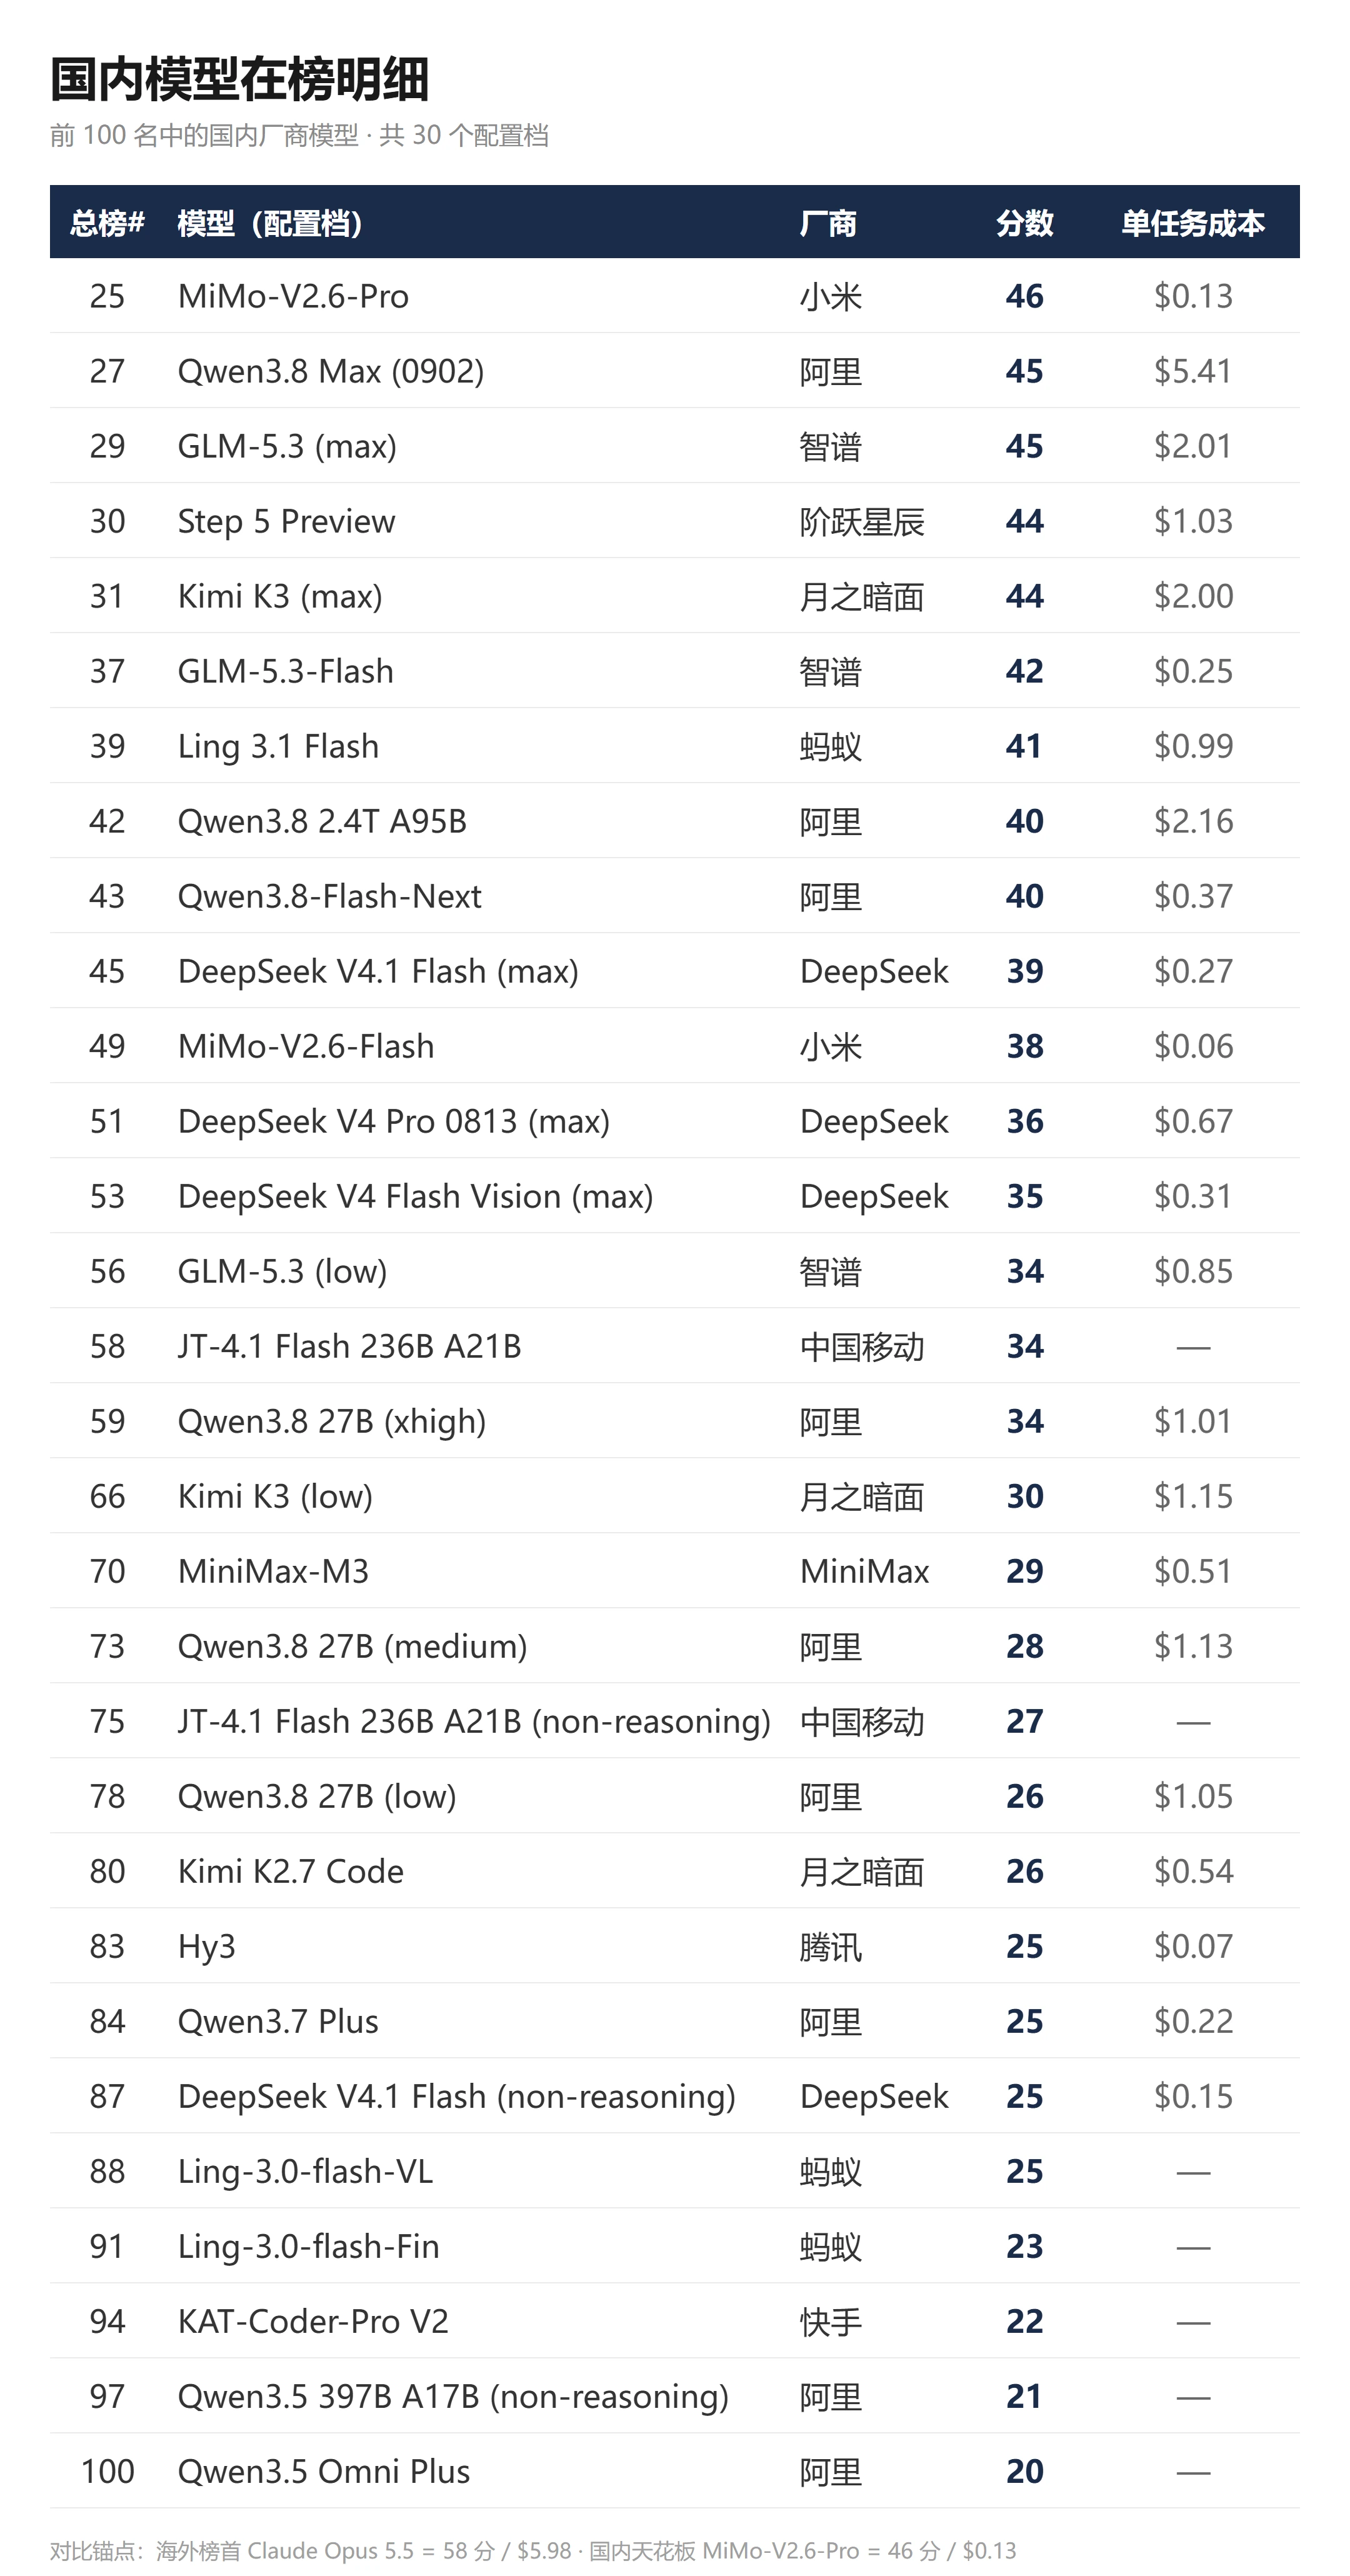
国内模型本期在榜 24 款、30 个配置档,按去重名次分布:
- 46 分档(第 9 名):MiMo-V2.6-Pro,目前国内唯一摸到总榜前十的模型,也是全球开源权重榜首;
- 44-45 分档:Qwen3.8 Max(45)、GLM-5.3(45)、Step 5 Preview(44)、Kimi K3(44);
- 39-42 分档:GLM-5.3-Flash(42)、Ling 3.1 Flash(41)、Qwen3.8 2.4T(40)、Qwen3.8-Flash-Next(40)、DeepSeek V4.1 Flash(39);
- 38 分以下:MiMo-V2.6-Flash(38)、DeepSeek V4 Pro(36)、DeepSeek V4 Flash Vision(35)、Qwen3.8 27B(34)、MiniMax-M3(29)、Kimi K2.7 Code(26)、腾讯 Hy3(25)、中国移动 JT-4.1 Flash(34)等。
差距本身是清楚的:海外榜首 58 分,国内天花板 46 分,12 分的绝对差,前 24 名里没有一个国内模型。但国内段有两个数字同样值得记住。一是价格:MiMo-V2.6-Pro 用 $0.13 的单任务成本拿 46 分,Opus 5.5 用 $5.98 拿 58 分——四十六分之一的价格,换七九成的分数。二是海外的动作:Anthropic 本周刚发的 Haiku 5.5 拿 43 分、单任务 $0.21,直接插进了 GLM-5.3-Flash(42 分/$0.25)的价格带。山顶的差距没有缩小,性价比段的优势却开始被贴身盯防,这是国内阵营本期最值得注意的一个信号。
近 30 天的山顶变化(首期代替「本周变动」)
首期没有上周快照可比,改用日报档案回填一个月的山顶史。9 月 23 日 Claude Opus 5.5 发布即登顶;9 月 29 日 Sonnet 5.5 以 56 分升至第 2,当时评语是「仅次于 Opus 5.5」;9 月 30 日 Gemini 4 Argon 上榜时 53 分,「距 GPT-6 Astra 仅 1 分」。两周之内,52 分以上的模型从 Astra 一家扩到现在的六家。
同一时期国内侧的动作:9 月 22 日 MiMo-V2.6-Pro 以 46 分登顶开源权重榜首,把国内天花板从 DeepSeek V4.1 Flash 的 40 分抬到 46 分。也就是说,过去一个月海外榜首从 53-54 涨到 58,国内天花板从 40 涨到 46,绝对差维持在 12 分上下,真正变化的是高分段的密度——海外在把「山顶」修成一个俱乐部,国内还停在门口。
榜上的国产模型,哪些今天就能买到
榜单是分数,买到是另一回事。我们自用的模型网关本周在架的国产模型有六个系列,对照榜单名次如下(可用性为 2026-10-09 复核):
- GLM-5.3(总榜 11)与 GLM-5.3-Flash(15):在架且稳定,日常主力;
- Kimi K3(12):在架且稳定;
- MiniMax-M3(总榜 29 分档):在架稳定,但分数和旗舰档差距在任务里能直接感觉到;
- 豆包 seed-2.0 系列(未进 AA 榜):本周恢复可用,一周前还全部超时断连——渠道状态的翻转就发生在七天之内;
- DeepSeek V4.1 Flash(总榜 39 分档):渠道持续报错,超一周不可用;
- Qwen3.8 Max(总榜 10)与 Qwen3.8 Flash:本周双双报错,而 Flash 一周前还是好的。
六个系列里两个处于不可调用状态,一个刚活过来。榜单上的 45 分、39 分是理想值,落到管线上还要再打一道渠道折扣——分数是上限,可用性是下限,两个都得看。