10 月 24 日凌晨,月之暗面正式发布 Kimi K3.1 Pro。四天前,我们还在《国产模型「消失」的七周》里写它「只闻其声」,今天,这个观察点兑现了。
官方给它的定位是 K3.1 系列的第一个模型、K3 的后训练版本,参数规模为 3 万亿级,支持 100 万 token 上下文。同步上线的还有 Kimi K3.1 Pro Highspeed,官方称同等智能、输出速度约为普通版的 2~3 倍。完整权重尚未发布,官方承诺的时间是 11 月 4 日前,许可证也要等权重落地后再看。
这篇稿子本身就是用 K3.1 Pro 写的,我们做了事实核查和修改。这不算标准化实测,却是一次真实内容任务。文章的结构和文字就摆在这里,读者可以直接判断它做得怎么样。
把官方技术博客和 Artificial Analysis(AA)的独立评测放在一起,最清楚的信号是:这次的主要增量集中在 Agent 任务,尤其是长程编码和工具调用;知识、科学推理等项目也有提升,但幅度没有那么整齐。
后训练加码,Agent 成绩涨得最明显
K3.1 Pro 不是以一套新架构亮相的。官方明确说它是 K3 的后训练版本,这次大幅增加的是后训练算力,并围绕数百个下游领域做大规模联合强化学习,配套的改动落在 RL 框架、长上下文推理、沙箱基础设施和调度系统上。100 万 token 上下文也不是新增能力,K3 本来就有。
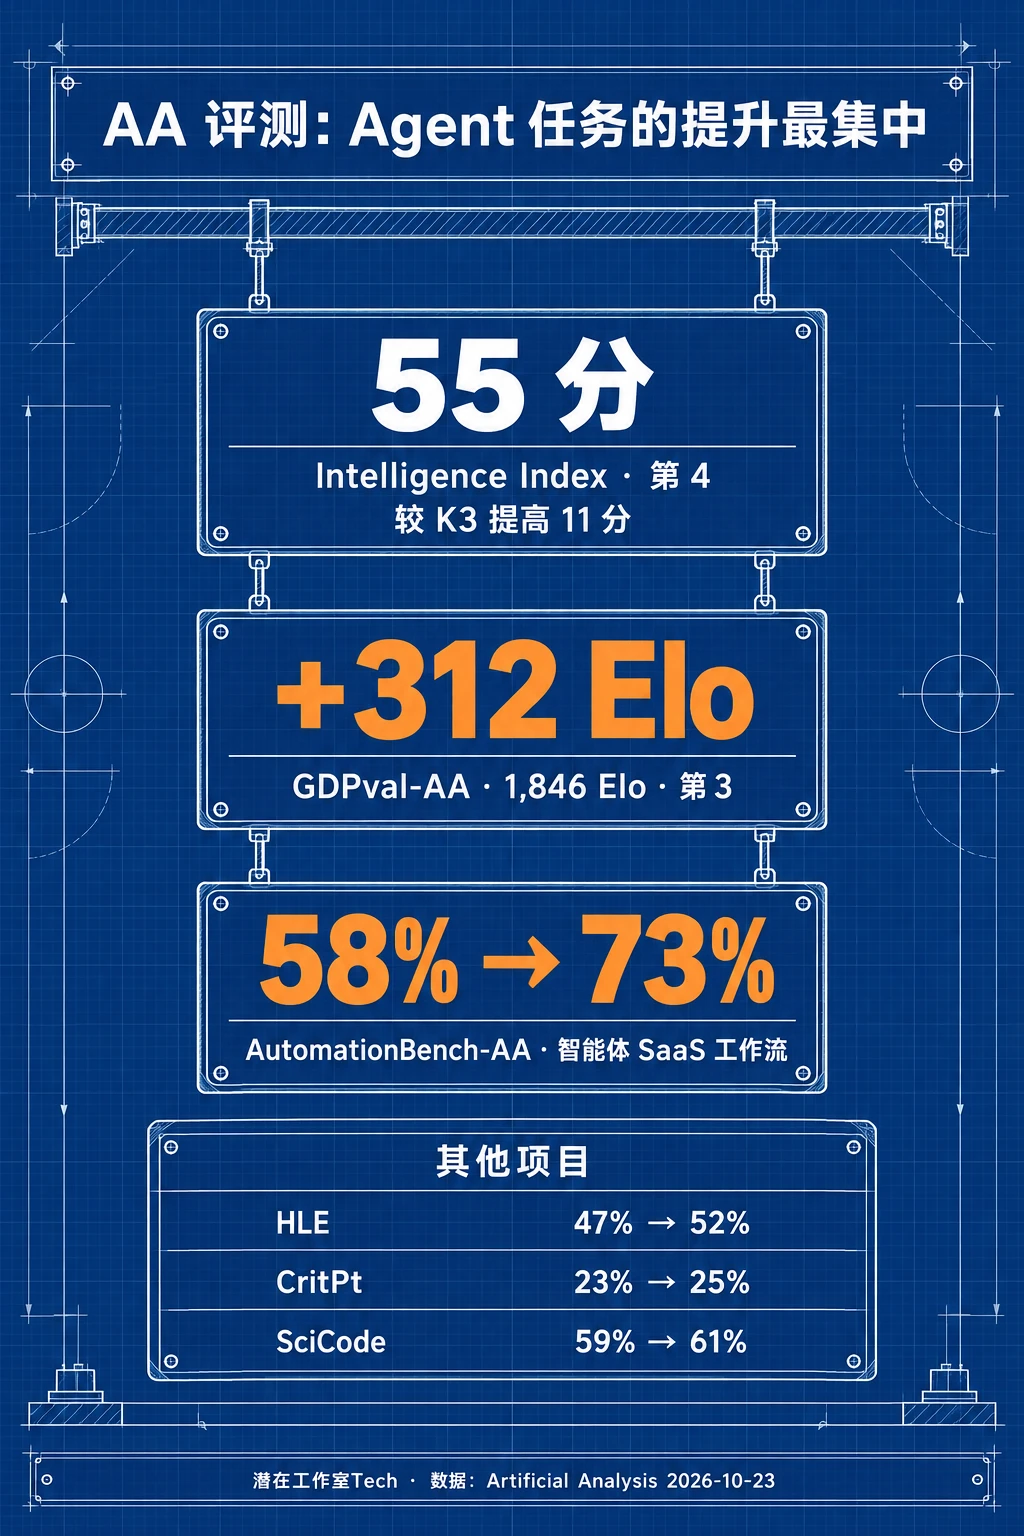
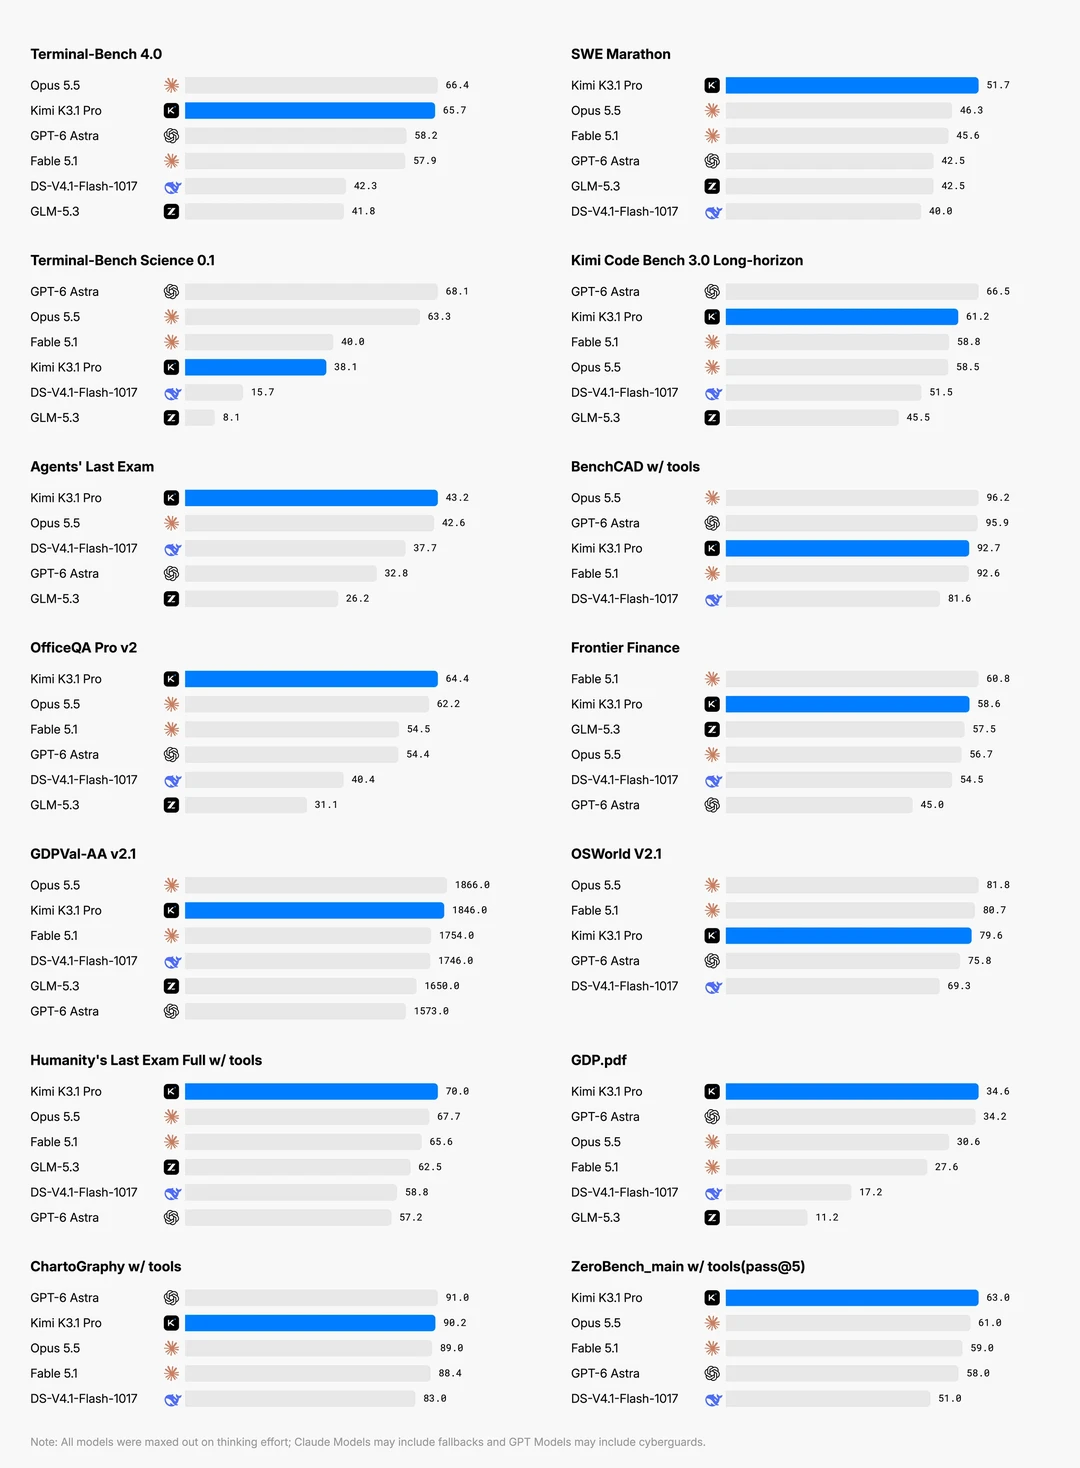
AA 的独立评测能看出后训练投入主要转化到了哪里。K3.1 Pro 的 Intelligence Index 得分是 55,位列总榜第 4,比 K3 的 44 分提高 11 分,排在它前面的只剩 Claude Opus 5.5、Claude Sonnet 5.5 和 Muse Wonder Full。拆开分项,GDPval-AA 达到 1,846 Elo,比 K3 增加 312,位列第 3;考察智能体 SaaS 工作流的 AutomationBench-AA 则从 58% 升到 73%。
其他项目的增幅相对温和:Humanity’s Last Exam 从 47% 到 52%,CritPt 从 23% 到 25%,SciCode 从 59% 到 61%。所以,总分提高 11 分并不表示每项能力都同步跨了一级,Agent 相关任务才是这次提升最集中的地方。
从 3D 到行走仿真,官方案例都在考长程执行
官方这次给了不少 3D 案例,但比成品效果更值得关注的是完成方式。K3.1 Pro 可以不依赖 MCP 连接器,直接编写并运行 Blender、CAD 等专业工具的脚本,完成建模、修改部件、调整材质和场景布局。它调用的仍然是专业软件,模型负责把任务拆成代码和工具调用,再把结果交付出来。
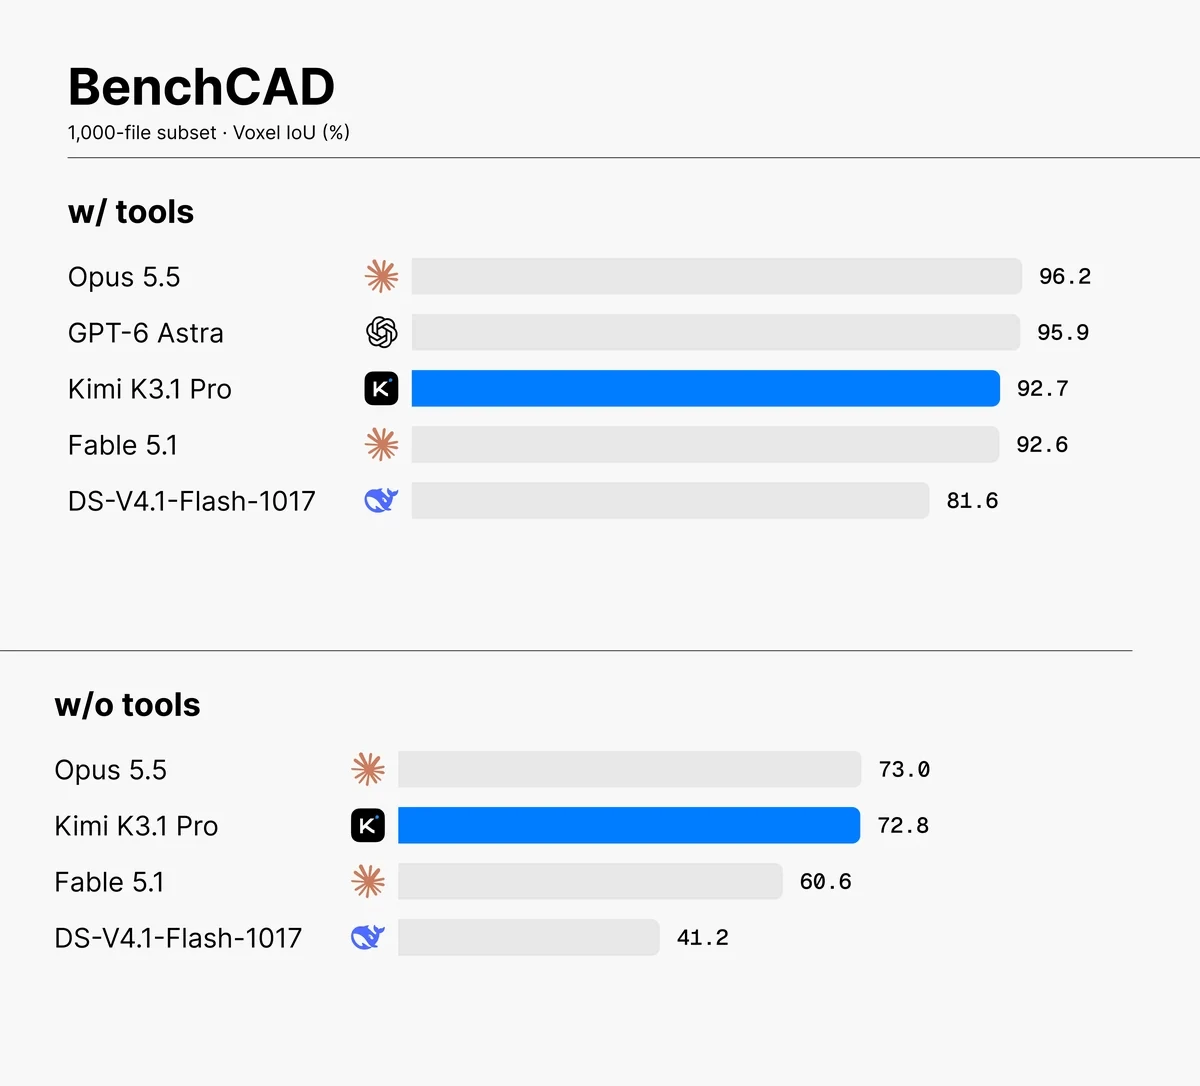
BenchCAD 的成绩也体现了工具的作用。这项测试要求模型根据多视角渲染图生成 CAD 代码,重建 3D 模型。K3.1 Pro 带工具时得分 92.7,不带工具时是 72.8;带工具的成绩低于 Claude Opus 5.5 的 96.2 和 GPT-6 Astra 的 95.9。工具链不是评测之外的包装,它已经直接影响模型能交付什么。
另一个内部测试更接近长程工程任务。K3.1 Pro 基于开源人体解剖模型搭建行走动力学仿真器,在 167 项任务、420 次独立评审中持续修改控制器,让仿真人体从几步内倒地进步到连续行走 11.2 秒。手臂运动在调整奖励机制后仍没有改善,它转去检查仿真器动力学,最后修正了肩部肌肉力臂计算中的 36 处错误,再重新训练控制器。
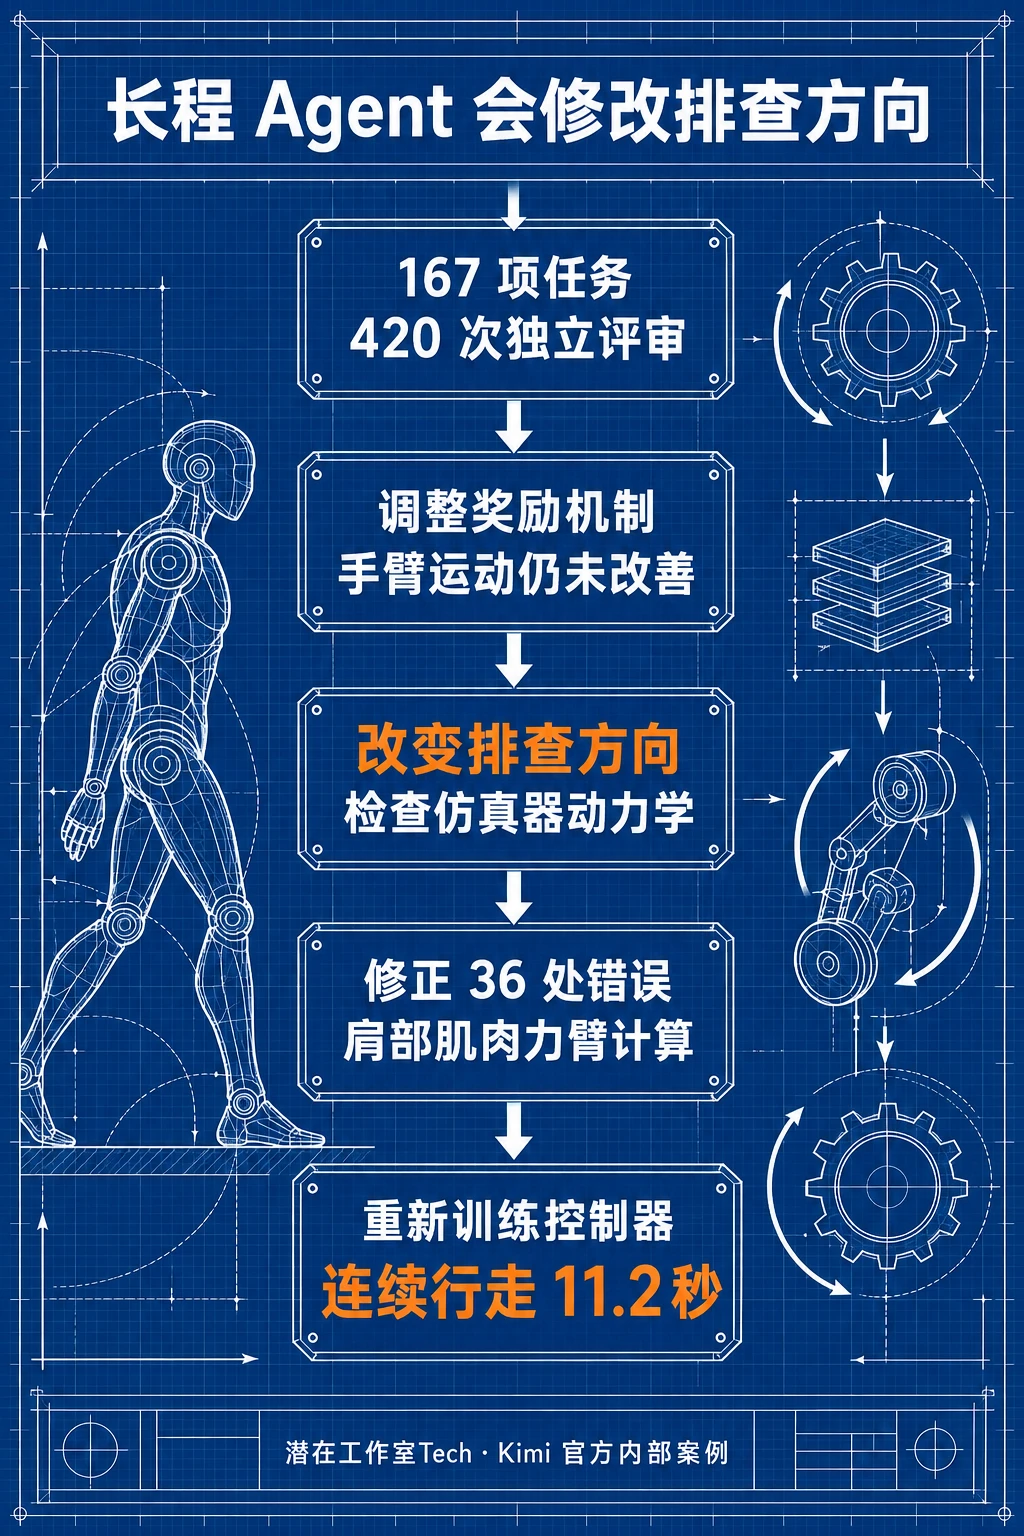
这些仍然是官方案例,不能代替独立复测。不过,案例里呈现的工作方式很具体:模型不只生成一段答案,还要读实验结果、改变排查方向、修改环境代码,再继续训练。官方把大量篇幅放在这类过程上,与 AA 分项里 Agent 能力的涨幅正好指向同一个方向。
同一个基准,先别急着把分数拼在一起
K3.1 Pro 的 Terminal-Bench 4.0 成绩有两个公开数字。Kimi 官方技术博客写的是 65.7%,超过 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;AA 自己评测得到的是 67%。两个数字来自不同评测方和评测设置,不能写成互相印证,也不宜混成一张没有来源标注的对比表。
官方脚注还说明,K3.1 Pro 在这项测试中使用了 Claude Code harness,其他模型的分数则取自各自发布材料或官方榜单。这组官方成绩适合用来看厂商自报的能力位置,不等于所有候选模型都在同一套环境里由同一方复测。
Kimi Code Bench 3.0 Long-horizon 也需要单独标注。它是月之暗面的内部基准,K3.1 Pro 得分 61.2%,K3 为 55.95%,可以用来观察同一家内部口径下的代际变化,但不能直接外推成对其他模型的领先幅度。
这也是本文把官方成绩与 AA 成绩分开写的原因。模型发布时的「第一」「接近」和「超过」,只有连同评测方、测试版本、harness 和比较对象一起读,才有实际意义。
API 降价了,任务成本没有同步下降
K3.1 Pro 已经在 kimi.com、Kimi App、Kimi Work、Kimi Code 和 Kimi API 上线。国内 API 型号为 kimi-k3.1-pro,普通版每百万 token 输入 13 元、缓存命中输入 1.3 元、输出 68 元;K3 对应价格分别是 20 元、2 元、100 元。算下来,输入和缓存命中都降了 35%,输出降了 32%;缓存写入也从 20 元降到 13 元。高速版 kimi-k3.1-pro-highspeed 的未缓存输入与输出价格为普通版 2 倍,缓存命中输入同为 1.3 元,官方标称输出速度约为 2~3 倍。
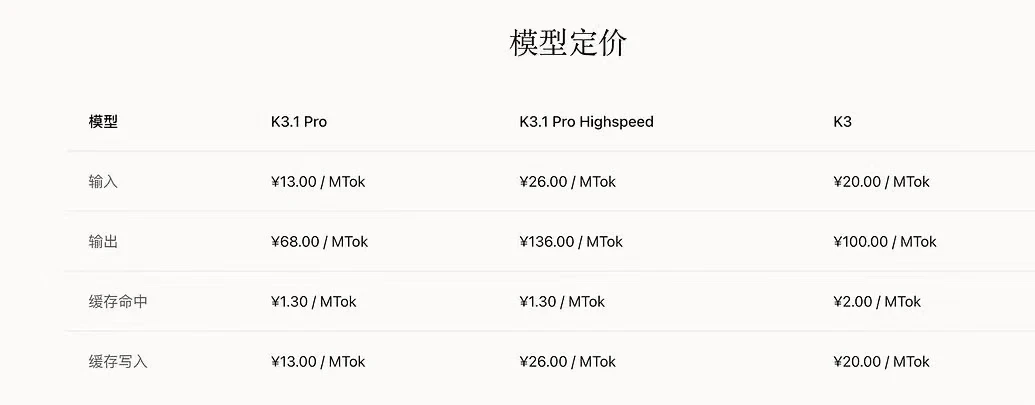
按 AA 使用的海外美元定价口径,K3.1 Pro 的输入、输出和缓存命中价格均比 K3 低 33%。但单价下降没有原样变成任务账单的下降:AA 测得 K3.1 Pro 在其 Intelligence Index 上每项任务平均输出 55K token,K3 为 48K,增加 14%;K3.1 Pro 的单任务成本约为 1.98 美元,与 K3 大体相当。
对开发者来说,这组数据比「降价三分之一」更接近真实选型。模型完成同类任务时需要多少输出、多少轮工具调用、多少次重试,都会影响最后的账单。每百万 token 的报价只是其中一项。
完整权重还没发布,安全边界先公布了
这次发布还有一项不太常见的披露:月之暗面明确讲了为开放权重版本削减网络攻防能力的过程。官方称,在中期训练和强化学习阶段都识别并移除了网络攻防相关数据,同时保留通用编程任务。
在内部 xdev-bench-hard 上,未做这些风险削减的检查点,pass@3 能解决 90.5% 的问题;最终版 K3.1 Pro 为 81.0%。这项测试没有严格超时或输出 token 上限。官方的解释是,他们不希望发布的开放权重把网络攻防能力推向绝对前沿,同时计划渐进式提升开放权重中的相关能力。
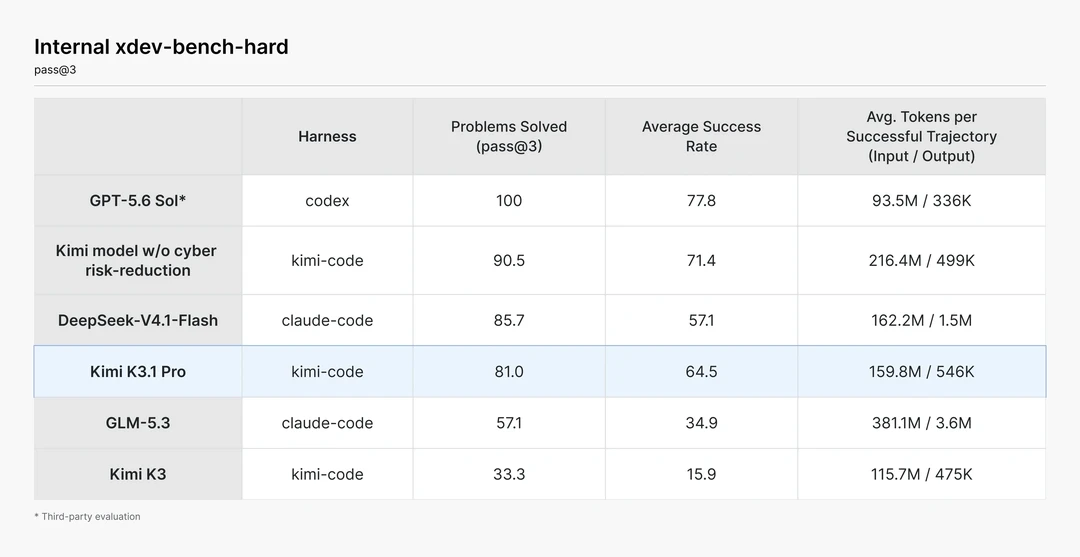
这让「开放权重」不再只是一个下载按钮,也包含发布方愿意把哪些能力交到用户手里的选择。AA 判断,K3.1 Pro 的权重发布后将成为其榜单上得分最高的开放权重模型,开放权重与闭源榜首的分差会从 12 分缩小到 3 分。注意,这仍是一个以权重落地为前提的判断;目前权重和许可证都还没有发布。
K3.1 Pro 是系列开头,后面看谁能接上
官方特意把 K3.1 Pro 称为 K3.1 系列的第一个模型。这个表述没有给出后续型号和时间,但为系列留下了明确的位置。这次先来的是 Pro,K3.1 系列的其他版本同样值得期待。
接下来还可以看 Qwen4 系列、GLM-5.5、MiniMax M3.1 Pro 和 DeepSeek 的新模型。MiniMax 官方已经明确说过 Pro 版后续会来,但没有给日期;Qwen4 系列、GLM-5.5 和 DeepSeek 新模型的具体配置与发布时间,也以官方正式消息为准,网传信息不适合当成发布计划。
在我们看,K3.1 Pro 的落地意味着国产旗舰模型重新进入发布节奏。接下来要看 K3.1 系列的其他版本,也要看 Qwen4 系列、GLM-5.5、M3.1 Pro 和 DeepSeek 的新模型能不能把这一轮节奏继续下去。
上一轮国产旗舰发布节奏的对账,可以读《国产模型「消失」的七周》。如果想弄清同一个模型为什么会在不同榜单拿到不同名次,《同一个模型,每个榜都说它第一》拆了四类常见评测方法,读本次发布稿的跑分表时也用得上。