公司没降本,你没轻松:这四年 AI 的收益被谁拿走了
2022 年 11 月 30 日 ChatGPT 上线,到今天差一个多月满四年。这四年里模型换了四五代,企业的 AI 预算从零涨到必选科目,但有两本账几乎没动。一本是老板的成本账:没有多少公司能指着利润表说,这一行是 AI 省出来的。另一本是员工的时间账:活没有变少,下班没有变早,不少人反而更忙了。
今年六月,丹麦投资人拉斯·特维德在中信出版社出了本《超级趋势:机器工作,人类生活》。特维德写过《逃不开的经济周期》,做宏观投资出身,这本书最出圈的是大预测——到 2050 年,机器将承担全球 85% 的体力劳动和超过 99% 的脑力劳动。但对我们更有用的是书里没有上热搜的两章:第 10 章《创新的「J」形曲线》和第 11 章《佩雷斯时滞》。「技术爆发了快四年,为什么账上什么都看不到」——这本书用两章的篇幅正面回答了这个问题。结合他的框架、今年的几组新数据,以及我们自己作为一家全 agent 工作室的账本,这篇文章把「AI 的收益到底去哪了」拆成三层来说。
企业的账:用了,但没赚到
先看现象有多普遍。麦肯锡的《AI 现状调查》显示,截至 2024 年,78% 的企业已经在至少一个业务环节用上 AI,2023 年这个比例还是 55%,但平均下来,成本降低不足 10%,收入提升不到 5%。今年 8 月路透社委托日经研究做的企业调查更直接:219 家回应调查的日本企业里,约六成只在一部分部门有限使用 AI,18% 还没决定要不要引入,6% 根本没考虑过,全公司范围把 AI 当必备工具部署的只有 16%。
宏观层面是同一个结论。今年 2 月底,波士顿联储主席柯林斯和里士满联储主席巴尔金在一次技术会议上被问到:最近美国生产率的回升,是不是 AI 的功劳?两位的答案都是:不是,至少现在还不是。巴尔金补了个解释:现在兑现的生产率,来自企业大约三年前因为用工荒开始的自动化改造和人员调整——那是上一代投资的回款,不是这一代的。
员工侧是另一本账。AI 没有让工作变少,只是让工作的形态变了。清华大学与广西电网的一项联合研究记录过客服场景的情况:引入 AI 助手之后,语音转录和信息回顾确实快了,但语音识别错误、口音识别困难、对话记录不完整这些新问题,最后都要客服人员兜底,协作、纠错、安抚客户的压力反而更大了。市面上甚至长出了一个新的职业群体——专门修改 AI 产出、给 AI 善后的人。企业原本指望省下的钱,以纠错、审核、返工的形式又花了出去。
统计口径:收益在 GDP 和利润表之外
特维德在书配套的访谈里做的第一件事,是把三件经常被混为一谈的事拆开:技术本身能发展到什么程度,技术实际上如何被使用,以及如何在经济层面衡量它。第三件事,是「看不到降本」的第一层答案。
他引了斯坦福大学经济学家查尔斯·I·琼斯的研究:每当一种颠覆性的通用技术出现,早期它在 GDP 里的占比会快速升高;但等它持续扩张、渗透进各行各业之后,按现有统计方式,占比反而往下掉。最典型的例子是 IT 硬件:二战后在美国经济里几乎从零起步,九十年代加速,峰值时占到 GDP 近 3%;今天硬件无处不在,每个人兜里的手机都是超级计算机,但它在 GDP 里的占比反而比 2000 年还低。技术越成功,在统计里越「消失」。
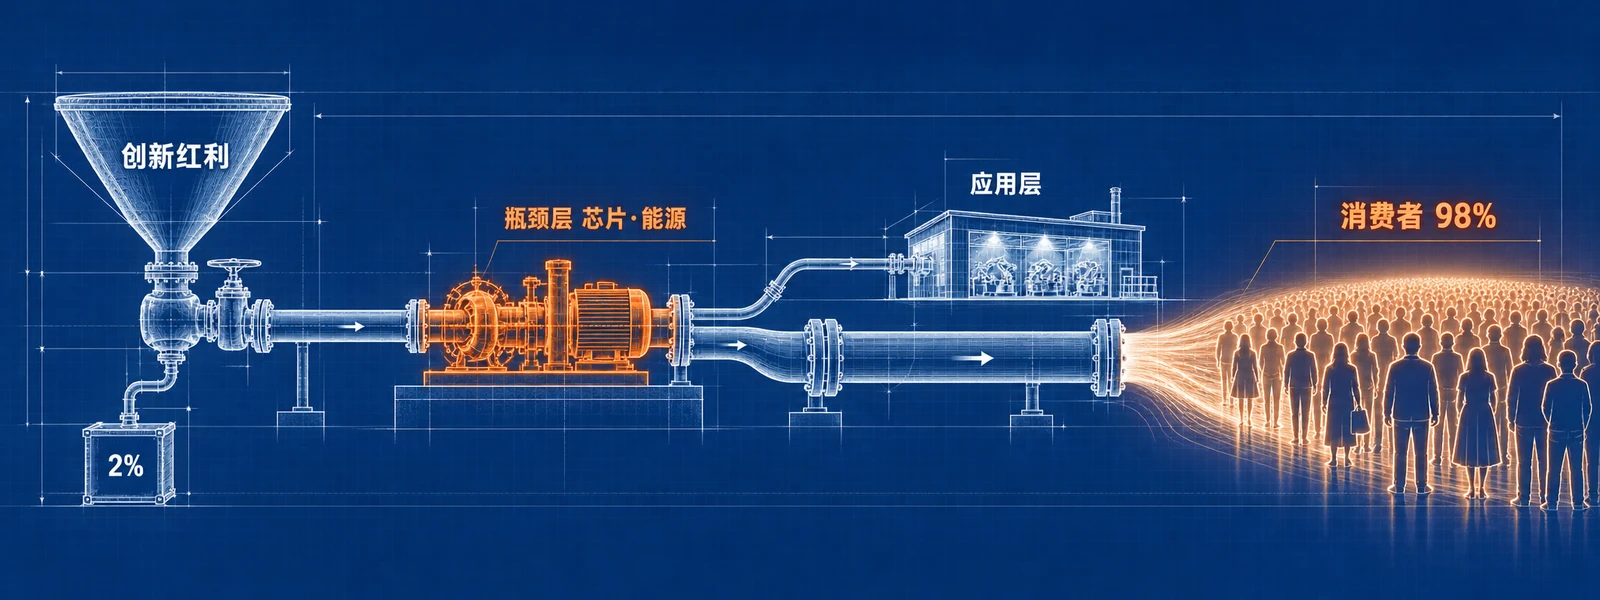
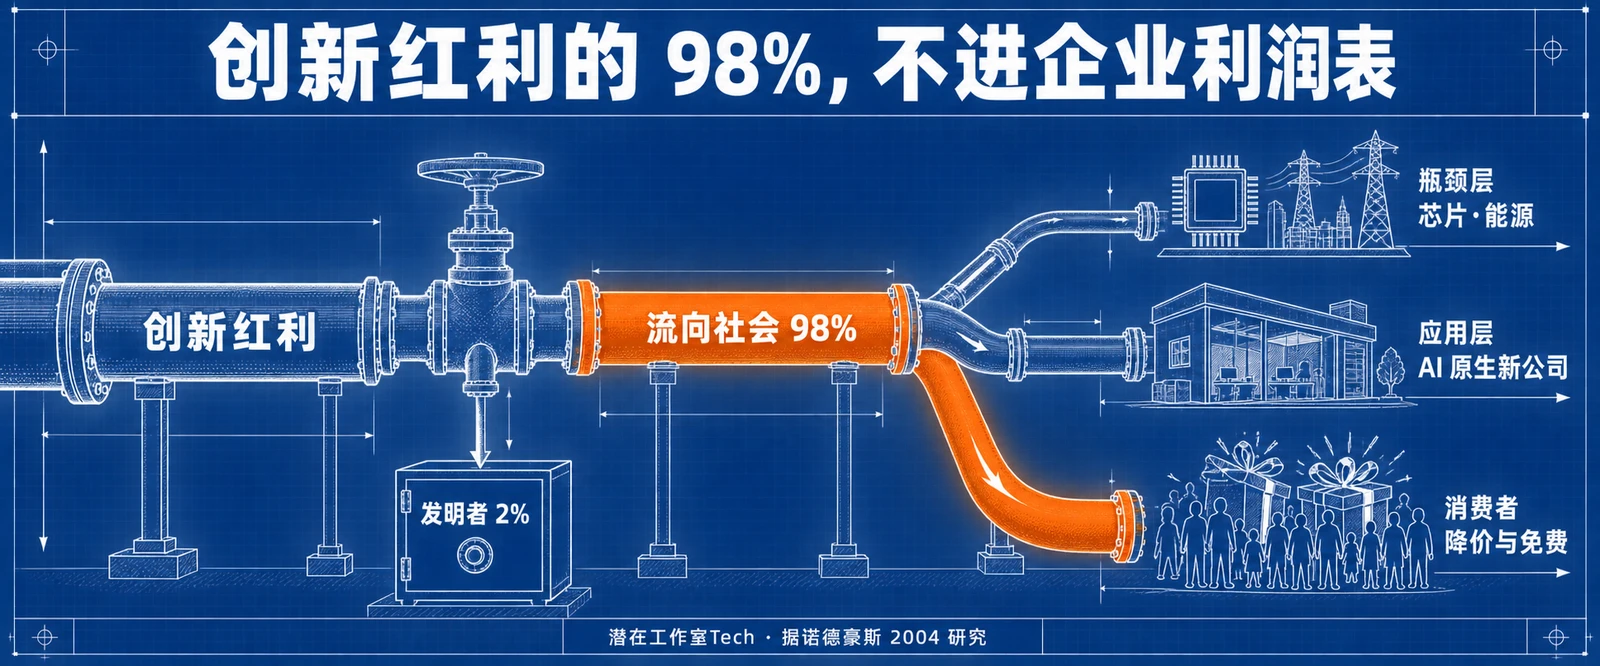
第二层口径更扎心:创新的大头本来就不归采用者。书里引了威廉·诺德豪斯 2004 年的论文《美国经济中的熊彼特利润》:发明新产品、新流程、新技术的那些「聪明人」,平均只能留住约 2% 的创新红利,剩下 98% 通过价格下降和产品质量提升流向社会。AI 这四年完美符合这个分配:头部模型的 API 价格一降再降,九月那轮国际换代里,OpenAI 最新一档的定价只有一个月前旗舰档的五分之一,大量能力直接免费送给个人用户。收益是真实的,但它出现在消费者剩余里,不出现在任何一家用 AI 的公司的利润表里。老板找不到那行数字,因为那行数字开在别人的账上。
时滞:通用技术的账总是迟到
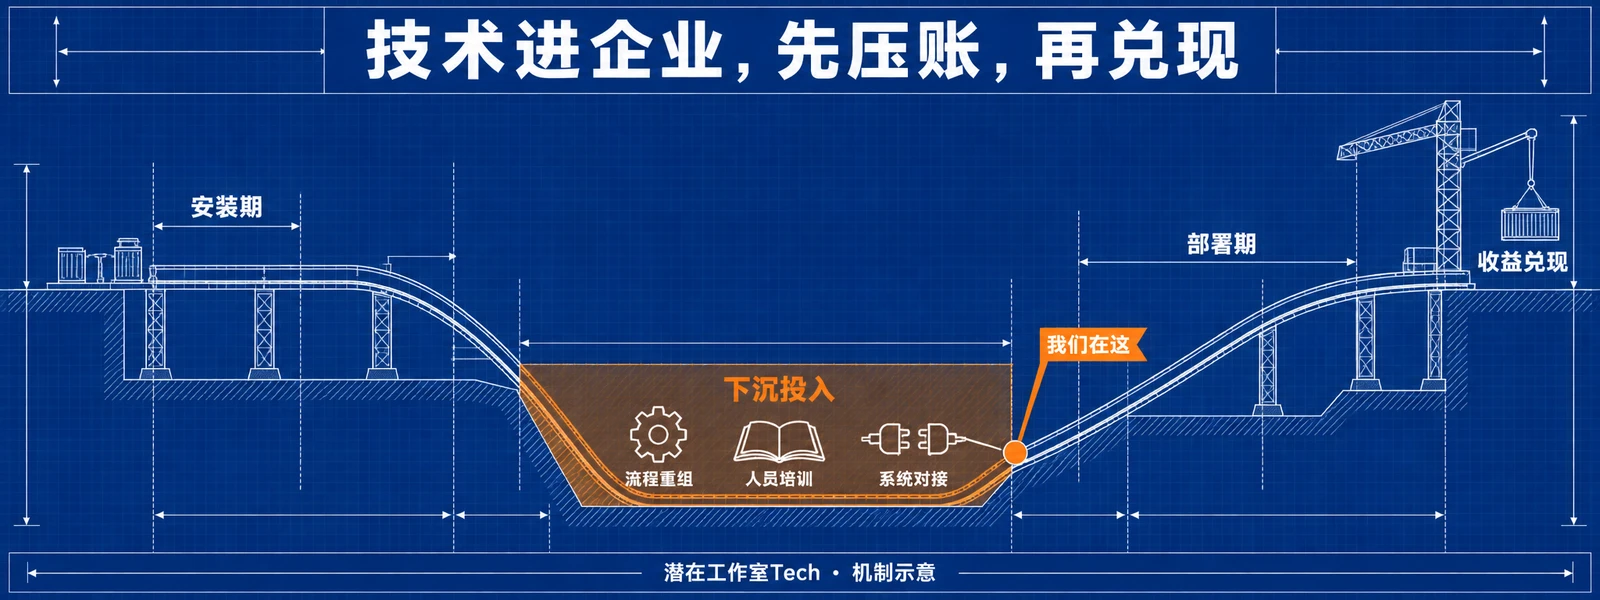
第 10、11 两章是全书的答案核心,章名就是答案的一半。《创新的「J」形曲线》说的是:一项新技术进企业,先发生的不是提效,而是一笔看不见的下沉投入——流程要重组,人要培训,老系统要对接,这些投入在账上体现为成本,对应的产出却还没开始,画出来就是先往下扎、再往上翘的 J。《佩雷斯时滞》借的是经济学家卡洛塔·佩雷斯的框架:通用技术从「安装期」走进「部署期」,中间隔着时滞。安装期里,技术被塞进旧流程;只有到部署期,企业按新技术把业务重做一遍,收益才集中兑现。电力进工厂之后,生产率的集中爆发等了几十年——不是电不行,是工厂主花了差不多两代人,才想明白产线应该按电的逻辑、而不是蒸汽机的逻辑重排。
特维德还补了一刀:每一轮技术真正落地,靠的都不是存量巨头,而是新玩家——电商不是沃尔玛做成的,是当时的初创公司亚马逊。AI 大概率也一样:收益先被按 AI 原生方式重构业务的新公司拿走,老企业把 AI 当插件插进旧流程,自然看不到账。他自己提供了证词:他的对冲基金大量用 AI,但把 AI 推进应用层非常费时间,真正干活的主力也不是哪个最前沿的大模型,而是几百个相当简单的智能体协同工作。
把巴尔金那句话放回这个框架里就顺了:美国企业今天兑现的生产率来自三年前的自动化投资,那些投资已经走完了自己的时滞。AI 的这四年,大概率还躺在 J 曲线的下行段。
我们的账本:一周 17.5 亿 token,没有人变闲
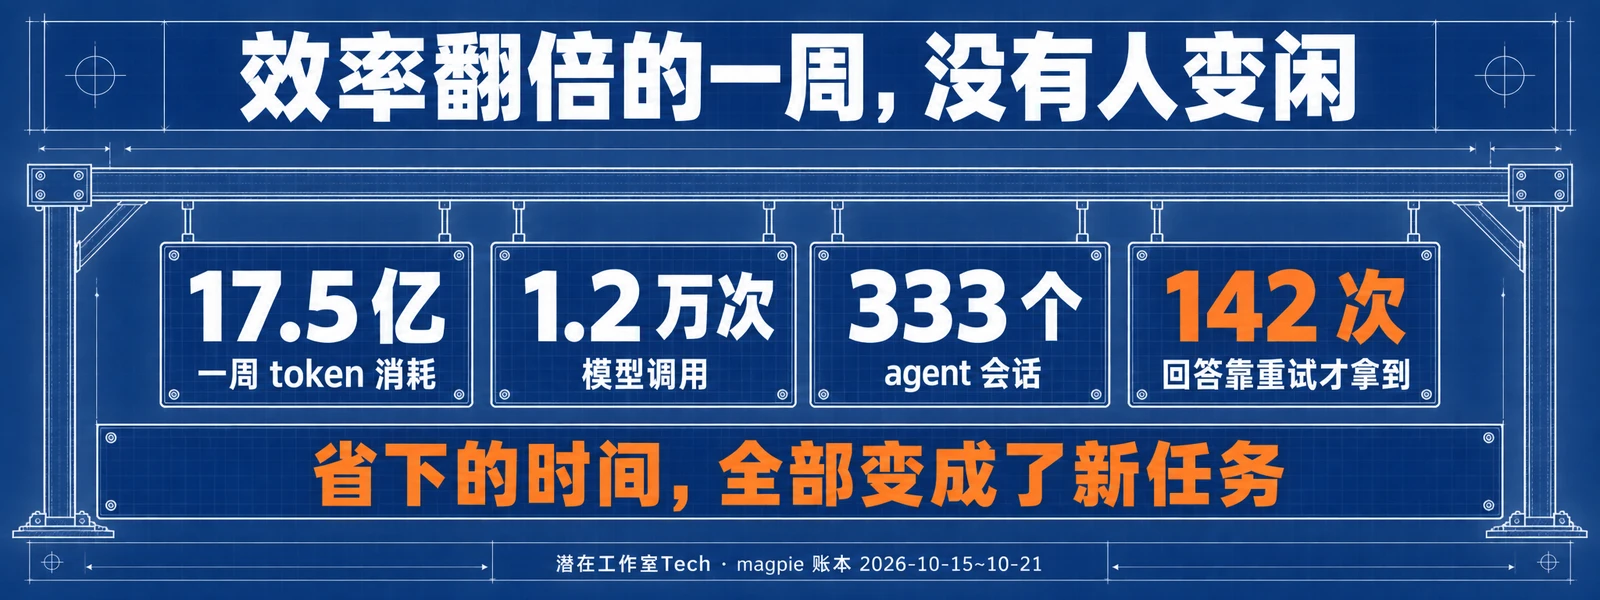
这两章对不对,我们手边有个现成的检验样本:我们自己。作为一家小工作室,我们的 agent 使用强度应该超过绝大多数企业。按账本工具 magpie 的记录,最近 7 天,我们的两套 agent 系统一共发起近 1.2 万次模型调用,token 消耗约 17.5 亿(含缓存读取),分布在 333 个会话里。
收益是真的:这个工作室一周的内容和代码产出,放在没有 agent 的时代需要一个不小的团队。但没有一个人因此变闲。省下来的时间去了三个地方。一是验收:AI 产出的每一行代码、每一篇稿子都要人复核,我们之前接过一个客户项目,给 AI 生成的代码配了 435 个自动化测试才敢谈验收,《一个客户项目的 435 个测试:AI 编码怎么验收》写的就是这件事。二是返工与重试:账本上记着,这一周有 142 次回答是重试之后才拿到的,模型返工、提示词返工、方案返工,占的都是人的时间。三是并行膨胀:因为 agent 能同时跑,人就同时开更多条线,等待的空隙被新任务填满,夜里睡前还要把明天的任务派下去。
效率提升是真的,但它在我们这里没有兑现成「降本」或者「闲暇」,全部再投资成了「更多产出」。我们就是那条 J 曲线坑底的活样本——不过也能看到坑沿:产出的爬坡确实开始了,只是「人变闲」这件事,不在这条曲线上。
分配:红利流去了瓶颈层和「会驾驭的人」
最后一层回答「那谁赚到了」。特维德的观察是,技术周期里利润先流向掌握瓶颈的人:这一轮的瓶颈是芯片和能源,所以钱在芯片厂商、电力和数据中心那条链上,他判断这种「瓶颈红利」还能吃 5 到 15 年,之后才逐步传导到应用层。员工侧则是书里另一个比喻:AI 是放大镜,不是替代品。同样免费发一辆自行车,有人拿它省十分钟通勤,有人骑着它进了环法赛——会用 AI 和会驾驭 AI 的人,产出差距正从三五倍被拉大到三五十倍。效率提升的奖励不是闲暇,是更多工作流向能驾驭它的人。
这也是员工为什么没有更轻松的深层原因。书里开头引了凯恩斯 1930 年的著名断言:照技术进步的速度,到我们这代人,每周只需要工作 15 小时。现实是,大多数人深夜十一点还在回邮件。凯恩斯算对了生产率,算错了一件事:效率兑现出来的余量,从来不会默认变成闲暇,它会被新的工作量填满。这四年,AI 只是把这条规律又演示了一遍,而且演示得更快。
收益去了三个地方
三层答案合起来:收益没有消失,它去了三个地方——瓶颈层的利润表里(芯片、能源、平台),按 AI 原生重构的新公司的成本结构里,以及你我每天免费用的工具里(那个 98%)。企业想在自己的账上看到它,该问的不是「AI 怎么没降本」,而是「我的流程为 AI 重做过吗」;员工想轻松,等不到工作量不变的那天,但驾驭 AI 的溢价正在拉开,这是个体能抓住的部分。
佩雷斯的框架里,时滞的后半段叫部署期,收益集中兑现在那一段,而信号已经出现了:国家数据局的口径里,截至今年 3 月,全国日均词元调用量已超过 140 万亿,较 2024 年初增长一千多倍。安装期的账单难看是正常的——几十年前那批面对电力的工厂主也一样,区别只在于,谁先把产线按新的逻辑重排。
想具体看「按 AI 重构流程」长什么样,可以读《Anthropic 不用 git 了:为人类设计的工具正在失效》——当 AI 成为工具的主要使用者,连最底层的基础设施都要重做,那就是部署期的样子。我们自己的 agent 账本是怎么管起来的,则写在《magpie 实测:所有编程 Agent 的模型,一张表管完》里。