10 月 26 日,两件事在同一天发生。凌晨,OpenAI 发布 GPT-6.1 Terra,每百万 token 输入 1 美元、输出 5 美元,比上一代再砍一半,主打 computer use 和速度。中午,Kimi 官方为 K3.1 Pro 订阅计划的限流和异常配额消耗道歉,给所有订阅用户恢复四分之一的月度配额。一边是新刀出鞘,一边是罪己之书。
这一天几乎浓缩了此前的整整五周:对面在按周落子,这边的一次大冲锋,落在了一个不稳的落点上。「国产模型明显跟不上节奏了」,这个十月末的体感值得认真对待。跟不上的到底是什么,没跟上的又有什么,这篇把账摊开算。
恶龙的五周
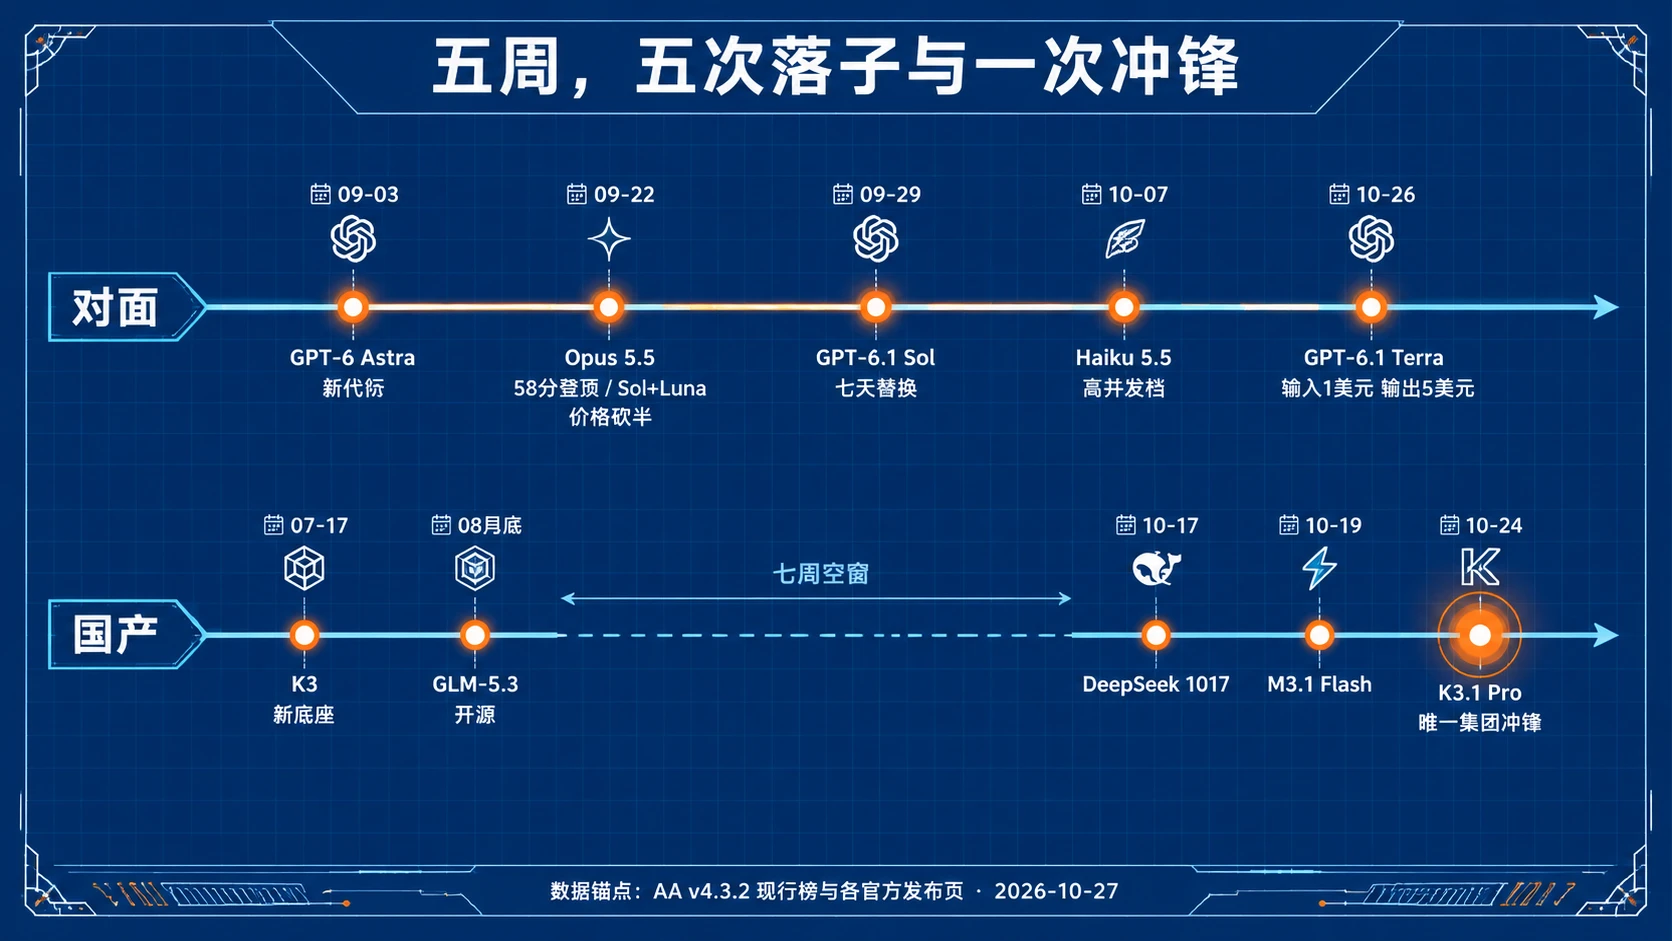
从 9 月 22 日算起,五周,Anthropic 和 OpenAI 发了五款模型。
Anthropic 三周三档。9 月 22 日 Opus 5.5,AA 榜 58 分登顶,官方口径典型负载成本比上代降 40%。六天后 Sonnet 5.5 接上,定位日常任务的速度档。再过九天 Haiku 5.5 补齐高并发档,同一天把 Sonnet 5.5 的缓存读价格砍半。一次换代,旗舰、主力、廉价各就各位,价格联动。
OpenAI 把价格阶梯铺完了。9 月 3 日 GPT-6 Astra 立起新代际;9 月 22 日 Sol 和 Luna 两档同发,API 价格砍半;9 月 29 日 GPT-6.1 Sol 上线,AA 的文章标题就是「上线 7 天即替换 GPT-6 Sol」,能力接近 Astra,单任务成本约 0.72 美元,不到 Astra 的四分之一;10 月 26 日 Terra 收尾,输入 1 美元、输出 5 美元。五周之内,从 10/50 到 2/10 到 1/5 再到 0.10/0.50,从旗舰到廉价的每一级台阶都站了人。
这只恶龙不只有宝库,还有纪律。Claude Code 在 29 天里发了 26 个版本,每个新模型上架当天工具端就能用。Anthropic 在发布页里主动写明「到了这个能力水平,benchmark 分差已经不能可靠反映真实差距」,发布前请 METR 做评估,结论是增量改进而非跳变。强,且不骄狂,把预期管理做在别人开口之前。
十月,只剩一次冲锋
国产阵营也有过旗最直的时候。7 月 17 日,Kimi K3 发布,官方口径全球首个 3T 级开放权重模型。8 月上旬,DeepSeek 和阿里各出一款;8 月底,智谱开源 GLM-5.3。然后是七周无声,这段我们《国产模型「消失」的七周》专门对过账。十月回温,四款动作,K3.1 Pro、DeepSeek V4.1-Flash-1017、MiniMax M3.1 Flash、蚂蚁 Ling 3.1 Flash,全部是既有底座上的衍生版本,没有一款官宣新架构。
落到 AA 现行榜上,节奏的差距变成了阵形的缺口:52 分以上的头部带,海外模型占着十来个席位,国产只有 K3.1 Pro 一个孤点;47 到 51 分这一档,国产完全空着;43 到 46 分挤着大部队,MiMo、DeepSeek 1017、Qwen3.8 Max、GLM-5.3、Step 5、M3.1 Flash。对面是连绵的营盘,这边是一支孤军,身后隔着一段没人站立的空档。
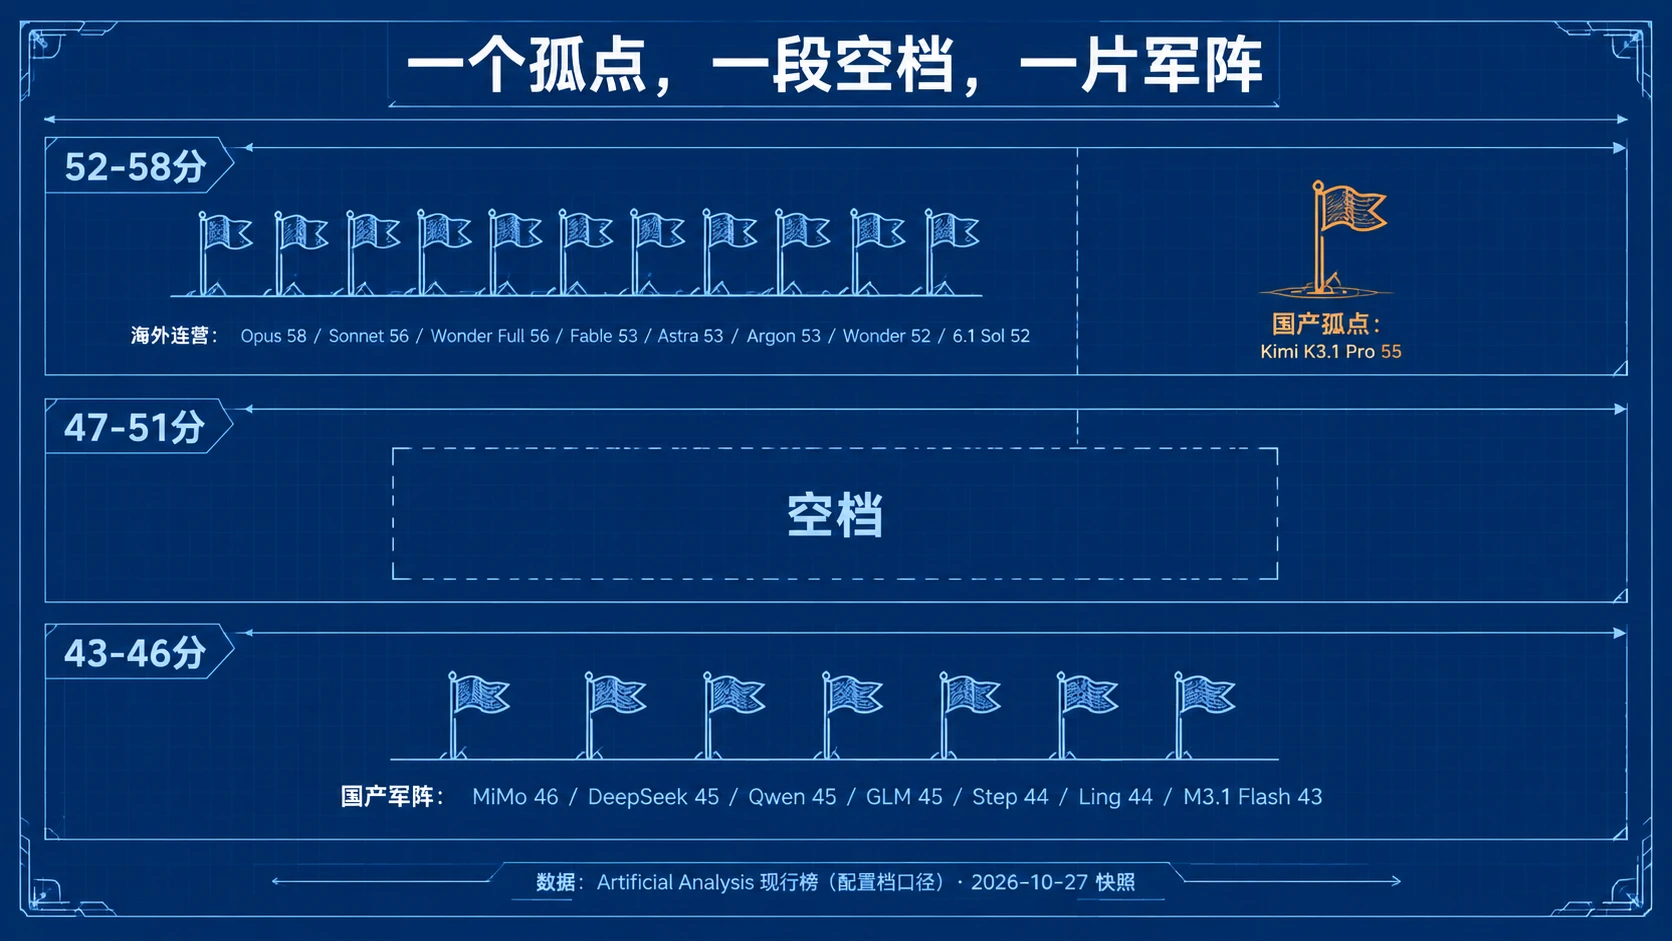
于是 10 月 24 日凌晨的 K3.1 Pro,就成了这五周里国产唯一的一次集团冲锋。
55 分没能赢
冲锋的成绩单其实不差。55 分,总榜第 5,高于同榜的 GPT-6 Astra 和 Gemini 4 Argon(各 53 分)。一个建立在七月底座上的后训练版本,综合分压过海外两个新预训练旗舰,这本身是件了不起的事。
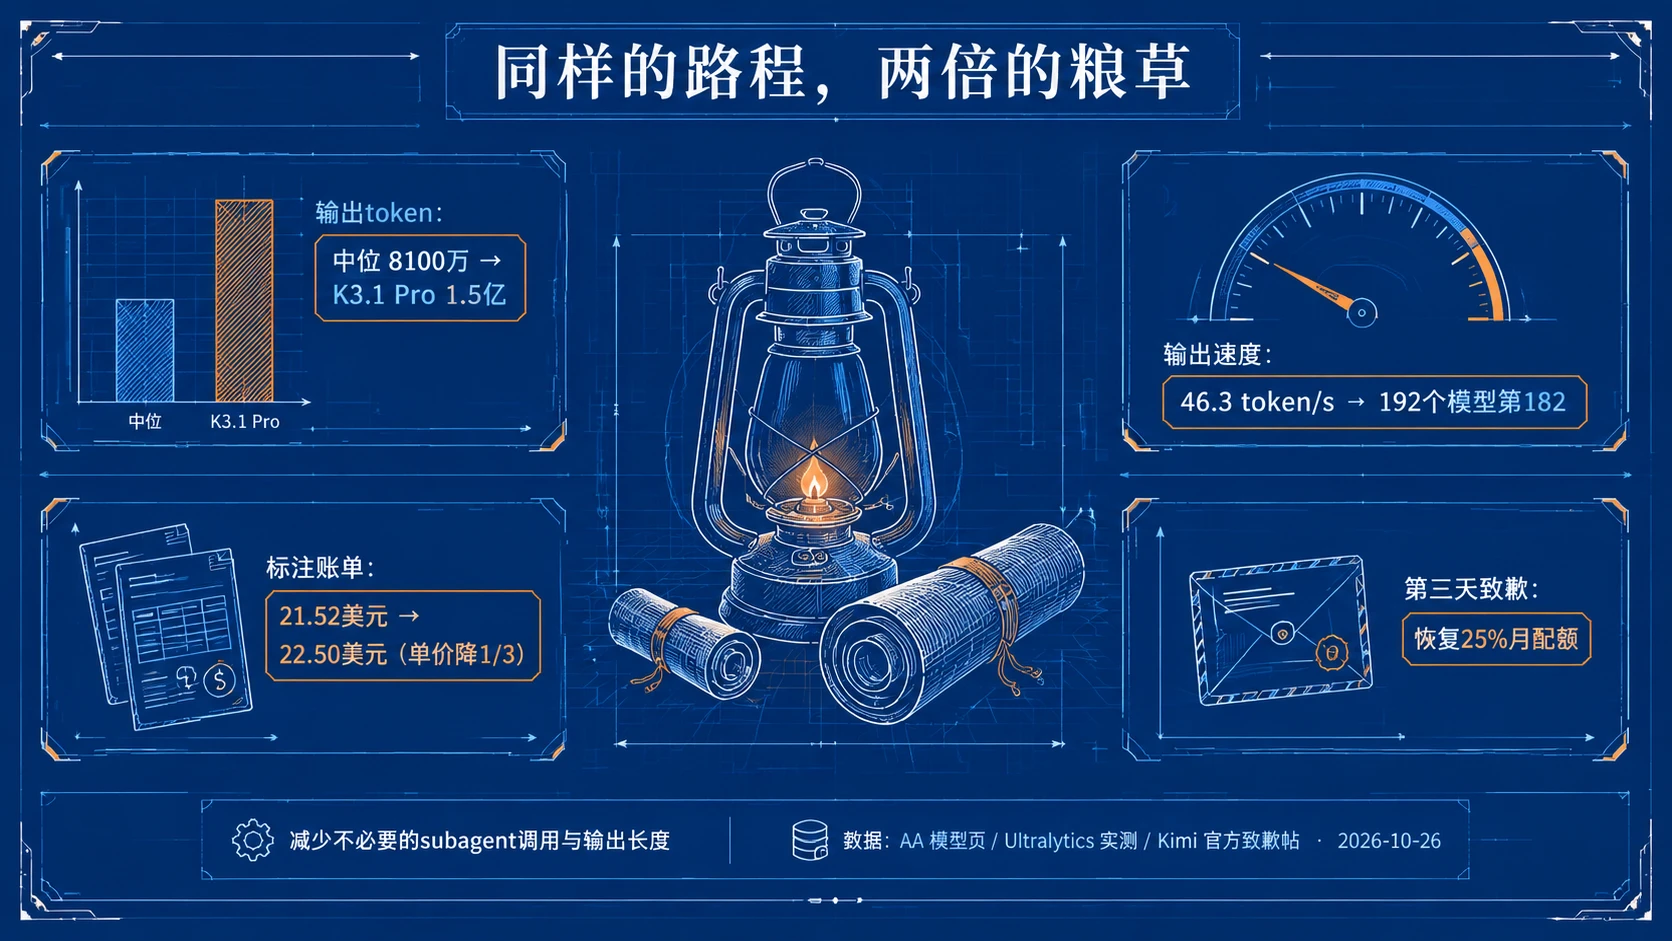
但用户上手之后,账就不是这么算的。Vals AI 用统一 harness 实测,K3.1 Pro 对自家前代退了步:法律检索 46.15% 降到 37.50%,税务代理 33.37% 降到 24.87%。同样是 Vals 的榜,目标明确的终端任务它 63.64% 排第 3,只差 Claude Opus 5.5 一点五个百分点;换成没有现成解法的科研任务,31.43% 排第 8,GPT-6 Astra 是 62.86%。AA 的模型页评语只有一句:明显偏慢,特别话痨。输出速度 46.3 token 每秒,192 个模型里排第 182。
强项符合预期,弱项低于预期,总分把锯齿抹平了。用户是按最低的那块板体验产品的,落差就从这里来。
第三天的道歉信
最能说明问题的是一个数字。跑完同一套 AA 评测,中位模型输出 8100 万 token,K3.1 Pro 输出 1.5 亿。同样的路程,两倍的粮草。Ultralytics 拿它做真实标注任务,token 单价降了三分之一,1000 张图的账单反而从 21.52 美元涨到 22.50 美元。思考无法关闭,默认就是最高的 max 档。
于是就有了 10 月 26 日那封信。Kimi 官方为限流和「不必要的配额消耗」道歉,原话承认「这些是我们的问题,本应更早修复」,调整参数,原文写的是「减少不必要的 subagent 调用和输出长度」。把信和第三方数据放在一起,结论并不难下:官方说的异常消耗,就是 AA 测到的啰嗦,就是 Ultralytics 测到的账单。模型拼尽全力完成任务的样子,是燃烧自己。
同一件事,三种讲法。DeepSeek 更新 1017 版,把「缩短任务运行时间和输出长度」写进更新日志当成果。Anthropic 发布 Opus 5.5,把 token 效率当卖点讲。Kimi 把它写进了道歉信。宣发侧还添了一道伤口:「上单」的指控截图流传了两天,那是单一信源,至今无人佐证,本文不把它当结论,但发布周仅剩的话题位,确实也给了风波。
为什么扎堆后训练
为什么这五周只剩一次冲锋,而且是一次借力的冲锋?一笔账能算清。
小米公开过 RL 训练账单:MiMo-V2.6-Pro 三十个 RL step、约 75 万次 rollout,262 万美元。这个量级,头部厂商都掏得起,见效又快,分数直接写在榜上。而新预训练拼的是算力总量,IFP 十月的估算,美国前五家实验室约为中国前五的十倍以上。便宜的武器人人拿得起,昂贵的战场进不去。衍生版扎堆、底座断档,是这个约束下的均衡,不是哪家不努力。
这不是勇者不够勇敢,是恶龙的宝库深了十倍。悲情的真正来源在这里:K3.1 拼到了 55 分,拼的方式是双倍的 token、透支的后训练,而对面连降价都还没有降完。
五丈原不是终点
但十月还不是五丈原。五丈原之所以是悲剧,恰恰不在于打了败仗,那一仗没有输——在于灯油烧尽在半途。K3.1 也一样:分数没有输给任何人,输掉的是节奏里的时间。
而且蜀汉在五丈原之后还打了二十九年。国产阵营的军阵仍在:成本线上,MiMo-V2.6-Pro 46 分每任务 0.13 美元,DeepSeek 1017 45 分 0.26 美元,榜首 Opus 5.5 是 5.98 美元,差着二十到四十倍。DeepSeek 已经在学对面的打法,1017 版一周内从 39 分重测到 45 分,同时把缩短输出、适配编程工具写进发布说明,一次更新同时讲能力、成本和效率。这正是恶龙的节奏,学得会。
往后盯两个信号就够了:谁先拿出下一个新底座,谁先把 47 到 51 分的空档填上。任何一个出现,都说明这支军队重新上路了。在那之前,总分再涨,也只是又一次双倍粮草的冲锋。
秋风还在吹。旗没有倒,只是举旗的人,需要换一副新的臂力。
三个月旗舰空窗的逐日对账,见《国产模型「消失」的七周》;K3.1 Pro 发布当天的跑分与 Agent 增量拆解,见《Kimi K3.1 Pro 发布:提升的大头在 Agent》。