数据取 Artificial Analysis 智能指数 v4.3.2(10 项评测加权,187 款模型 268 个配置档在榜),抓取于 2026-10-17。榜单按配置档计名次,同一模型多档位(max/xhigh/high/medium/low)各占一名;单任务成本为最高推理档位每任务价格。
总榜前 50
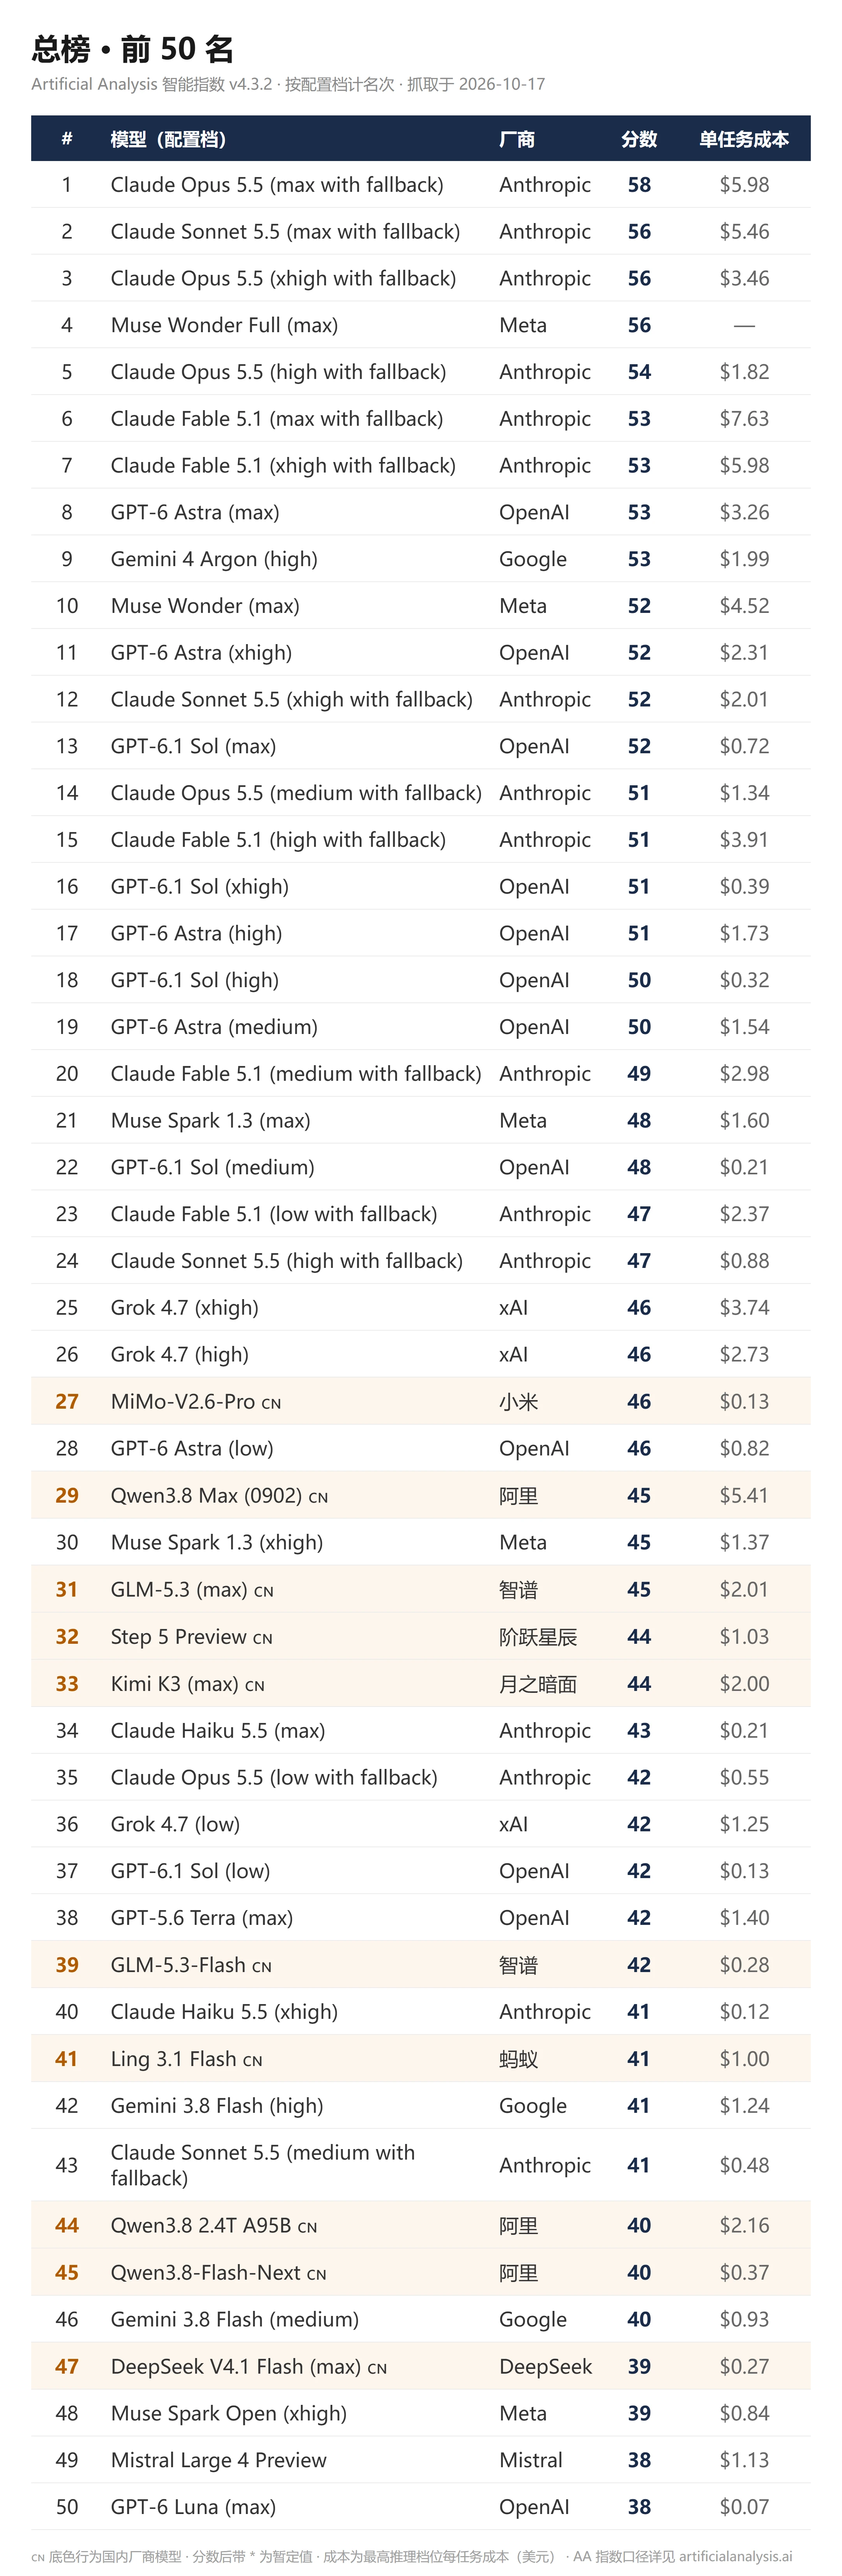
前三名的座次和上周一模一样:Claude Opus 5.5(58)、Sonnet 5.5(56)、Opus 5.5 xhigh(56),Anthropic 包圆。变的是第四名:Meta 的 Muse Wonder Full 以 56 分空降,和第二、三名同分。上周 Meta 在榜上最高的模型还是 48 分的 Muse Spark 1.3,排在二十名开外。52 分以上的高分俱乐部按模型去重从六家扩到八家,新进来的两家都叫 Muse。
国内段:天花板没动,门口更挤了
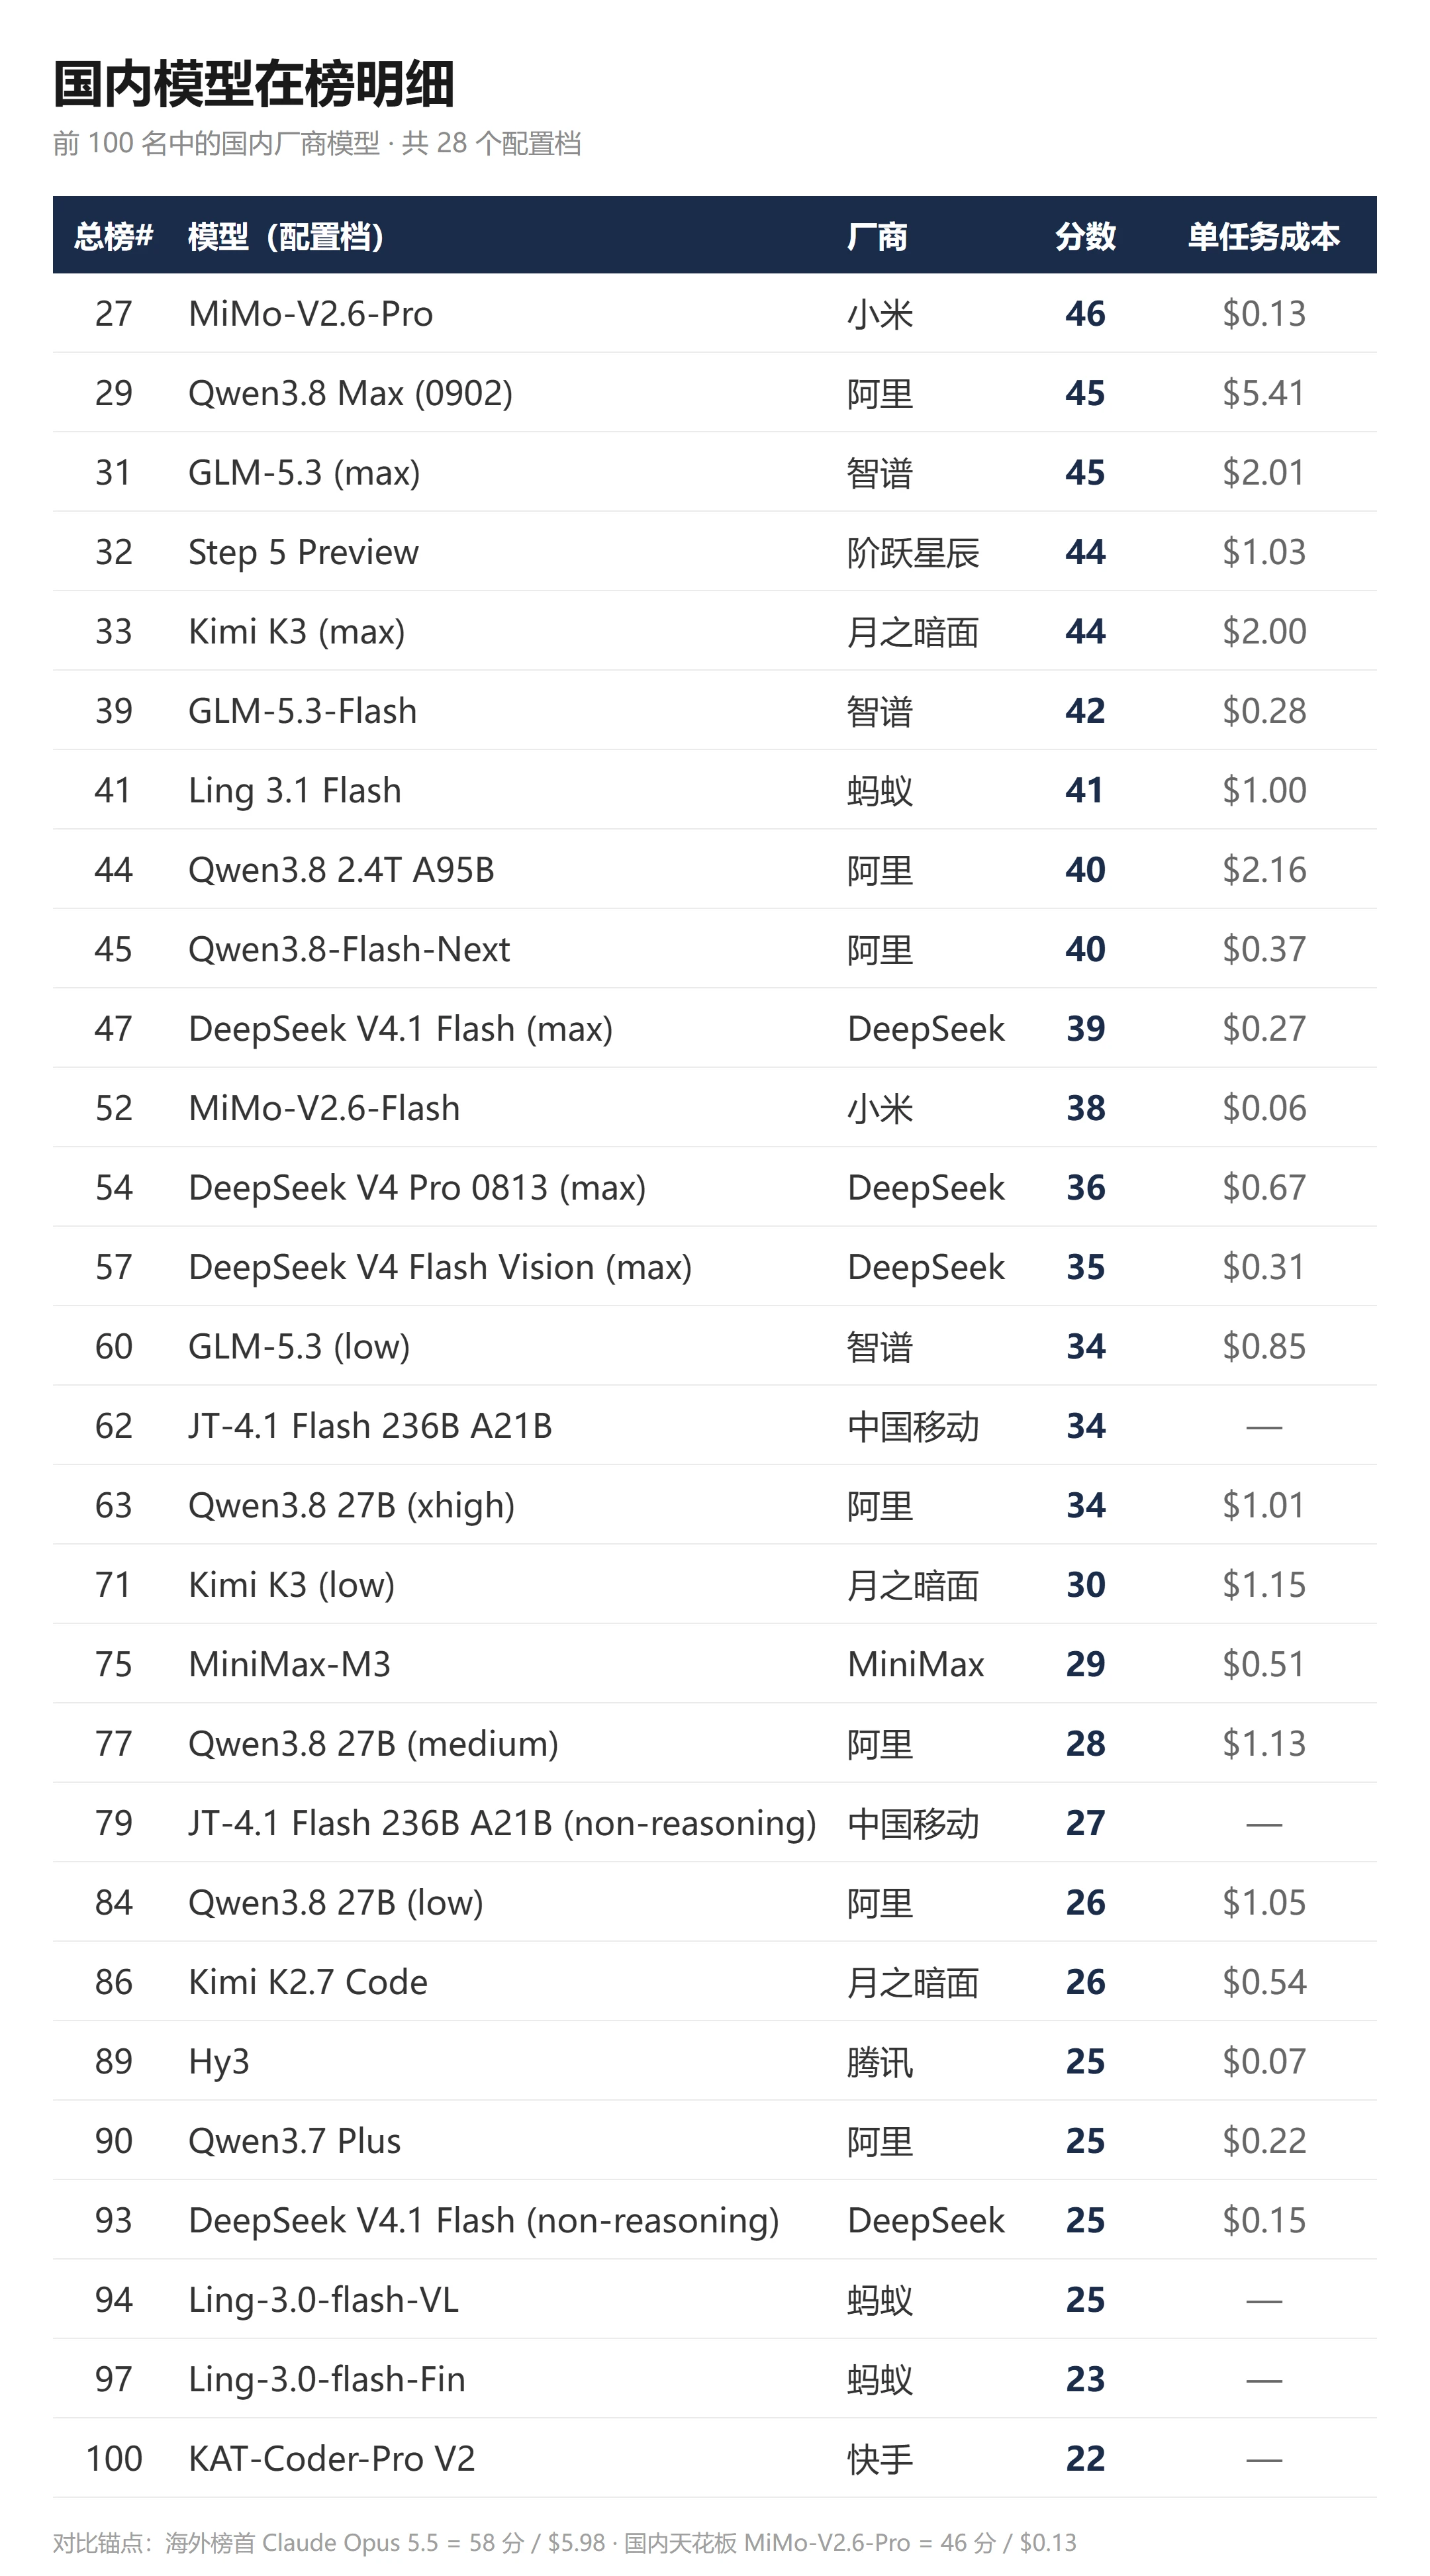
国内模型本期在榜 22 款、28 个配置档(上周 24 款 30 档,阿里的 Qwen3.5 397B 和 Qwen3.5 Omni Plus 两个非推理档被挤出前 100),按去重名次分布:
- 46 分档(第 27 名):MiMo-V2.6-Pro,分数没变,名次从 25 退到 27——不是它退了,是前面插进了新模型;
- 44-45 分档:Qwen3.8 Max(45)、GLM-5.3(45)、Step 5 Preview(44)、Kimi K3(44),四家的分数全部原地不动,名次整体后移两位;
- 39-42 分档:GLM-5.3-Flash(42)、Ling 3.1 Flash(41)、Qwen3.8 2.4T(40)、Qwen3.8-Flash-Next(40)、DeepSeek V4.1 Flash(39);
- 38 分以下:MiMo-V2.6-Flash(38)、DeepSeek V4 Pro(36)、DeepSeek V4 Flash Vision(35)、中国移动 JT-4.1 Flash(34)、Qwen3.8 27B(34)、MiniMax-M3(29)、Kimi K2.7 Code(26)、腾讯 Hy3(25)等。
国内阵营这一周在 AA 榜上安静得反常:零分数变化、零新进、零发布,所有名次变化都是被动挨打。不过今天(10 月 17 日)有个变量:DeepSeek 更新了 V4.1 Flash(升级到 1017 版),API 名称和价格都不变,官方口径是「性能-费用的帕累托改进」——Terminal-Bench 4.0 从 31.2 涨到 42.3,ProgramBench 从 20.3 涨到 29.1,同时任务运行时间更短。我们抓取榜单时它还没被 AA 重新评测,榜上 39 分仍是旧版成绩,下周见分晓。上周我们说海外的 Haiku 5.5(43 分/$0.21)插进了 GLM-5.3-Flash 的价格带,本周下山卡位的故事升级了:Meta 开源的 Muse Spark Open 拿 39 分,和 DeepSeek V4.1 Flash 同分,8160 亿总参数、100 万 token 上下文、权重开放下载。同分段里国内模型第一次遇到一个不要钱就能搬走的对手——价格断层守得住成本优势,守不住「免费」两个字。
本周变动:Meta 一周三箭
这是本栏目第一次有上周快照可比的「本周变动」。前 100 名里新进 6 款、跌出 6 款,真实分数变化只有一处:Solar Pro 4 从 28 掉到 27,名次跌了 9 位,是本期跌幅最大的模型。
新进的 6 款里三款来自 Meta:Muse Wonder Full(56 分,第 4)、Muse Wonder(52 分,第 10)、Muse Spark Open(39 分,第 48)。时间线拉出来是这样的:10 月 13 日 Meta 超级智能实验室发布建室一年多的首批前沿模型 Muse Wonder 双模型;10 月 15 日又开源 Muse Spark Open,vLLM、SGLang 当天就给了 Day-0 支持,Arena 的 Code Arena 榜单上它已经是美国开源模型第一。一周之内,Meta 在闭源前沿和开源权重两条线上同时开火,而上周它在 AA 榜的存在感还约等于零。
另外三款新进:Sapiens AI 的 Agnes 2.5 Pro Beta(35 分)、Reflection 的 Beam 1.0(30 分,美国开源权重第二)、NVIDIA 的 Nemotron 3.5 Super VL(26 分)。跌出前 100 的六款全部是从榜尾被挤出去的,包括 OpenAI 的两个低档配置和阿里上周还在榜的两款 Qwen3.5。
榜上的分数,我们七天的账本
分数是上限,实际用谁是另一本账。我们自用的模型网关 magpie(上期刚写过开箱)记下了过去七天的每一次调用:一万多次,合计 11.3 亿 token。
模型分布和榜单名次对照着看很有意思:用得最多的三款全是国产——MiniMax Flash 预览版占 42%(4434 次,首 token 延迟 3.7 秒)、GLM-5.3 占 30%(榜上 45 分,第 31 名)、Kimi K3 占 26%(榜上 44 分,第 33 名)。而榜上 58 分的榜首 Opus 5.5,我们七天只调了 192 次,走的是 Claude Code 直连——重型任务才请得动它。44-45 分档配三秒级的响应速度,才是日常干活的甜点区。
还有个趋势:三十天口径里 GLM-5.3 占 46% 是绝对主力,这七天 MiniMax Flash 以 42% 反超,GLM 降到 30%。榜单上 GLM-5.3 比 MiniMax 高 16 分,但 GLM 的首 token 延迟 15.3 秒、MiniMax 只有 3.7 秒——分数差 16 分、速度快四倍,活往哪边流,延迟表比分数表更有发言权。榜单告诉我们山顶在哪,账本告诉我们每天实际爬的是哪座山。